실험 결과 - youneedpython/melting-tank-lstm-baseline GitHub Wiki
이 쪽은 Notebook 출력에 남아 있는 평가 결과와 그 수치를 읽는 법을 정리합니다. 2026-10-06 문서 정리 때 Notebook을 다시 실행하지는 않았습니다.
학습
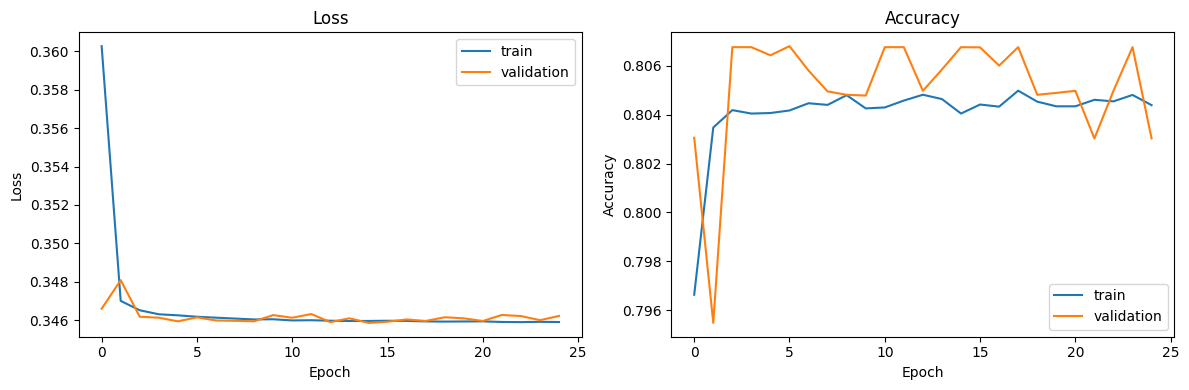
- 25 Epoch에서 EarlyStopping으로 멈췄고, 가장 좋은 Epoch는 15입니다.
- Loss는 2 Epoch 안에 0.346 부근으로 내려간 뒤 거의 변하지 않습니다.
- Validation Accuracy는 0.807에서 더 오르지 않았습니다.
Test 평가
Test 250,550건, Threshold 0.5, 양성 Class는 OK입니다.
| 지표 | 값 |
|---|---|
| Precision | 0.9961 |
| Recall | 0.8057 |
| Accuracy | 0.8049 |
| F1-score | 0.8909 |
| 실제 \ 예측 | NG | OK | 합 |
|---|---|---|---|
| NG | 2,155 | 785 | 2,940 |
| OK | 48,099 | 199,511 | 247,610 |
수치를 읽는 법
Accuracy 0.805는 아무것도 하지 않는 것보다 낮습니다. Test의 98.8%가 OK입니다. 전부 OK라고 예측하면 Accuracy가 0.988입니다.
Precision 0.996은 모델의 능력이 아니라 Class 비율입니다. OK가 98.8%인 데이터에서는 무엇을 OK라고 해도 대부분 맞습니다.
NG를 기준으로 다시 계산하면 이렇습니다.
| NG 기준 지표 | 계산 | 값 |
|---|---|---|
| Recall | 2,155 / 2,940 | 0.733 |
| Precision | 2,155 / 50,254 | 0.043 |
실제 NG의 73%를 찾지만, NG라고 한 것 중 실제 NG는 4.3%입니다. 정상 제품 48,099건을 불량으로 판정했습니다.
전체 데이터로 다시 평가
Inference-lstm-ver1.0.ipynb에서 저장한 모델을 불러와 전체 835,191건을 다시 예측했습니다. 학습에 쓴 기간이 포함되어 있습니다.
| 항목 | 값 |
|---|---|
| ROC AUC (OK 기준) | 0.433 |
| ROC AUC (확률을 뒤집었을 때) | 0.567 |
| 출력 확률의 분포 | 최소 0.427, 중앙값 0.764, 최대 1.000 |
| F1이 가장 높은 Threshold (OK 기준) | 0.00 (F1 0.881) |
| F1이 가장 높은 Threshold (NG 기준) | 0.01 (F1 0.351) |
Threshold 0.9에서의 판정 결과(위 오른쪽 그림):
| 실제 \ 예측 | NG | OK |
|---|---|---|
| NG | 148,318 | 28,749 |
| OK | 519,835 | 138,289 |
수치를 읽는 법
AUC 0.433은 무작위(0.5)보다 낮습니다. 확률을 뒤집어도 0.567입니다. 어느 방향으로 읽든 이 모델은 정상과 불량을 거의 구분하지 못합니다.
의미 있는 Threshold가 없습니다. F1이 가장 높은 지점이 0.00이라는 것은 "전부 OK라고 하는 것"이 가장 좋다는 뜻입니다.
Test와 전체 데이터에서 방향이 다르게 보입니다. Test에서는 OK의 81%가 0.5 이상을 받았는데, 전체 데이터에서는 AUC가 0.5 아래입니다. 학습 기간(NG 30%)과 Test 기간(NG 1.2%)의 구성이 크게 달라, 한쪽 결과만으로 모델을 판단할 수 없습니다.
이전 실행과의 차이
Baseline-lstm.ipynb는 같은 구성의 이전 실행 기록입니다. TensorFlow Seed를 고정하지 않아 수치가 조금 다릅니다.
| 실행 | 멈춘 Epoch | Accuracy | F1-score |
|---|---|---|---|
Baseline-lstm.ipynb |
34 (가장 좋은 Epoch 24) | 0.8054 | 0.8912 |
Baseline-lstm-ver1.0.ipynb |
25 (가장 좋은 Epoch 15) | 0.8049 | 0.8909 |