데이터와 모델 - youneedpython/melting-tank-lstm-baseline GitHub Wiki
이 쪽은 데이터가 모델 입력이 되기까지의 순서와 학습 설정을 정리합니다. 원본은 Baseline-lstm-ver1.0.ipynb입니다.
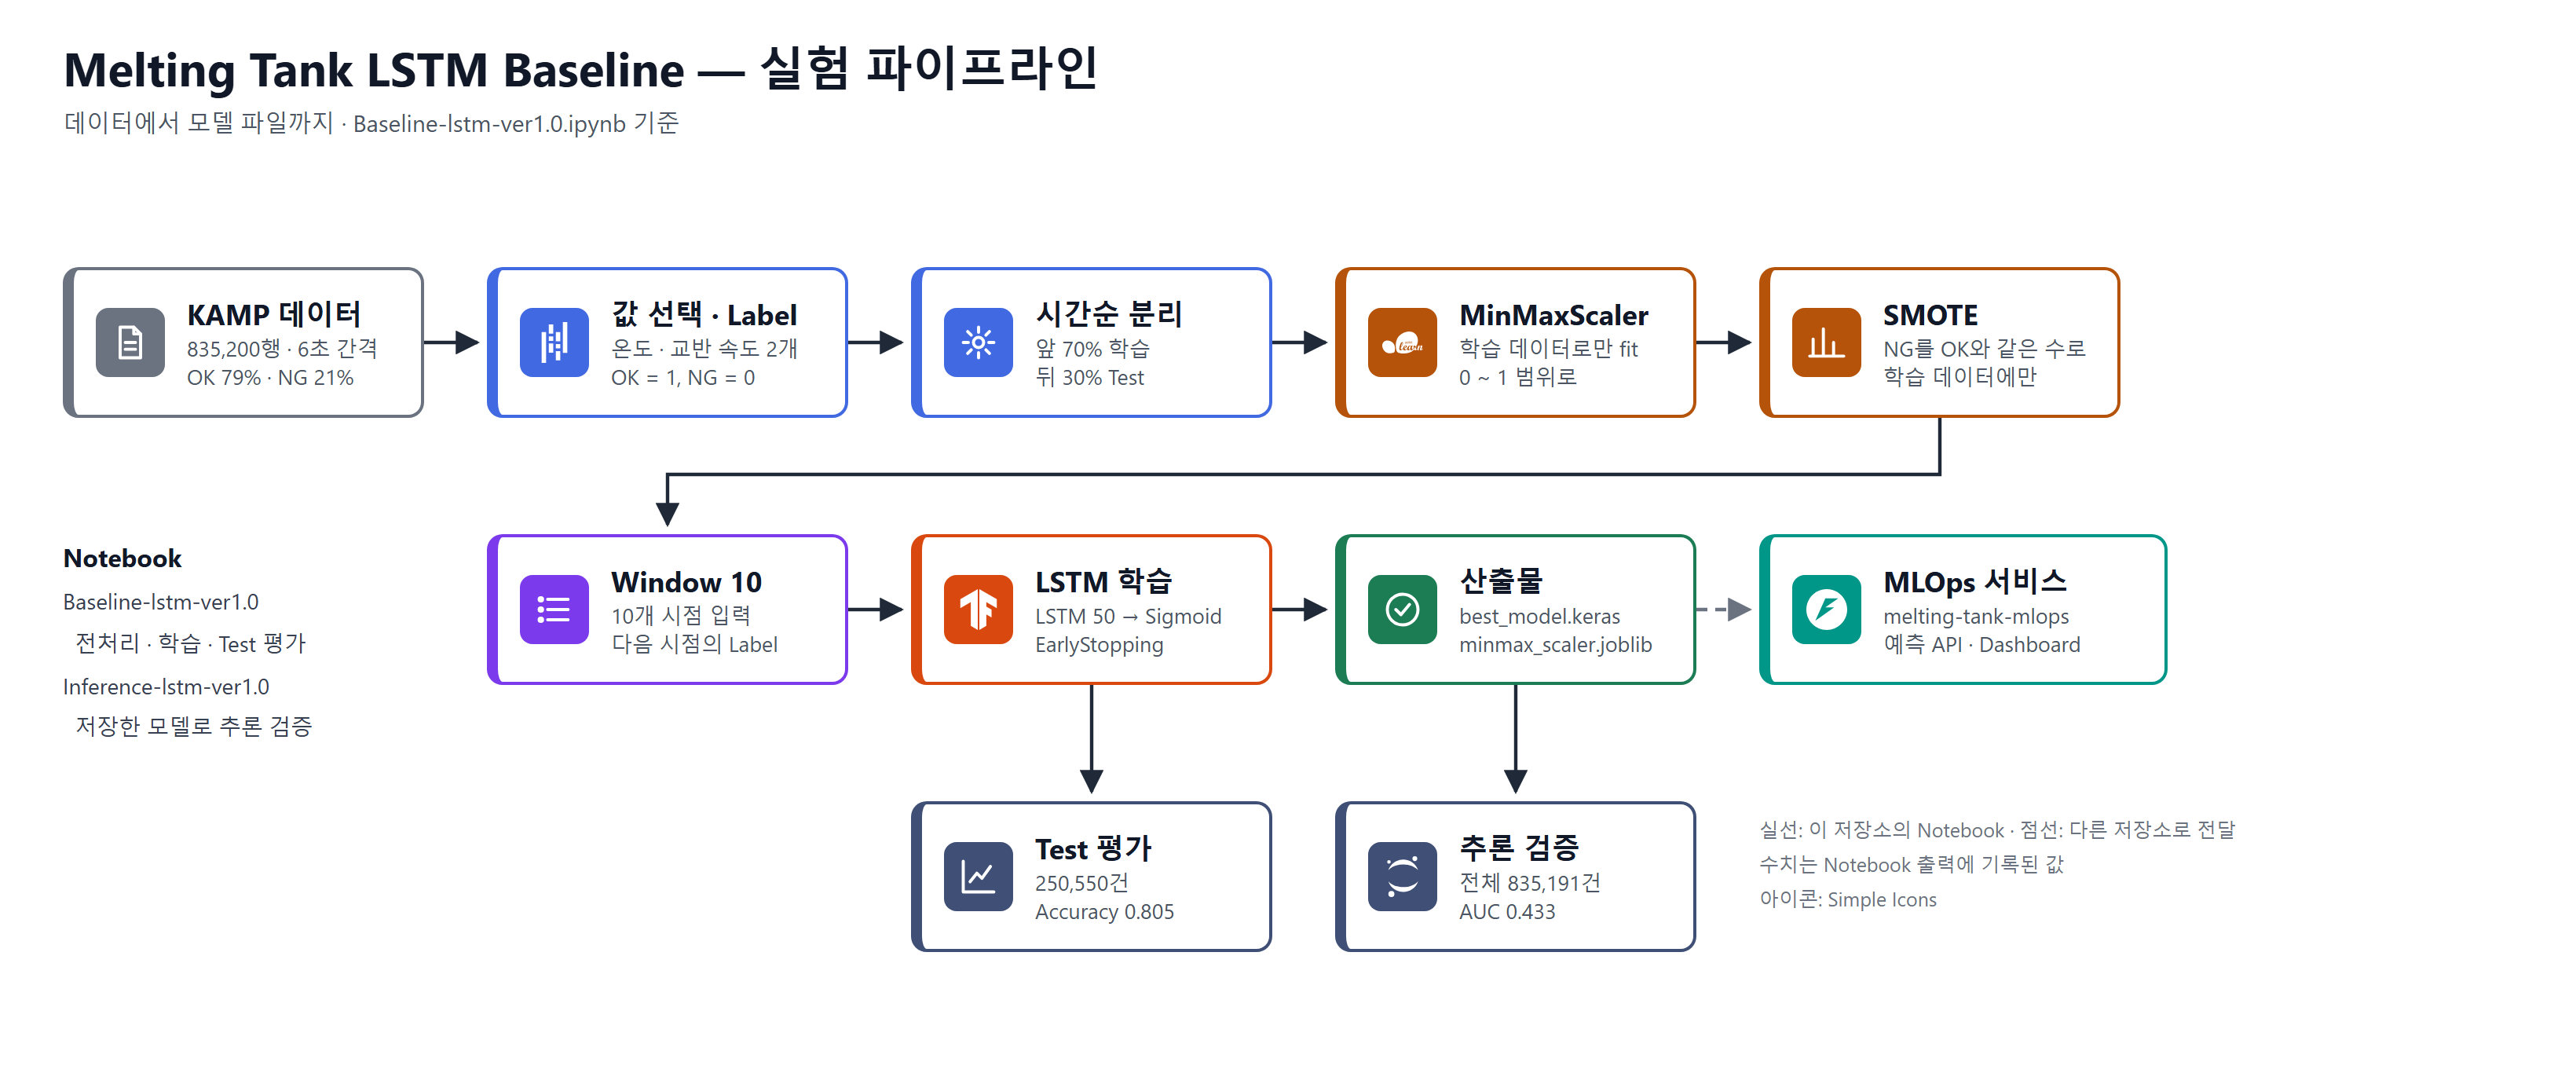
데이터
KAMP(중소벤처기업부 · KAIST)가 공개한 용해탱크 AI 데이터셋입니다. 저장소에는 데이터 파일이 없습니다.
| 열 | 뜻 | 범위 (Notebook 출력) | TAG와 상관계수 |
|---|---|---|---|
STD_DT |
측정 시각 | 2020-03-04 00:00 ~ 2020-04-30 23:59 | |
MELT_TEMP |
용해 온도 | 308 ~ 832 | 0.31 |
MOTORSPEED |
교반 속도 | 0 ~ 1,804 | 0.26 |
MELT_WEIGHT |
내용량 | 0 ~ 55,252 | -0.01 |
INSP |
수분 함유량 | 평균 3.19 | 0.27 |
TAG |
판정 | OK 658,133 · NG 177,067 |
- 835,200행이고 결측치는 없습니다.
- 1분에 10행(6초 간격)이 기록되어 있습니다.
- 온도, 교반 속도, 수분 함유량은 서로 상관계수가 0.89 ~ 0.94로 높습니다.
전처리 순서
- Label 만들기:
LabelEncoder로TAG를 숫자로 바꿉니다. 알파벳 순서라 NG = 0, OK = 1이 됩니다. - 값 선택:
MELT_TEMP,MOTORSPEED2개만 입력으로 씁니다. - 분리: 시간 순서를 유지한 채 앞 70%(584,640행, ~ 2020-04-13 14:23)를 학습, 뒤 30%(250,560행)를 Test로 나눕니다.
- 정규화: MinMaxScaler를 학습 데이터로만 맞추고, 학습과 Test에 적용합니다.
- 불균형 처리: 학습 데이터에 SMOTE를 적용합니다. NG가 174,124건에서 410,516건으로 늘어 OK와 같아집니다.
- Window 만들기: 10행을 한 Window로 묶고, Window 바로 다음 행의
TAG를 Label로 씁니다. - Validation 분리: 학습 Window의 30%를 무작위로 떼어 Validation으로 씁니다.
| 묶음 | 크기 |
|---|---|
| 학습 | 574,715 × 10 × 2 |
| Validation | 246,307 × 10 × 2 |
| Test | 250,550 × 10 × 2 |
모델과 학습 설정
| 항목 | 값 |
|---|---|
| 구조 | Input(10, 2) → LSTM(50, tanh) → Dense(1, Sigmoid) |
| Parameter | 10,651개 |
| Loss / Optimizer | Binary Crossentropy / Adam |
| Batch / Epoch | 50 / 최대 200 |
| EarlyStopping | val_loss가 10 Epoch 동안 나아지지 않으면 멈추고 가장 좋은 가중치로 되돌림 |
| 저장 | Epoch마다 checkpoints/에 저장, val_accuracy가 가장 높은 모델을 model/best_model.keras로 저장 |
만들어지는 파일
| 파일 | 내용 | 쓰는 곳 |
|---|---|---|
model/best_model.keras |
학습한 모델 | 추론 Notebook, melting-tank-mlops |
artifacts/minmax_scaler.joblib |
학습 데이터로 맞춘 Scaler | 위와 같음 |
artifacts/inference_meta.json |
입력 열 이름, Window 크기, Threshold | 추론 Notebook |
모델 출력은 정상(OK)일 확률입니다. 이 파일들을 가져다 쓰는 쪽에서 불량 확률이 필요하면 1 - 출력으로 계산해야 합니다. melting-tank-mlops는 처음에 이 변환이 없어 판정이 반대였습니다.