聚类Kmeans与层次聚类 - SpiralKernel/bioinfo-wiki GitHub Wiki
聚类Kmeans与层次聚类
更新:2026-10-13;状态:可用;验证范围:人工100点K-means已运行,检查SSE不增加;层次聚类仅文档说明。
聚类寻找指定表示和距离下的结构;簇数、初始化和批次都会影响结果。
K-means优化什么
K-means给定K个簇,最小化样本到所属质心的平方距离总和SSE。Lloyd迭代交替将样本分到最近质心、重新计算均值。目标通常不增加,但可能停在局部解,初始化和多次重启都重要。
簇编号没有固定生物学意义;算法输出0和1,与另一次输出1和0可以是相同划分。K-means适合其欧氏平方距离目标,对不同大小、密度或非球状结构不一定合适。
层次聚类
凝聚式方法从单样本开始逐步合并,linkage定义簇间关系。单连接、完全连接、平均连接和Ward不是同一种目标。树状图的切割高度影响簇数,叶子左右位置不直接表示连续生物学轴。
一般完整距离矩阵需要O(n²)内存,大量细胞不能只因二维图能画就假定层次聚类也轻量。实际实现可能有不同算法与稀疏近似。
怎么评价
看聚类与批次、供体、测序深度的关系;改变特征、初始化和分辨率检查稳定性。轮廓系数等内部指标评价某种几何结构,不证明存在真实细胞类型。外部标记或独立数据验证也应避免使用同一信息重复命名并验证。
已运行的教学实现
程序生成100个二维人工点,K=2,得到50/50个点,SSE从365.1583下降到45.5002。展示更新逻辑,不是对真实组学数据的聚类验证。
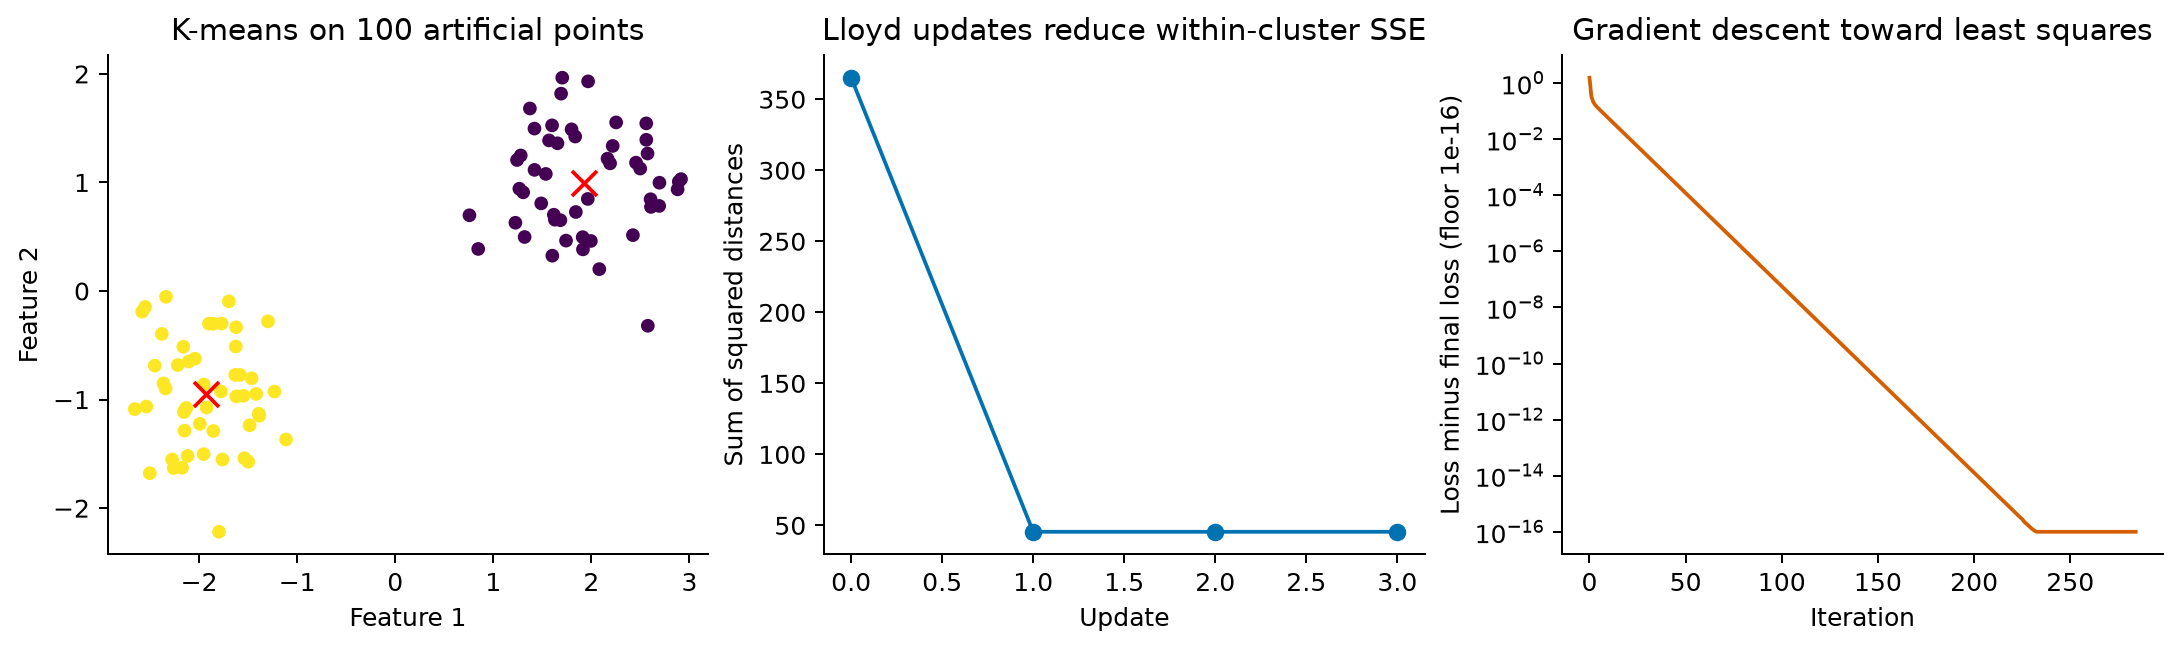
本图右侧还展示梯度下降与数值优化。运行入口见基础算法可复现练习。完整方法参考:scikit-learn聚类官方指南。