合成数据贯通统计推断 - SpiralKernel/bioinfo-wiki GitHub Wiki
合成数据贯通统计推断
更新:2026-10-13;状态:可用;验证范围:2026-10-13实际运行:Welch、配对、Fisher/卡方、BCa、置换、2000特征校正、供体反例和1000区间覆盖。
通过固定种子人工数据连接基础检验、区间、多重校正、重采样与供体层级。
目的与运行
这是已实际运行的连续人工数据案例,帮助检查统计推断的对象和方法。没有运行真实转录组、计数GLM、混合模型或湿实验;模拟中的真实效应和真假发现标签仅用于解释。
python3 -m pip install numpy scipy matplotlib
python3 examples/statistics_demo.py
在项目根目录、建议的虚拟环境中执行。固定种子20261013,输出 examples/output/statistics/,重复运行覆盖同名文件。实际版本见Python统计分析与结果核验;源代码。
1. 均值差和配对
两组独立人工样本分别24和36个,方差不同。效应统一为B−A,Welch估计0.9911,SE=0.3569,自由度约52,95%区间[0.2749,1.7074],P=0.00761。手写公式与SciPy核对一致。
另一批40个配对对象的平均变化为0.3124,配对t检验P=0.00191;忽略配对按独立样本算P=0.677。方法选择依据设计,而非挑选更小P值。
2. 分类表与重采样
2×2表 [8,2],[1,9](/SpiralKernel/bioinfo-wiki/wiki/8,2],[1,9) 的Fisher OR=36,双侧P=0.00548。独立均值差的4999次BCa区间为[0.3035,1.6695]。
置换使用另一份同方差位置模型数据,9999次随机重排P=0.4194;六个固定数的20种完整分组得到精确双侧P=0.1。Bootstrap与置换不是同一分布,也没有把异方差均值零假设直接当成完全交换性。
3. 多重检验
生成2000个独立连续特征,其中100个有人工组效应;这不是原始RNA-seq计数模型。逐特征Welch后:
| 规则 | 入选数 | 其中假发现,仅模拟已知 |
|---|---|---|
| 原始P<0.05 | 194 | 102 |
| BH调整值<0.05 | 62 | 3 |
| Bonferroni调整值<0.05 | 14 | 0 |
BH的本次实现假发现比例为3/62,不能把一次模拟当作FDR保证或证明Bonferroni永不误报。FDR是合适条件下关于重复研究的期望量。
4. 供体与细胞
生成20个独立人工供体,每个10个相关连续测量,共200个“细胞”,真实组效应为0。按供体均值比较P=0.527;错误地把所有细胞当独立样本P=0.0376。一次样本会有随机组差异,错误独立性会改变不确定性;大量细胞不等于大量供体。
5. 区间覆盖
另重复生成1000组独立正态样本,每组20个,按t规则构造95%均值区间,本次覆盖率0.942。有限模拟不要求恰好0.950;这也不是“某个已经得到的区间含参数的概率”。
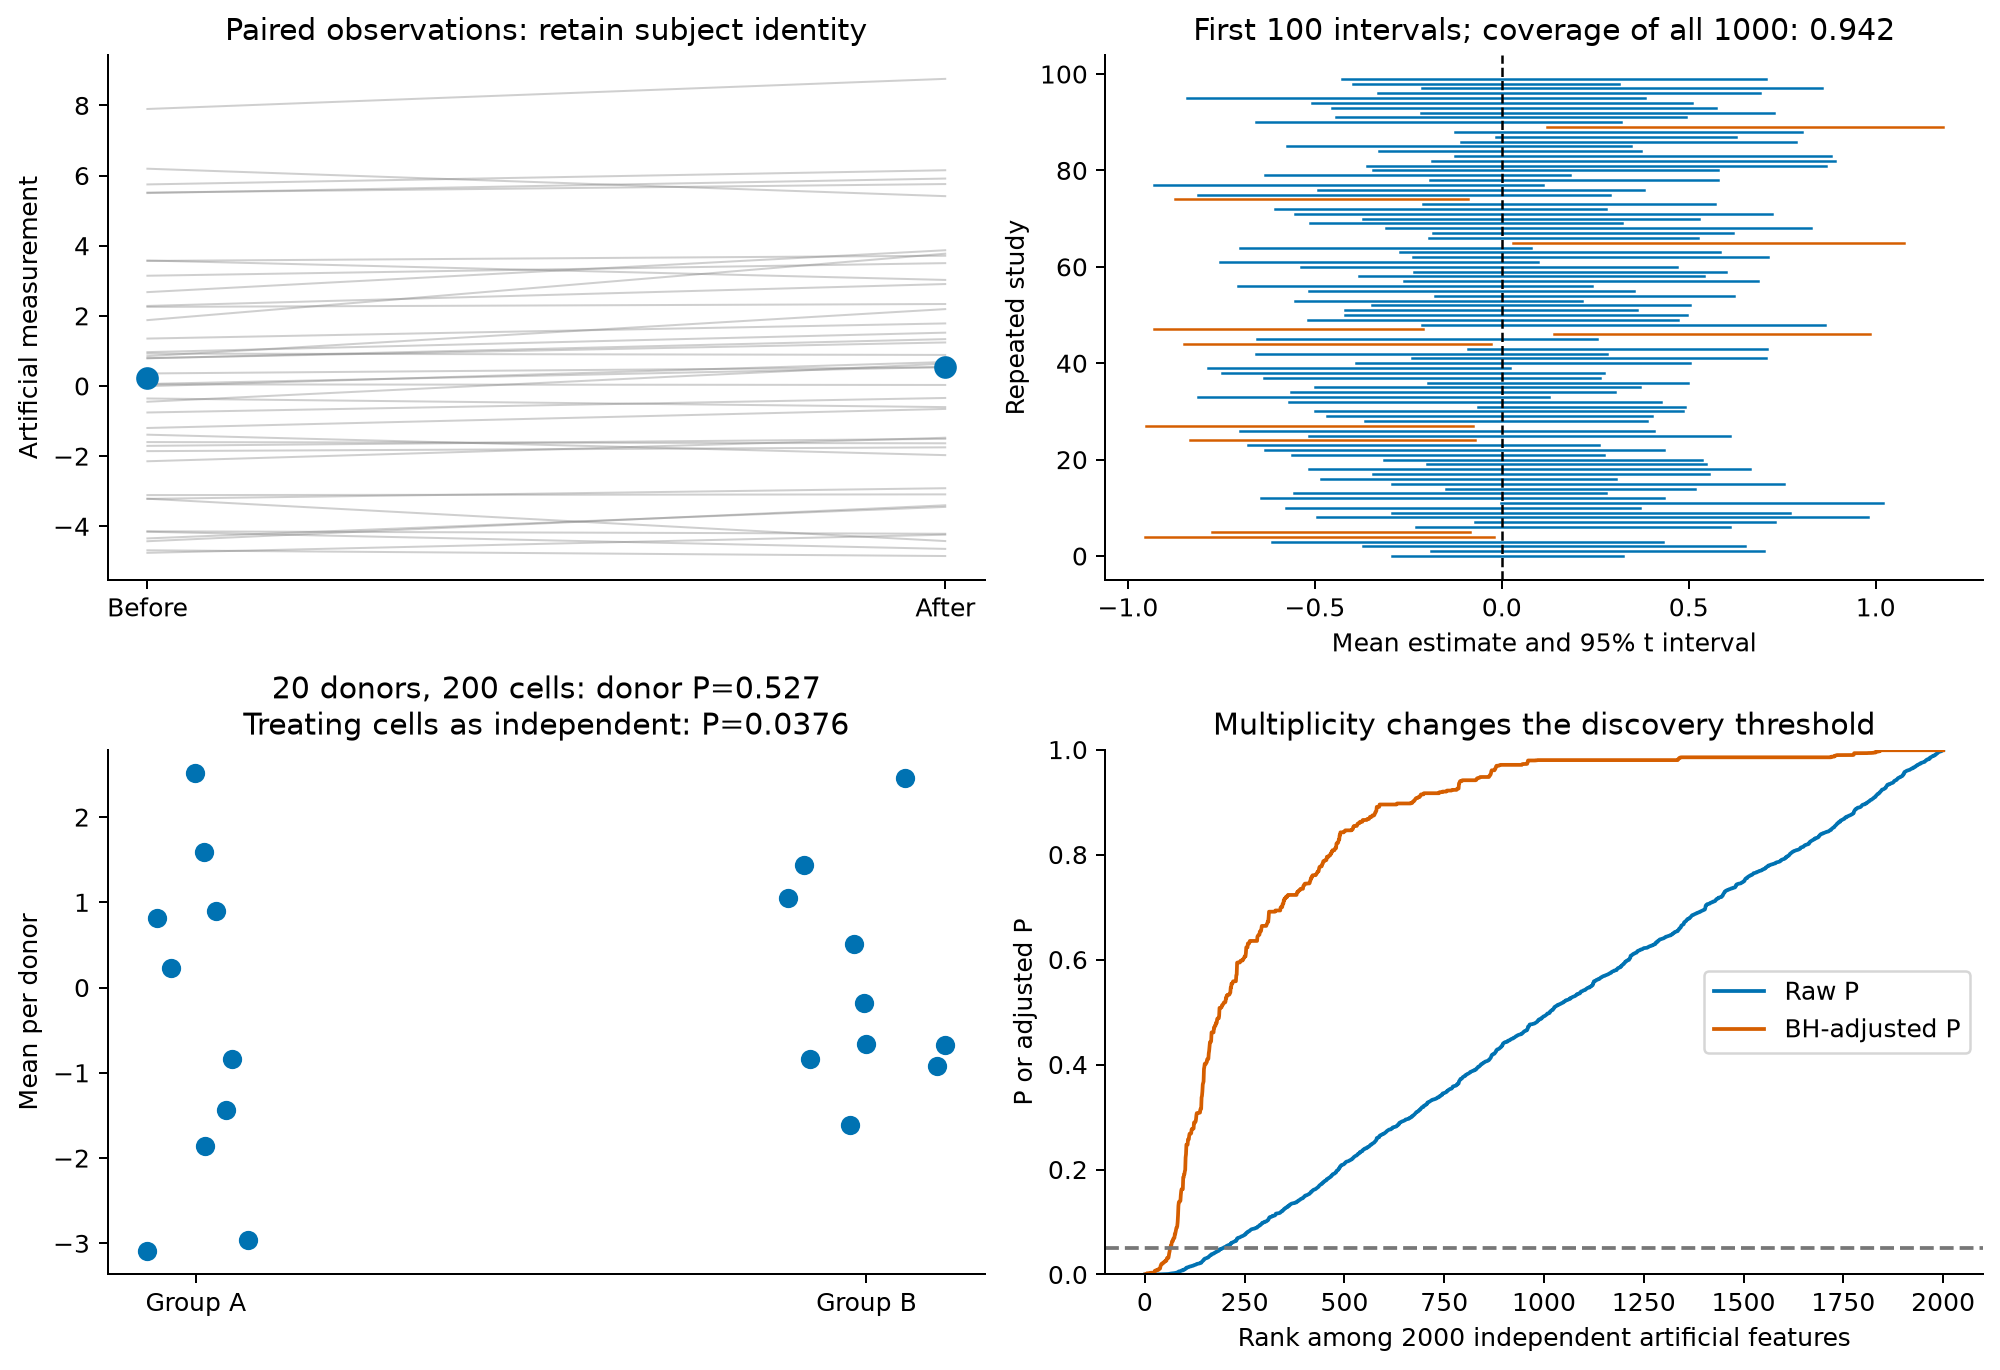
左上保留配对,右上展示前100个区间,左下每个点是一个供体均值,右下比较原始与BH调整P值。图与原始汇总均由同次运行产生。
输出与检查
summary.json保存参数、版本和数值;feature-tests.tsv保存2000个特征效应与校正;donor-cells.tsv保留供体、组别和细胞ID。人工明细由脚本生成,不需重复提交;公开配图与汇总用于核查。
下一步读统计方法选择与分析计划及组学验证的层级与证据,不要把人工连续数据的成功运行称为真实组学流程验证。