合成家系数据贯通GS - SpiralKernel/bioinfo-wiki-migrated GitHub Wiki
合成家系数据贯通GS
更新:2026-10-13;状态:可用;验证范围:2026-10-13实际运行:300个人工个体、GBLUP/RR等价、两种嵌套验证、60个候选预测和配图;未运行专业GS软件。
用300个人工个体贯通GBLUP、嵌套验证、家系留出和无表型候选预测。
这个例子能学到什么
本项目实际运行了Python/NumPy教学实现:生成家系基因型和数量性状,比较GBLUP与标记岭回归,进行随机个体和家系留出的嵌套验证,最后给60个人工候选输出预测。没有运行rrBLUP、BGLR或单步软件,也没有估计REML和可靠度。
人工数据便于理解真值与泄漏,不是软件性能基准,不代表鸡、牛或作物中的实际预测水平。
输入与数据生成
固定种子20261013,生成25个家系,每家系12个体,共300个体、400个位点。子代由人工父母的配子形成;60个位点具有模拟加性效应,另外加入共同家系环境和残差。真实遗传值标准化后仅供评价,不参与拟合或调参。
其中20个家系的240个体用于训练与交叉验证;另5个家系的60个体作为无表型候选,候选表型不参与任何参数选择。导出的 phenotypes.tsv 中候选性状为NA。
运行命令
在项目根目录运行,依赖Python、NumPy;配图另需Matplotlib。本次NumPy版本2.5.4。
python3 -m pip install numpy matplotlib
python3 examples/genomic_prediction_demo.py
python3 examples/plot_genomic_prediction.py
脚本写入 examples/output/gs/,重复运行覆盖其中同名输出。建议先建立项目虚拟环境,见软件环境与依赖管理。代码入口:预测程序、绘图程序。
先检查模型等价
程序用同一训练中心、固定截距和匹配惩罚分别计算GBLUP与标记岭回归。最大预测差为 $9.99\times10^{-16}$。它证明这两条教学实现按指定参数一致;不表示不同软件默认设置会完全一致。公式见GBLUP与rrBLUP原理及实现。
再比较两种部署目标
外层5折评价,内层3折按MSE从lambda集合0.1、0.3、1、3、10选择。家系模式的内外层都保持家系分离。每折中心和位点过滤仅从当前训练部分估计。
| 指标 | 随机个体划分 | 整家系留出 |
|---|---|---|
| 每折表型相关的均值 | 0.3712 | 0.0439 |
| 每折真实遗传值相关的均值,仅模拟可知 | 0.5848 | 0.2715 |
| 所有折外预测的表型MSE | 2.0083 | 2.3866 |
| 每个测试折与训练集共享家系数 | 17–19 | 0 |
相关采用每折计算后取均值;MSE按所有折外样本汇总。不同折的遗传基准可能不同,不直接拼接所有折的GEBV做统一育种排序。这组数据包含家系关系和共享环境,跨家系表现更弱。随机划分与家系留出回答不同问题,不能从一次模拟得出随机划分始终不合理的结论。
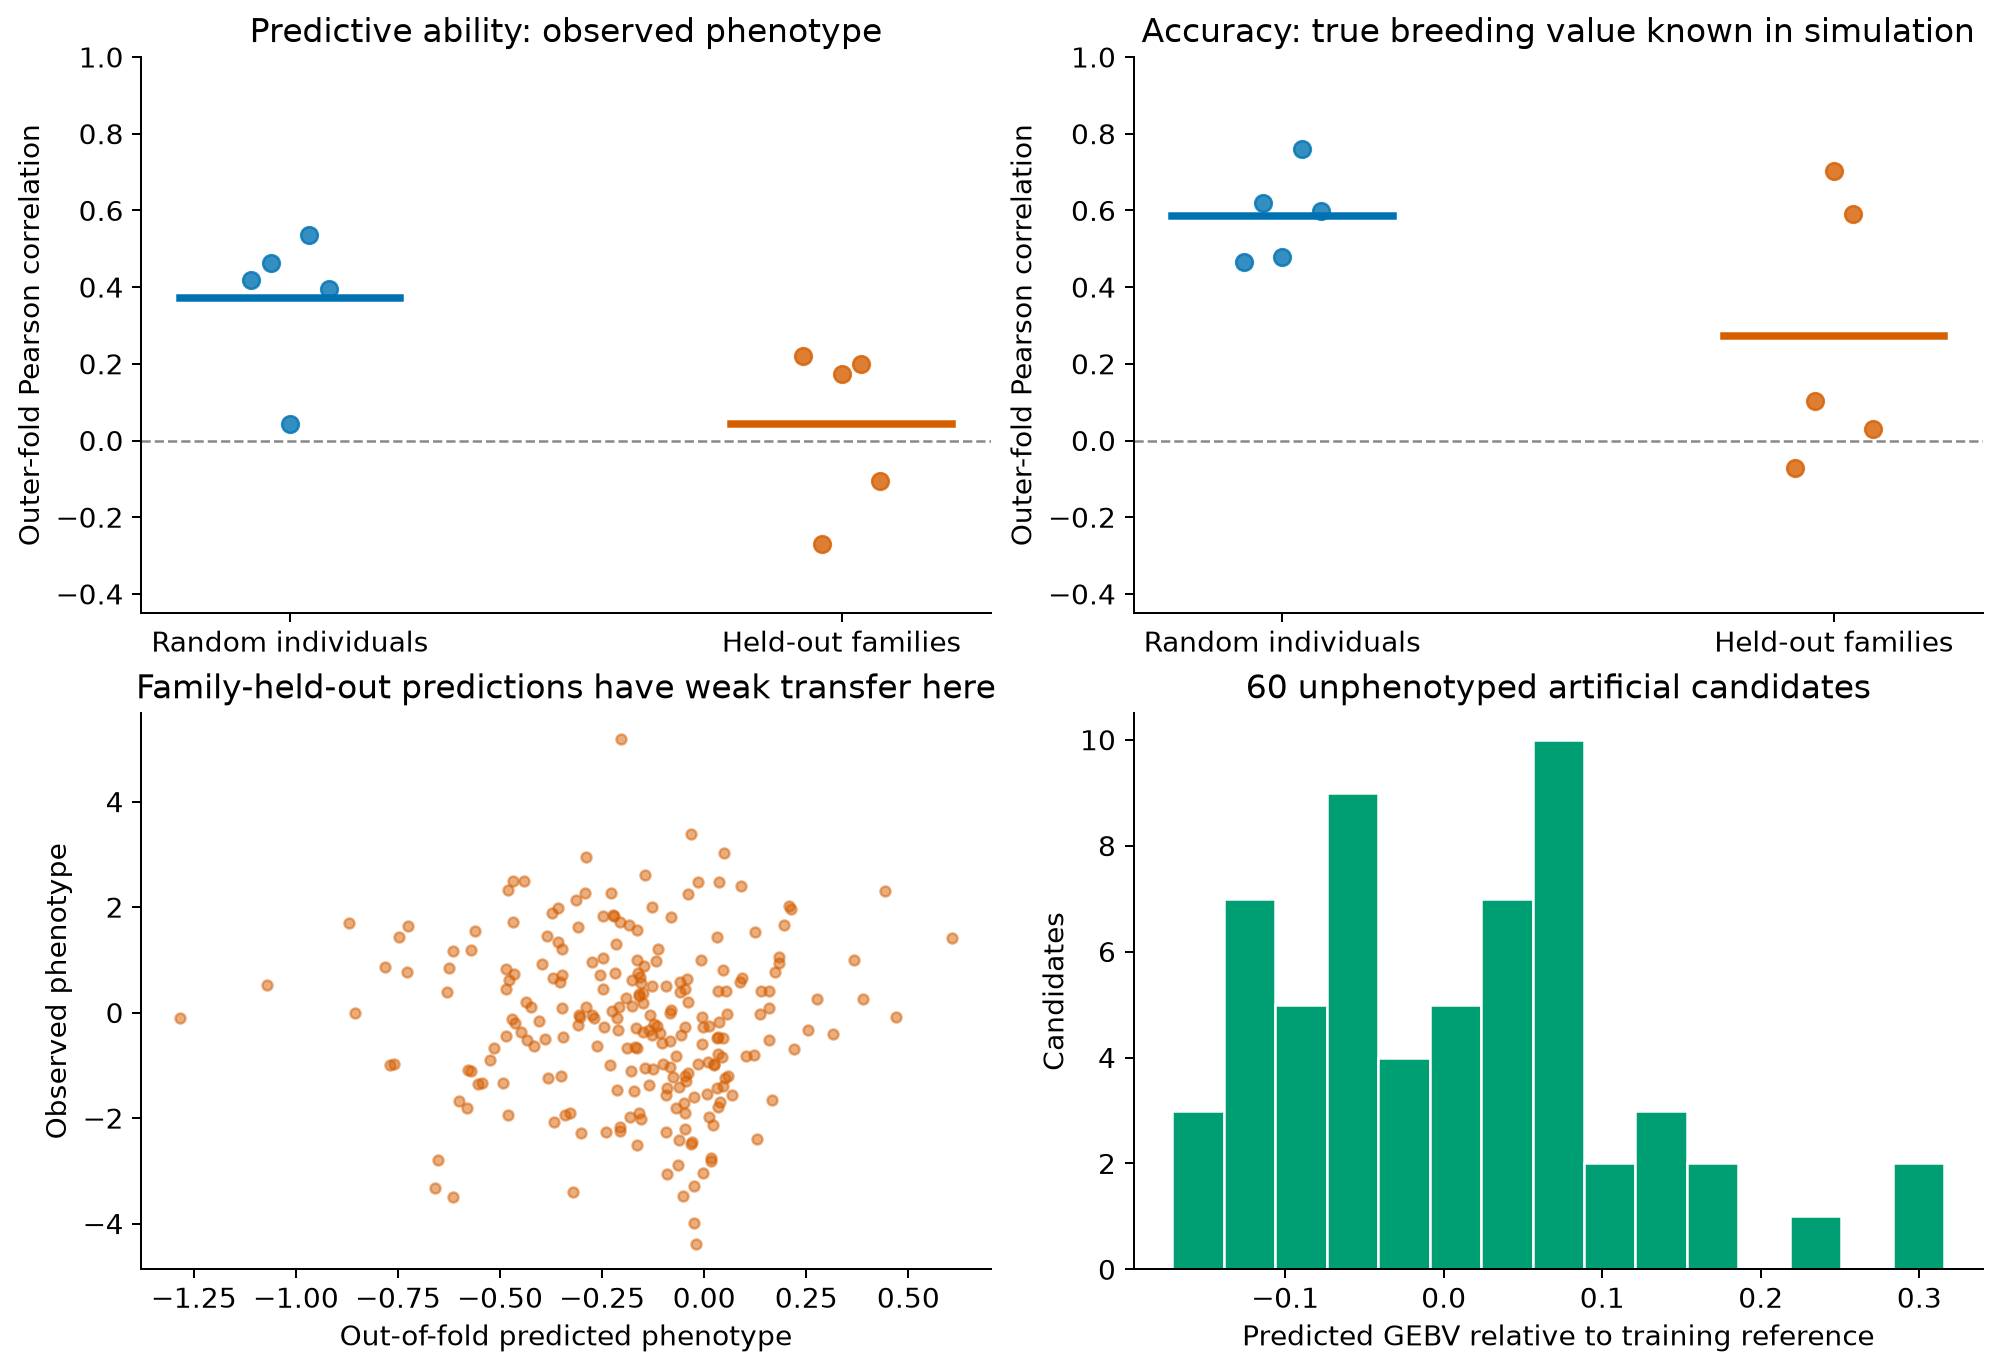
图中点代表各外层折,横线代表折均相关;右下为60个候选的相对GEBV分布。相关很低或为负的折也是结果,应保留。
最后预测候选
全部240个训练个体内部按家系调参,当前有限网格选到lambda=10,再拟合训练模型并预测60个候选。选到网格上界提示实际项目应扩展网格检查,不能称10为普遍最优参数。
candidate-predictions.tsv 同时保存GEBV与预测表型;prediction-model.npz 保存训练中心、保留位点、标记效应、截距和尺度。能够输出60个数不意味着已达到选择应用要求:本例的新家系表型预测能力偏弱。
输出检查清单
genotypes.tsv:300行,ID及400个0/1/2剂量列。phenotypes.tsv:300行,ID、家系和性状;仅240行有观测值。predictions.tsv:训练部分每个个体的折外预测、折号及仅模拟可知的真值。candidate-predictions.tsv:60个候选,无候选表型列。summary.json:每折指标、调参结果及模型范围。
候选表和模型文件不包含可供训练使用的候选表型;模拟真值仍只用于教学诊断。源代码中没有用真实遗传值调参。完整指标见公开汇总。
下一步可以用rrBLUP预测实践读取同一批表格,但其REML参数估计与本例CV选择不同,不要求数值逐一一致。评价定义见育种值GEBV准确度与可靠度。