人工数据贯通群体遗传统计 - SpiralKernel/bioinfo-wiki GitHub Wiki
人工数据贯通群体遗传统计
更新:2026-10-14;状态:可用;验证范围:人工完整单倍型多样性、Tajima D、描述性分化、LD与中性漂变已运行;无真实推断。
用完整人工单倍型核对π、θ、描述性分化、LD与中性漂变,说明统计量的条件解释。
运行
先按R包Python包与可复现环境创建.venv、安装NumPy和Matplotlib,在项目根目录运行。macOS/Linux:
.venv/bin/python examples/population_genetics_demo.py
Windows PowerShell:
.\.venv\Scripts\python.exe examples/population_genetics_demo.py
固定种子20261013,输出到examples/output/population-genetics/,重复运行覆盖同名文件。输入8条完整已分相二元单倍型、12个可检测位置,A/B各4条;所有不变位置保留。这不是任何真实基因或物种数据。
8×12矩阵内置于脚本:每行一条单倍型、每列一个位置、0/1为两种等位状态,前4行属于A、后4行属于B。artificial-haplotypes.tsv是导出的副本,修改它不会改变输入,重跑会覆盖它。
以A的第一位点为例,4条中1条状态为1,p=1/4,单点成对差异为2×(1/4)×(3/4)×4/3=0.5。把12个位置的单点差异求和得到π总量,再除以12才得到每可检测位点π;不变位置贡献0,但仍在长度分母中。
实际指标
| 指标 | A | B | 合并 |
|---|---|---|---|
| 分离位点S | 5 | 4 | 5 |
| 每可检测位点π | 0.222222 | 0.180556 | 0.229167 |
| 每位点Watterson θ | 0.227273 | 0.181818 | 0.160698 |
| Tajima D | −0.212492 | −0.065010 | 1.932105 |
合并结果改变,不说明已发现平衡选择:样本本来就有结构,代码没有计算显著性。不同样本数也影响频谱估计。
描述性等群体权重(ΣHT−ΣHS)/ΣHT=0.246753,未做有限样本校正,不是WC/Hudson实现。第一对位点合并r²=0.217778;B中一个位点单态,r²未定义,不当0输出。
中性漂变
模拟二倍体Wright–Fisher:固定Ne=50或500、p0=0.5、40代、500个人工群体,无选择、突变或迁移。最后频率方差分别0.08004和0.00994,理论值0.08276和0.00981。有限模拟不要求完全一致,也不能从该例反推真实Ne。
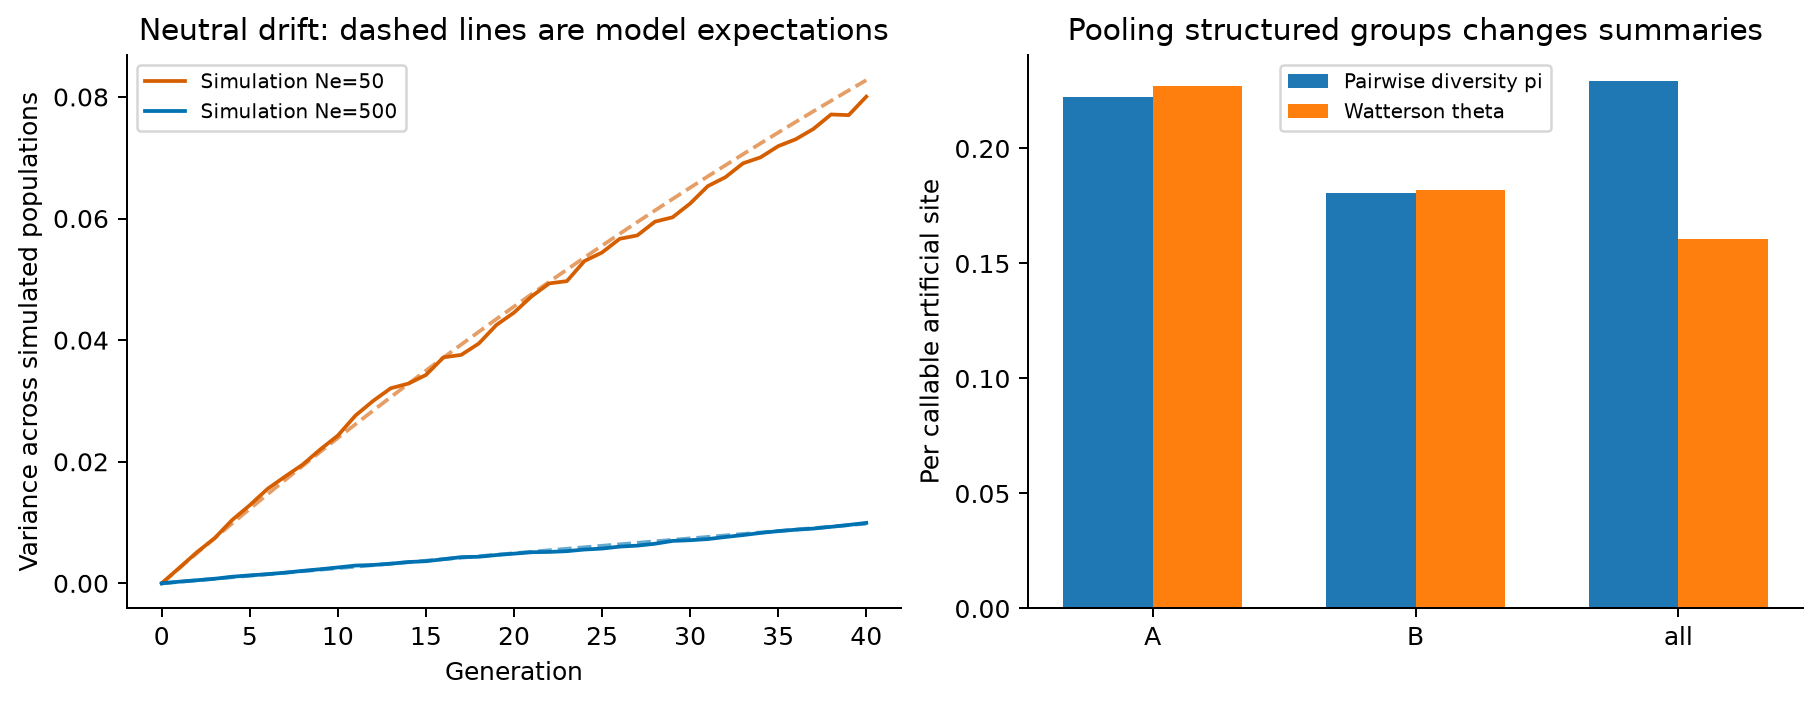
左图虚线为指定模型期望,右图比较每可检测位点的两种多样性。输出summary.json和artificial-haplotypes.tsv可核对。源代码。
本例没有VCF、缺失、基因型似然、真实遗传距离或专业群体软件。现实场景先读群体遗传学分析学习路线与群体遗传软件与输入选择。