PCA原理与实现 - SpiralKernel/bioinfo-wiki-migrated GitHub Wiki
PCA原理与实现
更新:2026-10-26;状态:可用;验证范围:2026-10-26核对原始与官方资料;本页Python微型计算已执行;人工数据不代表专业软件或真实研究性能。
主成分分析(principal component analysis,PCA)把许多相关特征压缩成少数正交方向,尽量保留输入中的变异。它适合探索样本结构、异常和技术因素;它既不使用分组标签寻找最优分类,也不会自动判断哪条轴是“真实生物差异”。读完应能从一个小矩阵算出坐标、解释方差与重建误差。
前置为距离标准化与相似性和矩阵行列乘法。以下X的行为样本、列为特征;转置会改变分析对象。
从“找变化最多的方向”到SVD
先逐列减去均值得到中心化矩阵$X_c$。对它作奇异值分解$X_c=U\Sigma V^T$:V每列是一个特征方向;样本坐标(scores)是$T=X_cV=U\Sigma$;第k个奇异值σk对应的样本方差是$\sigma_k^2/(n-1)$。保留前q个方向可用$T_qV_q^T$近似原中心化数据。
此处n是样本行数,转置符号T表示行列互换,Σ为奇异值组成的对角矩阵;代码中的Vt直接是V的转置,@表示矩阵乘法,axis=0沿样本行逐列计算。第一方向最大化投影后方差;之后方向在与前面方向正交条件下继续最大化。方差解释率为σk²除以全部奇异值平方之和。若只拿前5个特征值相互归一,得到的是“这5条轴内部的比例”,不能宣称对全部数据解释比例。NumPy SVD接口与scikit-learn PCA说明可核对分解和中心化约定。
一眼能看懂的三样本
X三行为(1,2)、(2,4)、(3,6),均值(2,4),中心化后为(−1,−2)、(0,0)、(1,2)。第二列始终是第一列的2倍,所有点在一条直线上。沿(1,2)/√5投影得到−√5、0、√5;另一正交方向方差为0。因此PC1解释率为1,只需一条轴无误差重建这组人工数据。
本页例子在项目根目录的Python中运行;标准库例子无需安装包,含NumPy/SciPy的例子先按R包Python包与可复现环境建立项目环境。Windows命令使用
python,macOS/Linux可使用python3;代码块可复制进该环境的Python交互会话,或保存为项目根目录下的临时脚本再用该环境解释器运行;不要保存到examples目录或任意外部目录后假定项目导入路径仍相同。除特别说明外,只向屏幕输出,不写文件。
import numpy as np
X = np.array([1.,2.],[2.,4.],[3.,6.](/SpiralKernel/bioinfo-wiki-migrated/wiki/1.,2.],[2.,4.],[3.,6.))
mean = X.mean(axis=0)
C = X - mean
U, s, Vt = np.linalg.svd(C, full_matrices=False)
scores = C @ Vt.T
ratio = s**2 / (s**2).sum()
print('singular_values', np.round(s,6))
print('explained_ratio', np.round(ratio,6))
print('PC1_absolute_scores', np.round(abs(scores[:,0]),6))
reconstructed = scores[:,:1] @ Vt[:1,:] + mean
print('reconstruction_error', round(float(abs(reconstructed-X).max()),12))
assert np.allclose(ratio,[1.,0.])
assert np.allclose(reconstructed,X)
输出奇异值约3.162278与0,解释率[1,0],绝对坐标[2.236068,0,2.236068],重建误差0。使用绝对值作检查,是因为奇异向量整体乘−1仍是同一方向;左右翻转不代表结果改变。若奇异值相同,对应子空间中的轴还能旋转,逐列比较也可能误导。
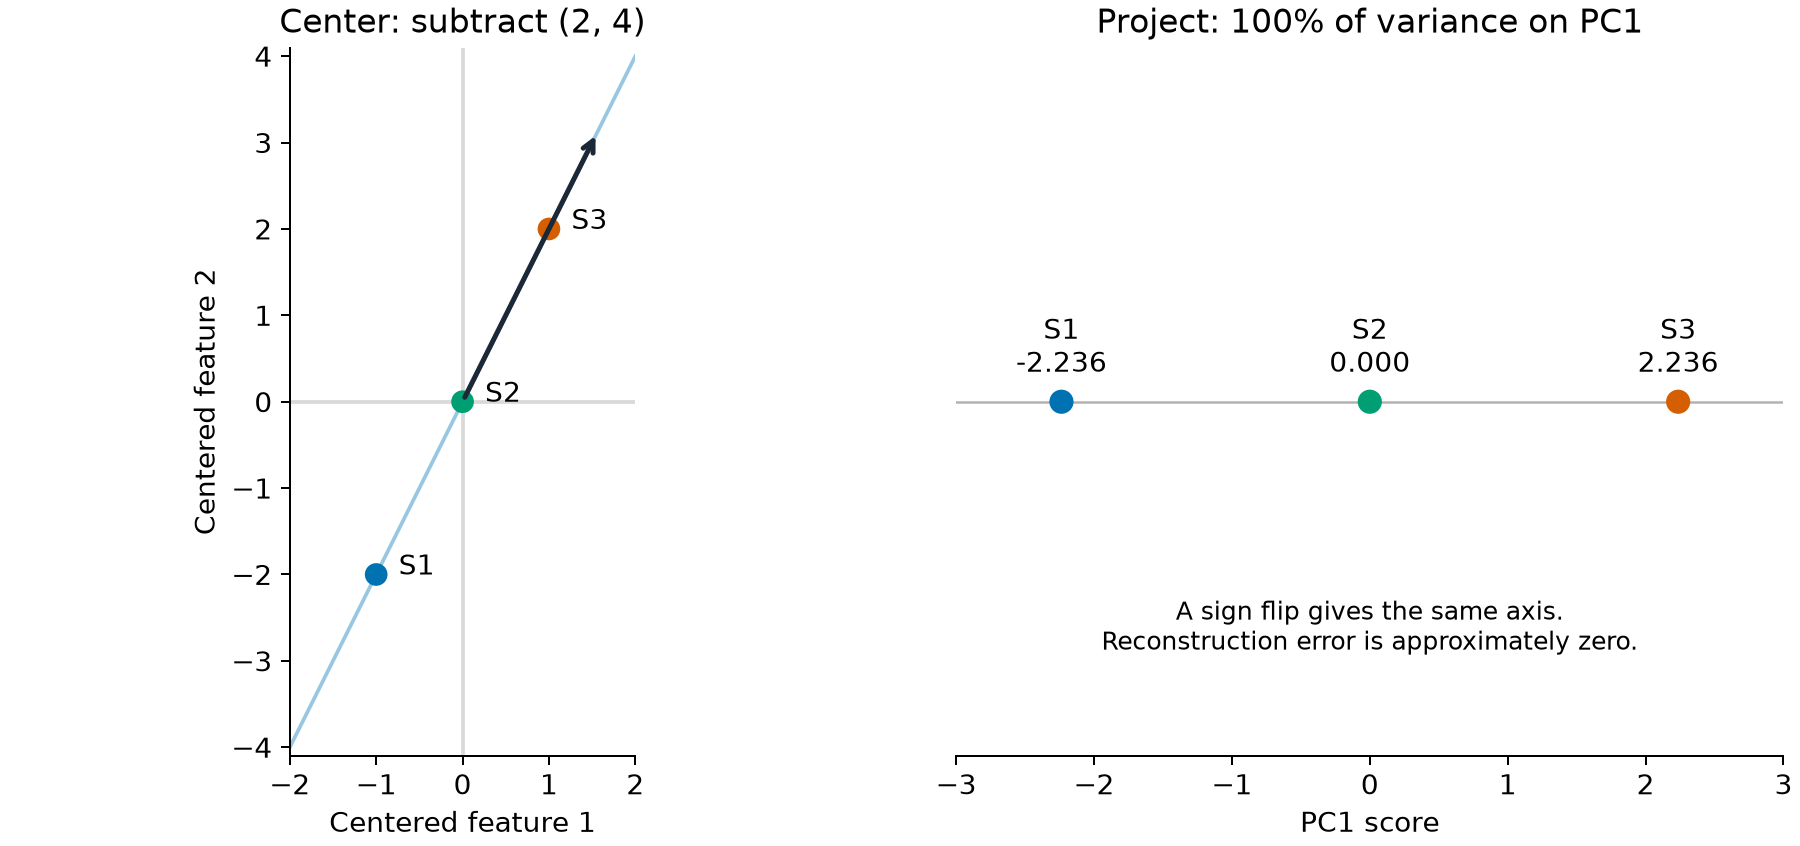
左图为逐列中心化后的三个样本,右图为沿PC1投影的一维坐标。箭头方向人为取第一分量为正,整体反号仍表示同一轴。图由本项目绘图脚本根据同一人工输入生成。
为什么不能机械标准化所有数据
普通PCA中心化但是否缩放由研究目标决定。两列单位差很多时不缩放会让大尺度列主导;按列标准差缩放又会让低方差噪声获得相同权重。群体基因型常按等位频率中心化并按预期方差处理,还要控制LD、稀有位点和亲缘关系;普通表格PCA不自动等于PLINK的基因组PCA。
RNA-seq样本PCA一般先使用适当计数归一化与VST/log等变换;原始计数直接PCA可能主要反映深度。选择哪些基因或位点也是方法的一部分,需记录过滤标准。
投影、诊断与实际检查
新样本投影需使用训练均值、尺度、同一特征顺序和方向V;重新在新批次计算PCA不会生成可直接拼接的同一坐标。缺特征、等位基因方向错或缩放不一致都会偏移投影,见数据泄漏与交叉验证。
画图至少标注轴解释率,用批次、深度、家系、分组分别着色。前两轴看不出分组不等于没有任何差异,看到分离也不证明因果或分类泛化。异常点应追查样本身份和QC,而不是为美观直接删除。
| 症状 | 检查 | 判断 |
|---|---|---|
| PC1与深度高度相关 | 输入是否原始计数、归一化是否正确 | 技术因素可能主导 |
| 方向符号相反 | 距离/重建是否相同 | 通常无需修“方向错误” |
| 解释率总和大于1 | 分母和百分数单位 | 使用完整总方差 |
| 投影偏移严重 | 特征顺序、频率、尺度、等位方向 | 统一训练变换 |
自测:PCA按标签分得好就能直接报告预测准确率吗? 答:不能,须独立预测验证。自测:标准化本例两列后,PC1方向一定仍为(1,2)/√5吗? 答:不会;两列被改到相同尺度,方向改变,但仍是一维相关结构。
接着读什么
距离标准化与相似性 → 数据泄漏与交叉验证 → R包Python包与可复现环境 → 合成数据贯通PCA与GWAS → 用PCA探索样本的群体结构 → 方法与算法系统学习指南。学习顺序与练习入口见方法与算法系统学习指南。
运行本页的完整小例
先下载项目并进入含README与examples的根目录,环境准备见方法与算法系统学习指南。用项目环境的Python运行以下命令(macOS/Linux路径示例;Windows用.venv\Scripts\python.exe):
.venv/bin/python examples/methods_foundations_demo.py --case pca --output examples/output/methods-pca
输出summary.json保存本页计算与检查结果。目录非空时拒绝覆盖,再练习请更换--output目录;页面内短代码只打印结果。标准库case也可用系统Python直接运行。
公式里的矩阵、下标或对数不熟时,可回查读懂方法公式的最小数学基础。