4. óra 3D objektumdetektálás pontfelhőkön és a gyakorlati feladat ismeretetése - CooperativeResearchPlatform/object_detection_for_aeb GitHub Wiki
Az előző órán képeken dolgoztunk: megismertük a konvolúciós neurális hálózatok backbone--neck--head felépítését, az objektumdetektálás osztályozási és lokalizációs részfeladatait, valamint egy gépi tanulási projekt célszerű szerkezetét. Most ugyanezt a gondolkodásmódot visszük át LiDAR-pontfelhőkre.
Az óra központi kérdése:
Hogyan alakítható egy rendezetlen, ritka 3D pontfelhő olyan reprezentációvá, amelyen a már ismert 2D CNN-ek hatékonyan használhatók, és hogyan lesz ebből CenterPoint 3D detektor?
Egy LiDAR-mérés pontok halmaza:
ahol
A LiDAR jellemzően sűrűbb és pontosabb geometriai pontokat ad; az autóipari radar pontfelhője ritkább és zajosabb, viszont közvetlen relatív sebességmérést is tartalmazhat. A két szenzor nyers adata eltérő, de CNN szempontból ugyanaz az alapgond: egyik sem szabályos képrács.
Egy kép és egy pontfelhő között alapvető szerkezeti különbség van:
| Kép | Pontfelhő |
|---|---|
| Szabályos |
Szabálytalan 3D mintavétel |
| Minden pixelnek rögzített szomszédai vannak | A pontok szomszédságát külön kell definiálni |
| A tenzor mérete előre ismert | A pontok száma változó |
| A pixelek sorrendje jelentést hordoz | A pontok felsorolási sorrendje önkényes |
| Közel állandó mintavételi sűrűség | Távolsággal gyorsan ritkuló mérés |
A 2D konvolúció egy szabályos rácson ugyanazt a lokális műveletet alkalmazza minden pozícióban. Egy nyers
ahol
A megoldásnak ezért legalább az alábbi problémákat kell kezelnie:
- Rendezetlenség: a pontok sorrendje ne befolyásolja a kimenetet.
- Szabálytalan szomszédság: meg kell mondani, mely pontok alkotnak lokális környezetet.
- Ritkaság: a vizsgált 3D tér túlnyomó része üres.
- Változó sűrűség: közel sok, távol kevés pont mérhető ugyanarról az objektumról.
- Számítási költség: egy sűrű 3D rács memóriája a felbontással köbösen nő.
Ha egy
cella lenne. Ennek csak kis része tartalmaz LiDAR-pontot, mégis minden sűrű 3D konvolúció végigszámolná az üres cellákat is. Ez indokolja a ritka (sparse) konvolúciós műveleteket vagy a magassági dimenzió összevonását.
flowchart LR
	P["Nyers pontfelhő<br/>N x C"]
	P --> A["Pont-alapú feldolgozás"]
	P --> B["Voxel-alapú feldolgozás"]
	P --> C["Vetített reprezentáció"]
	A --> A1["PointNet / PointNet++<br/>pont-MLP + szimmetrikus pooling"]
	B --> B1["VoxelNet<br/>3D voxelek + 3D CNN"]
	B --> B2["PointPillars<br/>oszlopok + 2D CNN"]
	C --> C1["BEV- vagy range image<br/>2D CNN"]
- Pont-alapú módszerek: közvetlenül a pontokon tanulnak, ezért kevés geometriai információ vész el, de a szomszédkeresés és a változó elemszám kezelése költséges lehet.
- Voxel-alapú módszerek: szabályos rácsba rendezik a teret. A kvantálás információt veszít, cserébe konvolúciós hálózatok használhatók.
- Vetítéses módszerek: például madártávlati képet (BEV) vagy a LiDAR mérési irányaihoz igazodó range image-et képeznek. Gyorsak, de a vetítés során több pont ugyanarra a pixelre kerülhet.
A PointNet minden pontra ugyanazt a kis neurális hálót, azaz megosztott súlyú MLP-t alkalmazza. Ezután egy szimmetrikus művelet, tipikusan csatornánkénti maximum képzi az egész ponthalmaz jellemzőjét:
A MAX eredménye nem függ a pontok sorrendjétől, tehát biztosítja a permutáció-invarianciát.
flowchart LR
	P1["p1 = x,y,z,r"] --> M["Megosztott<br/>pont-MLP"]
	P2["p2 = x,y,z,r"] --> M
	PN["pN = x,y,z,r"] --> M
	M --> F["Pontjellemzők<br/>N x C"]
	F --> MAX["Csatornánkénti<br/>MAX pooling"]
	MAX --> G["Globális jellemző<br/>1 x C"]
	G --> H["Klasszifikációs vagy<br/>szegmentációs fej"]
Erőssége: egyszerű, elegáns, közvetlen pontfeldolgozás.
Korlátja: az eredeti PointNet a globális maximum előtt kevéssé modellezi a lokális pontszomszédságokat. A PointNet++ ezt hierarchikus környezetképzéssel javítja.
A VoxelNet a 3D teret kis voxelekre bontja. Egy voxel pontjaira Voxel Feature Encoding (VFE) réteget alkalmaz: pontonként jellemzőt képez, majd lokális maximumot számít. A nem üres voxelek jellemzői ezután ritka 3D tenzort alkotnak, amelyet egy 3D konvolúciós middle encoder dolgoz fel.
flowchart LR
	P["Pontfelhő"] --> V["3D voxelizálás"]
	V --> VFE["VFE<br/>pontonkénti MLP + MAX"]
	VFE --> S["Ritka 3D<br/>jellemzőtér"]
	S --> C3["3D konvolúciók"]
	C3 --> BEV["BEV jellemzőtérkép"]
	BEV --> D["Detekciós fej"]
Erőssége: megőrzi a térbeli magassági szerkezetet, a voxel jellemzőjét nem kézzel tervezzük.
Korlátja: a 3D konvolúció még ritka (sparse) megvalósítással is költséges; a voxelméret erős pontosság--sebesség kompromisszum.
A PointPillars felismerése az, hogy közúti objektumdetektálásban a pontos madártávlati
flowchart LR
	P["Pontfelhő<br/>x,y,z,r,t"] --> G["x-y pillar-rács<br/>a z nincs felosztva"]
	G --> PFN["Pillar Feature Net<br/>pontonkénti MLP + MAX"]
	PFN --> SC["Scatter<br/>jellemző a saját x-y cellába"]
	SC --> PI["Pszeudokép<br/>C x H x W"]
	PI --> CNN["2D backbone + neck"]
	CNN --> HEAD["2D/3D detekciós fej"]
Erőssége: gyors, mert a költséges 3D konvolúció helyett jól optimalizált 2D CNN-t használ.
Korlátja: a teljes pillar magasságát egy jellemzővektorba sűríti, ezért a részletes függőleges szerkezet egy része elveszik.
| Módszer | Alapegység | Fő aggregáció | Konvolúció | Fő kompromisszum |
|---|---|---|---|---|
| PointNet | pont | globális MAX | nincs hagyományos rácskonvolúció | kevés lokális geometria |
| VoxelNet | 3D voxel | voxelen belüli MAX | 3D, jellemzően sparse | pontosabb 3D szerkezet, nagyobb költség |
| PointPillars | függőleges pillar | pillaren belüli MAX | 2D | gyors, de összevonja a magassági rácsot |
Fontos, hogy ezek nem egymást kizáró ötletek. A VoxelNet és a PointPillars pontonkénti enkódere is PointNet-szerű: megosztott transzformációt és sorrendfüggetlen maximumot használ egy lokális csoporton belül.
Legyen a pontfelhő tartománya
a pillar alapterülete pedig
Egy pont rácsindexe:
A notebookban használt CenterPoint pillar konfigurációban:
a teljes voxelméret pedig [0.2, 0.2, 8]. A harmadik, 8 méteres méret a teljes
ezért
Minden pont a saját
- legfeljebb
$P$ nem üres pillar egy mintában; - legfeljebb
$T$ pont egy pillarban; - a hiányzó helyeket nullákkal töltjük ki, a többletpontokat mintavételezzük vagy eldobjuk.
Az MMDetection3D példakonfigurációjában max_num_points=20, a maximális pillarszám tanításkor 30 000, tesztkor 40 000. A nyers, ritka pontfelhőből így egy feldolgozható
Egy nyers pont jellemzője itt öt szám: PillarFeatureNet két relatív helyvektort fűz:
ahol
ahol
A példában a pontonkénti bemenet mérete:
Ugyanazt a lineáris réteg--normalizáció--ReLU transzformációt alkalmazzuk minden pontra, majd pillárisonként csatornánkénti maximumot számítunk:
Az eredmény pillarenként egy
Létrehozunk egy kezdetben nulla
tenzort. Minden nem üres pillar 64 dimenziós vektorát a hozzá tartozó
flowchart TB
	subgraph PC["Pontok felülnézetben"]
		A["••• autó"]
		B["• gyalogos"]
		E["ritka háttérpontok"]
	end
	PC --> GRID["512 x 512 pillar-rács<br/>cellaméret: 0,2 m x 0,2 m"]
	GRID --> SETS["Nem üres pillarok<br/>{p1,p2,...}"]
	SETS --> ENC["11D pontjellemző → PFN → MAX"]
	ENC --> VEC["Pillarenként egy 64D vektor"]
	VEC --> IMAGE["Scatter: 64 x 512 x 512 pszeudokép"]
	IMAGE --> CNN["Szokásos 2D CNN"]
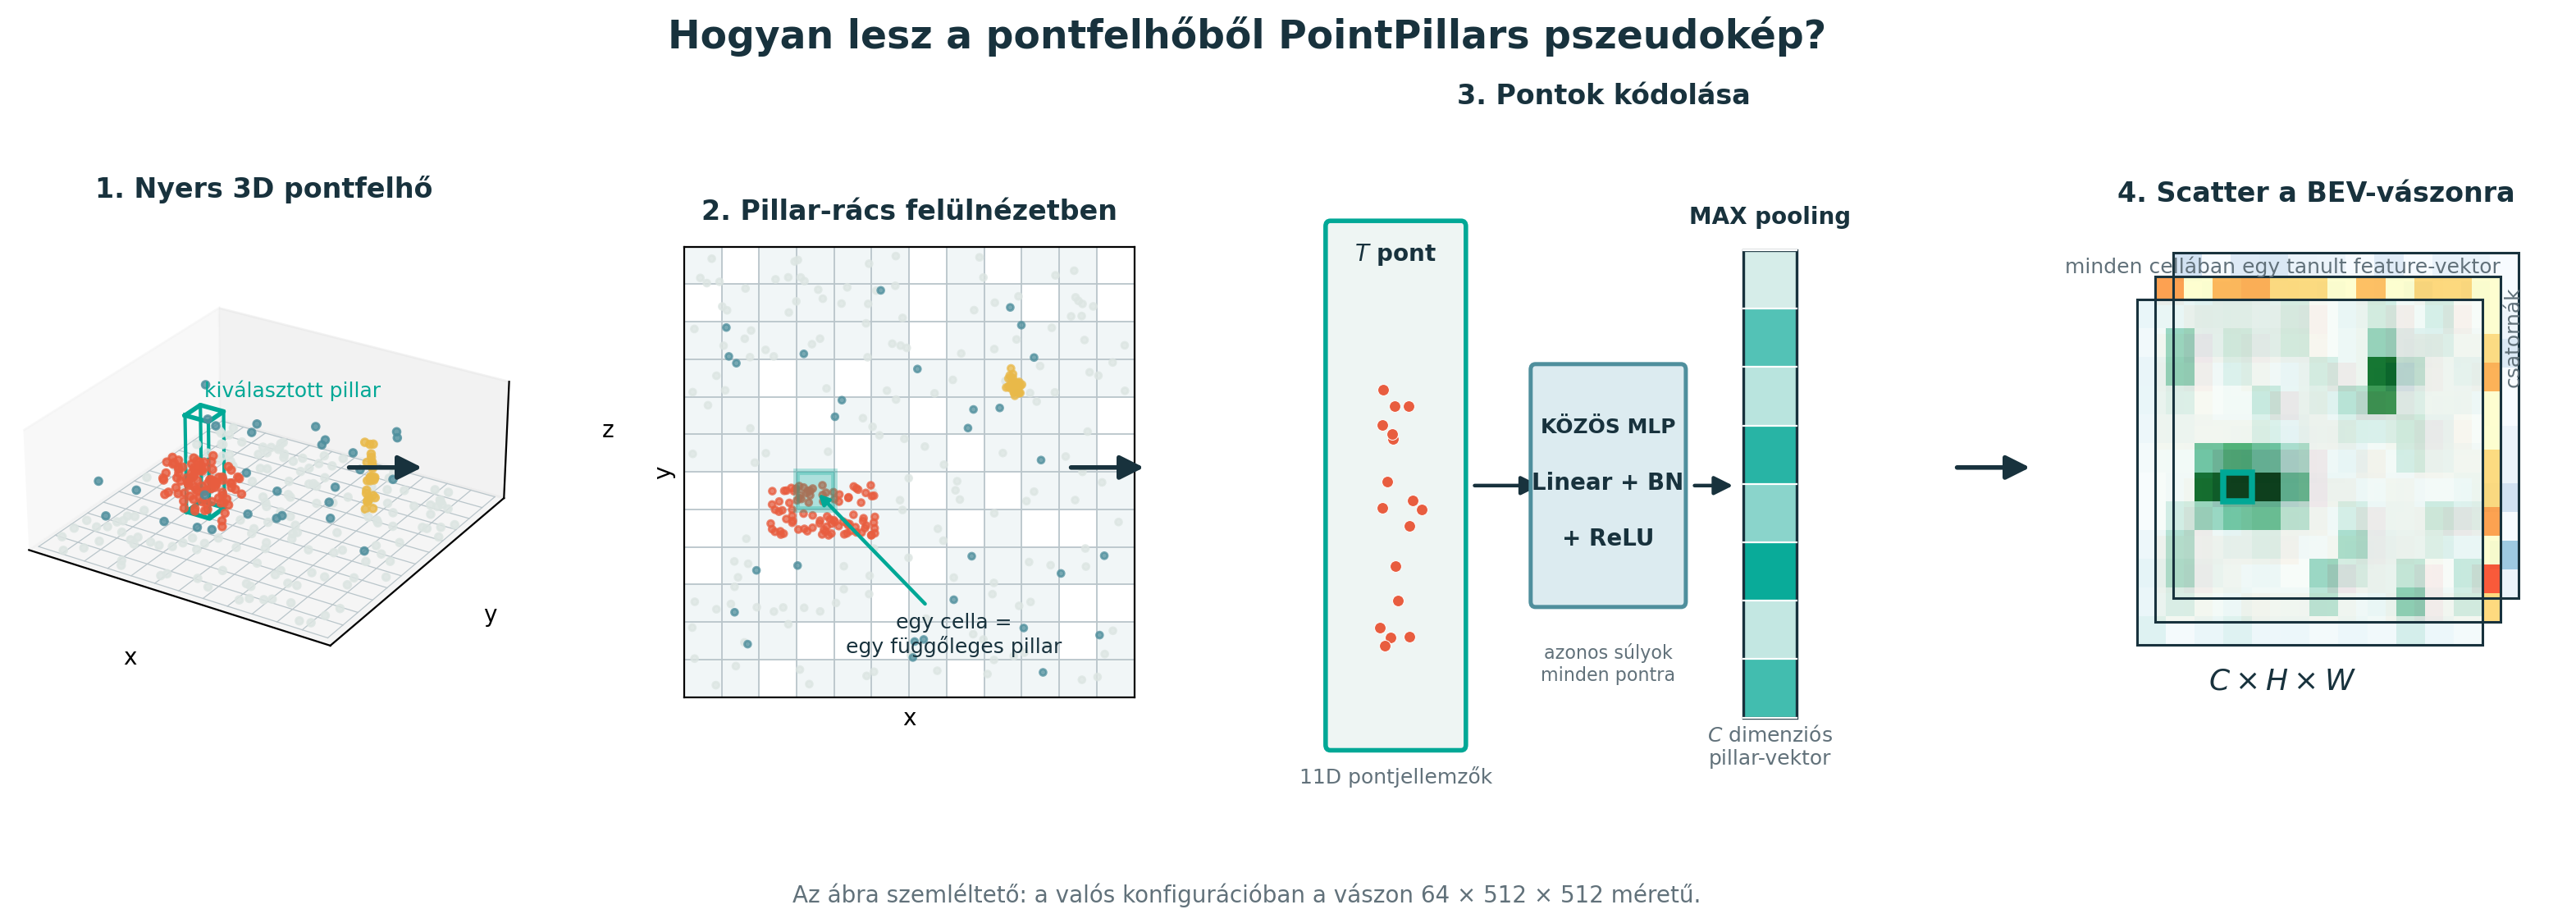
Az ábrán ugyanazt a türkizzel jelölt pillart követjük végig:
-
3D pontfelhő: a pontoknak folytonos
$(x,y,z)$ koordinátájuk van; a kiemelt függőleges oszlop a teljes magassági tartományt átfogja. -
Pillar-rács: felülnézetben az
$(x,y)$ koordináta kijelöli a cellát. A$z$ koordináta nem hoz létre új rácsréteget, hanem a pillaron belüli pontjellemző része marad. -
Pontkódolás: minden pontra ugyanaz a kis MLP kerül, majd a csatornánkénti MAX pooling a
$T$ pontból egyetlen$C$ dimenziós pillar-vektort készít. -
Scatter: a vektor visszakerül a saját
$(i,j)$ cellájába. Az összes pillar elhelyezése után létrejön a$C\times H\times W$ tenzor, amely már szabályos 2D CNN-bemenet.
A jobb oldali színes rétegek csak a tanult csatornák szemléltetésére szolgálnak. Nem RGB-színeket és nem előre megadott fizikai mennyiségeket jelentenek.
A „pixelérték” itt tehát nem RGB-szín, hanem egy tanult, 64 dimenziós leírás arról, milyen pontmintázat található az adott földterületen.
A pszeudoképnek két szabályos térbeli tengelye van, és a szomszédos cellák szomszédos útfelületeket jelentenek. Ez pontosan az a struktúra, amelyre a 2D konvolúció épít:
- a kernel lokális környezeteket lát;
- ugyanazokat a súlyokat használja minden BEV-pozícióban;
- a mélyebb rétegek egyre nagyobb fizikai környezetet fednek le;
- a backbone és a neck ugyanúgy több léptékű jellemzőket készíthet, mint képeknél.
A CenterPoint egy anchor-free, center-based 3D objektumdetektor. Nem előre definiált 3D horgonydobozok ezreit igazítja az adathoz. Ehelyett először az objektumok középpontját keresi meg madártávlatban (BEV), majd csak ezekhez a középpontokhoz regresszálja a teljes 3D dobozt.
Az alapintuíció:
Egy autó dobozának sokféle lehetséges mérete és iránya lehet, de a középpontja egyetlen jól meghatározott hely a BEV-térképen.
A notebook pillar-alapú CenterPoint változata a következő hálózati részekből áll:
flowchart LR
	P["10 LiDAR sweep<br/>N x 5 pont"] --> V["Voxel layer<br/>0,2 x 0,2 x 8 m pillar"]
	V --> PFN["PillarFeatureNet<br/>64D pillar-jellemző"]
	PFN --> S["PointPillarsScatter<br/>64 x 512 x 512"]
	S --> B["SECOND backbone<br/>3 felbontási szint"]
	B --> N["SECONDFPN neck<br/>384 x 128 x 128"]
	N --> H["CenterHead"]
	H --> HM["Középponti heatmap<br/>osztálypontszámok"]
	H --> REG["Dobozfejek<br/>offset, z, méret,<br/>irány, sebesség"]
	HM --> DEC["Top-K + dekódolás<br/>+ circle NMS"]
	REG --> DEC
	DEC --> OUT["3D dobozok<br/>osztály + score"]
A SECOND backbone három léptékben készít jellemzőket. A SECONDFPN ezeket közös
A nyers pillar-rács
A hőtérkép nem azt mondja meg, mely pixeleket foglalja el az autó. Minden osztályhoz egy külön
Egy magas car érték az
flowchart LR
	F["BEV jellemzőtérkép"] --> C1["3 x 3 konvolúció<br/>+ BN + ReLU"]
	C1 --> C2["3 x 3 konvolúció"]
	C2 --> H1["car heatmap"]
	C2 --> H2["truck heatmap"]
	C2 --> HC["... osztályonként<br/>egy csatorna"]
	H1 --> P1["lokális maximum =<br/>autóközéppont-jelölt"]
Ha csak a középponthoz legközelebbi cellát jelölnénk 1-gyel, minden szomszédos cella ugyanúgy negatív lenne, mint egy száz méterrel távolabbi hely. Ez túl éles célfüggvény lenne: egyetlen cellányi lokalizációs eltérés aránytalan büntetést kapna.
A CenterPoint ezért minden ground-truth középpont köré Gauss-foltot rajzol. A középpont célértéke 1, a környezetében fokozatosan csökken:
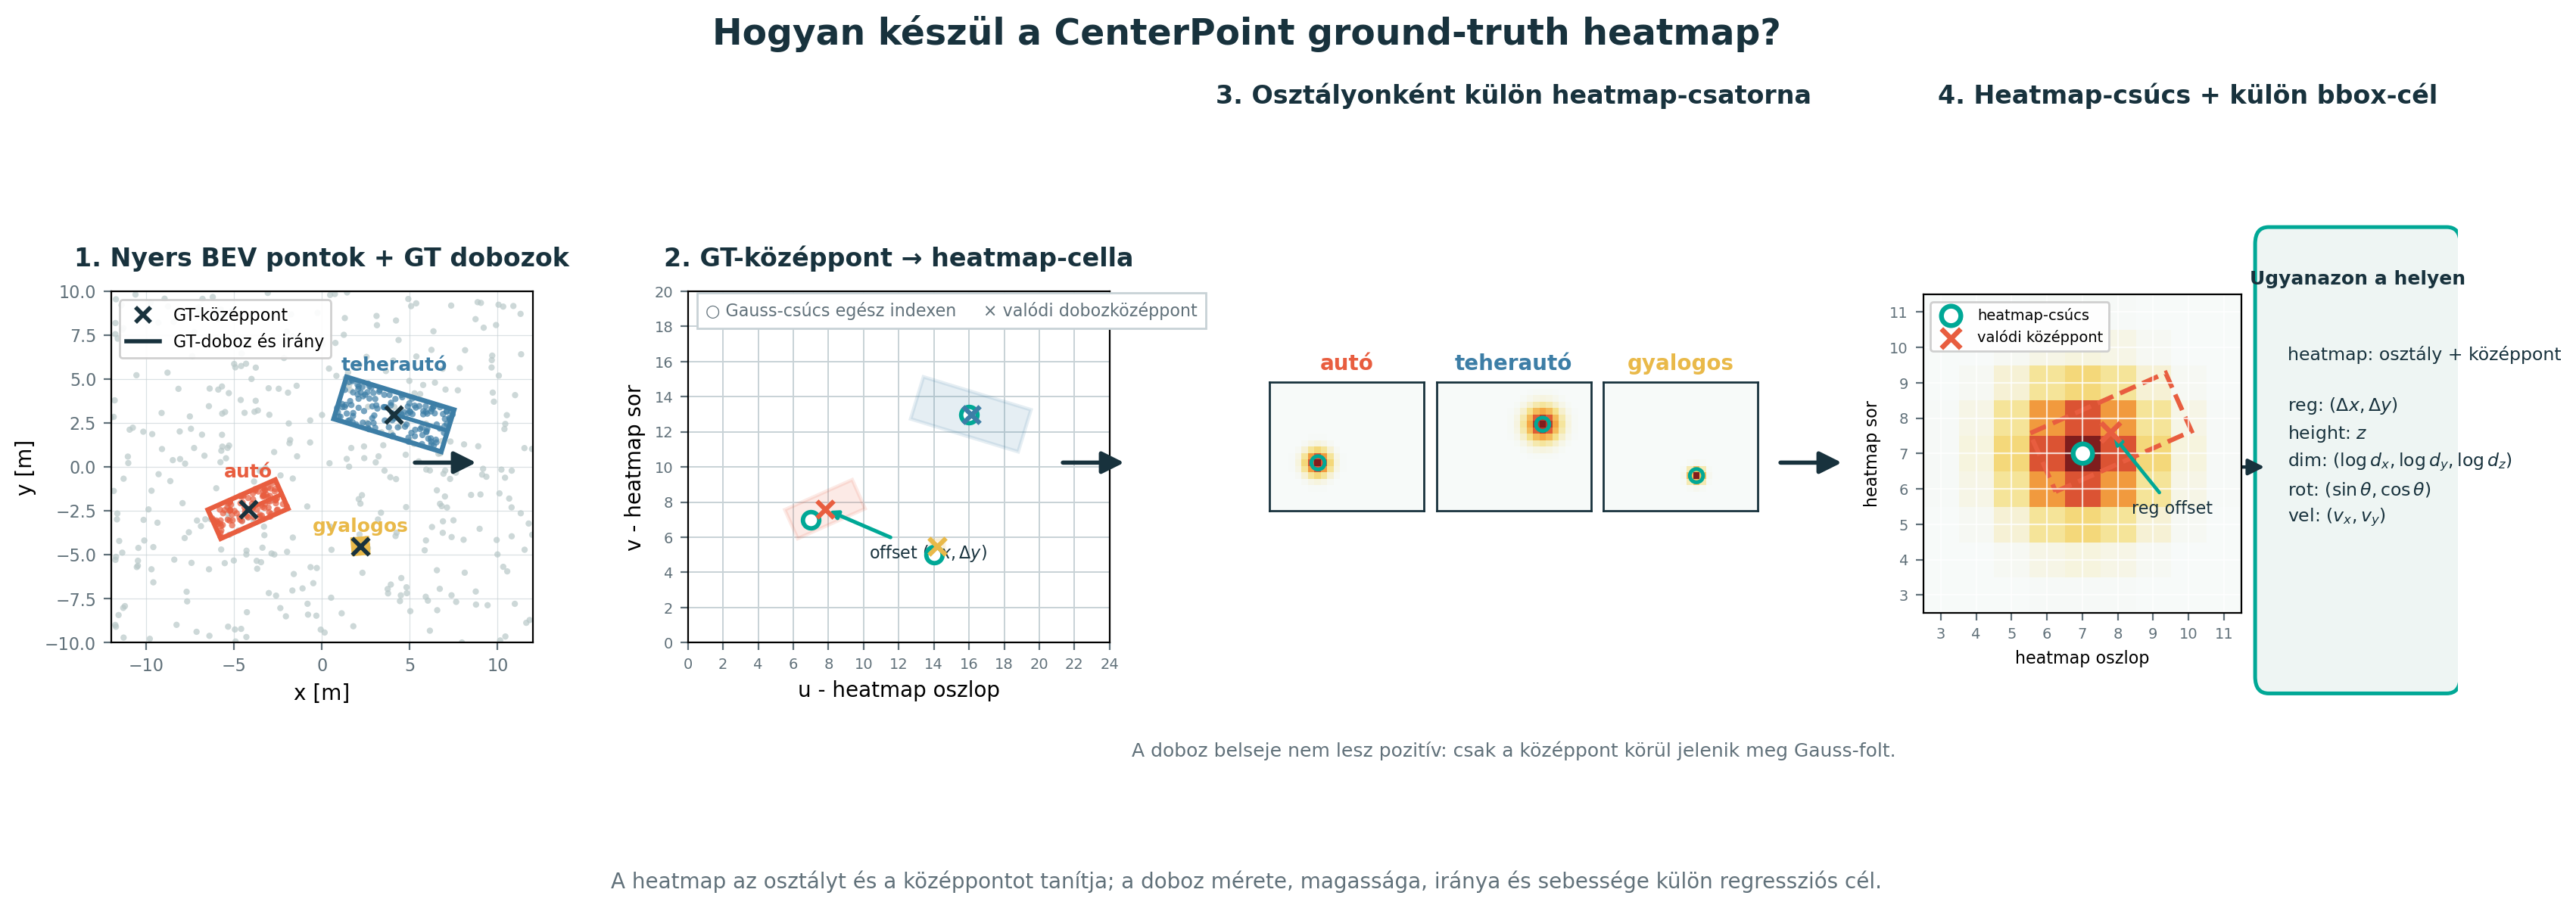
Az ábra ugyanazt a három GT objektumot követi végig:
- Nyers adat és GT doboz: a BEV pontfelhő fölött látható az autó, a teherautó és a gyalogos orientált GT doboza. A fekete kereszt a doboz folytonos geometriai középpontja.
-
Kvantálás a heatmap rácsára: a dobozközéppont a legközelebbi alsó egész feature-map indexhez kerül. A türkiz kör a Gauss-csúcs helye, a színes kereszt a valódi középpont; különbségük a regresszált
$(\Delta x,\Delta y)$ offset. - Osztálycsatornák: minden osztály saját heatmap-csatornát kap. Az adott GT objektum csak a saját osztályának csatornáján hoz létre Gauss-foltot.
- Heatmap és bbox-fej: a heatmap csak az osztályt és a középpontot tanítja. Ugyanazon a kiválasztott helyen a külön regressziós ágak tanulják a pontos offsetet, a magasságot, a méretet, az orientációt és a sebességet.
A GT doboz körvonala az ábrán a geometriai kapcsolatot mutatja. A heatmap célja nem tölti ki a doboz teljes belsejét: csak a középpont környezetében pozitív.
Szemléltető, nem méretarányos cél-hőtérkép egy objektum körül:
| 0,00 | 0,02 | 0,05 | 0,02 | 0,00 |
| 0,02 | 0,18 | 0,42 | 0,18 | 0,02 |
| 0,05 | 0,42 | 1,00 | 0,42 | 0,05 |
| 0,02 | 0,18 | 0,42 | 0,18 | 0,02 |
| 0,00 | 0,02 | 0,05 | 0,02 | 0,00 |
A sugár nem minden objektumnál azonos. A gaussian_radius() a doboz BEV-méretéből és az előírt minimális átfedésből számítja, majd a config min_radius alsó korlátot alkalmaz. Egy nagy busz így szélesebb, egy kis gyalogos szűkebb célfoltot kaphat.
Egy
ahol out_size_factor. A cél Gauss-folt középpontja az egész
cella, a tört részt pedig külön regressziós fej tanulja:
Ez a felbontás nem korlátozza
A pontfelhő nagy részén nincs objektumközéppont, tehát rendkívül sok a könnyű negatív cella. A szokásos bináris keresztentrópiát ezek dominálnák. A Gaussian Focal Loss a nehéz példákra helyezi a hangsúlyt:
Itt
- A jól felismert pozitív és könnyű negatív helyek súlya lecsökken.
- A középpont körüli nagy
$Y$ értékű helyek kisebb negatív büntetést kapnak. - A ritka, elrontott középpontok erős tanulási jelet adnak.
A hőtérkép csak a BEV-középpontot és az osztályt adja. Egy teljes nuScenes 3D dobozhoz további mennyiségek szükségesek:
A CenterHead több kis konvolúciós ágon, minden hőtérképpozícióhoz az alábbi tenzorokat prediktálja:
| Fej | Csatorna | Jelentés |
|---|---|---|
reg |
2 |
|
height |
1 | a doboz |
dim |
3 | |
rot |
2 | |
vel |
2 |
|
| Összes regressziós csatorna | 10 | egy 3D állapot kódolt leírása |
flowchart TB
	X["Közös 384 x 128 x 128<br/>BEV feature map"] --> SH["3 x 3 shared conv<br/>64 csatorna"]
	SH --> HM["heatmap<br/>C x H x W"]
	SH --> O["reg<br/>2 x H x W"]
	SH --> Z["height<br/>1 x H x W"]
	SH --> D["dim<br/>3 x H x W"]
	SH --> R["rot<br/>2 x H x W"]
	SH --> V["vel<br/>2 x H x W"]
A dobozméretek pozitívak. A hálózat korlátlan valós számot regresszál, majd dekódoláskor exponenciálist alkalmaz:
Így a dekódolt méret biztosan pozitív, és a loss inkább relatív, mint abszolút méreteltérést érzékel. Egy 0,2 méteres hiba egy gyalogoson fontosabb, mint ugyanekkora eltérés egy buszon.
A szög periodikus:
A dobozfejek minden cellában adnak értéket, de ground-truth doboz csak a valódi objektumközéppontok indexein tanítja őket. A CenterHead kigyűjti ezeket a pozíciókat, és súlyozott L1 hibát számít:
A használt config kódsúlyai:
Vagyis a két sebességkomponens kisebb súlyt kap, mint a pozíció, méret és irány komponensei. A config ezenfelül loss_weight=0.25 szorzót állít a teljes regressziós lossra.
Feladatonként a veszteség:
A nuScenes tíz osztályát a config hat taskba csoportosítja. Minden tasknak saját heatmap- és regressziós feje van; a végső loss ezek feladatonkénti összege.
Inferenciakor nincs ground-truth index, ezért a hőtérkép csúcsai választják ki a vizsgálandó helyeket.
flowchart LR
	HM["Heatmap sigmoid"] --> TOP["Feladatonként Top-K<br/>K = 500"]
	TOP --> G["A regressziós értékek<br/>kigyűjtése ugyanott"]
	G --> M["Rácskoordináta<br/>→ méteres koordináta"]
	M --> BOX["x,y,z,dx,dy,dz,<br/>yaw,vx,vy"]
	BOX --> F["score- és<br/>tartományszűrés"]
	F --> NMS["Circle NMS"]
	NMS --> O["Végső 3D detekciók"]
Ha a kiválasztott cella
Számpélda. Legyen egy objektum valódi középpontja
A hőtérkép csúcsa a
A bbox coder ekkor még a doboz gravitációs középpontjának CenterHead.predict_by_feat() a taskok egyesítésekor levonja a magasság felét,
így a kimenet az MMDetection3D LiDARInstance3DBoxes alsó-középpont alapú konvenciójához igazodik.
Közeli hőtérképcsúcsok ugyanahhoz az objektumhoz több dobozt adhatnak. A notebook konfigurációja circle NMS-t használ: score szerint haladva megtartja a legerősebb jelöltet, majd az adott taskhoz tartozó minimális BEV-középpont-távolságon belüli gyengébb jelölteket elnyomja.
Ez eltér a képi detektorokból ismert IoU-alapú NMS-től:
- gyors, mert csak a középpontok távolságát vizsgálja;
- illeszkedik a center-based reprezentációhoz;
- osztálycsoportonként eltérő sugár állítható be, mert egy busz és egy gyalogos tipikus távolságskálája más.
| Tanítás | Inference |
|---|---|
| Ground-truth dobozból Gauss heatmap készül | Sigmoid után a heatmap Top-K csúcsait választjuk |
| A középpont cellaindexe ismert | A cellaindexet a heatmap becsli |
| A dobozkód csak a valódi középpontoknál kap L1 losst | A dobozfejek értékeit a kiválasztott csúcsoknál gyűjtjük ki |
| Gaussian Focal Loss + súlyozott L1 | Dekódolás + score-szűrés + NMS |
| A cél a paraméterek frissítése | A kimenet bboxes_3d, scores_3d, labels_3d
|
A CenterPoint ugyanazt a backbone--neck--head gondolkodást használja, mint a képi detektorok:
- a backbone egyre nagyobb környezetből tanul geometriai mintákat;
- a neck több felbontási szintet egyesít;
- a klasszifikációs fej itt osztályonkénti középpont-hőtérképet készít;
- a regressziós fej itt 2D doboz helyett 3D dobozt, orientációt és sebességet ad;
- az utófeldolgozás továbbra is score-szűréssel és NMS-sel választja ki a végső objektumokat.
Az új elem nem a CNN alapelve, hanem a pontfelhő pszeudoképpé alakítása és a 3D geometria megfelelő kódolása.
A gyakorlati notebook azt mutatja meg, hogyan kell futtatni egy teljes CenterPoint munkafolyamatot. Ez a fejezet azt mutatja meg, hol és hogyan kell tájékozódni a keretrendszerben, amikor később konfigurációt módosítunk, hibát keresünk vagy új komponenst írunk.
Az MMDetection3D nem önálló monolit. Több OpenMMLab csomag egymásra épül:
flowchart TB
	APP["Saját kísérlet<br/>config + adatok + checkpoint"] --> M3D["MMDetection3D<br/>3D datasetek, modellek, metrikák"]
	M3D --> MDET["MMDetection<br/>lossok, detekciós segédosztályok"]
	M3D --> MMCV["MMCV<br/>CNN modulok, CUDA operátorok"]
	M3D --> MME["MMEngine<br/>Config, Registry, Runner, Hook"]
	MDET --> MMCV
	MDET --> MME
	MMCV --> TORCH["PyTorch"]
	MME --> TORCH
- MMEngine: általános tanítási motor. Kezeli a configot, registryket, runnert, hookokat, naplózást és checkpointokat.
- MMCV: gyakori CNN építőelemeket és optimalizált CPU/CUDA operátorokat ad.
- MMDetection: általános objektumdetekciós komponenseket, például lossokat és bbox segédeszközöket biztosít.
- MMDetection3D: 3D adatkészleteket, pontfelhő-transzformációkat, 3D modelleket, dobozstruktúrákat, metrikákat és vizualizációt ad hozzá.
Ezért fordul elő például a configban type='mmdet.GaussianFocalLoss': a 3D fej az MMDetectionben regisztrált losst használja.
A configban szereplő értékek többsége hiperparaméter: ezeket mi állítjuk be a futás előtt. Nem azonosak a hálózat tanult paramétereivel, vagyis a súlyokkal és biasokkal, amelyeket a tanítás módosít.
| Fogalom | Jelentés ebben az anyagban |
|---|---|
| minta / sample | Egy időponthoz tartozó, előfeldolgozott pontfelhő és tanításkor a hozzá tartozó GT annotáció. |
| batch | Több minta, amelyen a modell egyszerre fut. A batch_size=2 GPU-nként két mintát jelent. |
| iteráció | Egy batch előremenete, loss-számítása, visszaterjesztése és egy optimizer-lépése. |
| epoch | A teljes train adathalmaz egyszeri bejárása. Egy epoch sok iterációból áll. |
| loss / veszteség | Egy skalár, amely számszerűsíti a predikció és a ground truth eltérését. Ebből számolódik a gradiens. |
| optimizer | A gradiensek alapján frissíti a tanult súlyokat. A példában AdamW. |
| learning rate (LR) | A súlyfrissítés lépésméretének fő skálája. Túl nagy érték instabil, túl kicsi érték lassú tanulást okozhat. |
| scheduler | A learning rate-et változtatja a tanítás során. |
| dataloader | Mintákat olvas, meghívja az adatpipeline-t, majd batcheket állít össze. |
| train / val / test | A train split tanítja a súlyokat; a val split modellválasztásra; a test split egyszeri végső mérésre szolgál. |
| checkpoint | A modell tanult súlyait és gyakran a futás állapotát tartalmazó .pth fájl. |
| hook | A tanítás meghatározott pontjain automatikusan lefutó kiegészítő, például logolás vagy checkpoint-mentés. |
Egyszerűsítve, egy GPU esetén az iterációk száma egy epochban:
Több GPU esetén az effektív globális batch közelítőleg
Ez azért fontos, mert a fájlnévben szereplő 8xb4 nyolc GPU-t és GPU-nként négy mintát, vagyis 32 mintás referencia-batchet jelent. Egyetlen Colab GPU-n batch_size=2 ettől eltérő optimalizálási helyzet.
flowchart LR
	D["Dataset<br/>fájlok + annotáció"] --> P["Pipeline<br/>betöltés, augmentáció, csomagolás"]
	P --> L["DataLoader<br/>batch összeállítása"]
	L --> DP["Data preprocessor<br/>GPU-ra másolás, voxelizálás"]
	DP --> M["Model forward<br/>pillar → backbone → head"]
	M --> LOSS["Loss<br/>heatmap + bbox"]
	LOSS --> B["Backward<br/>gradiensek"]
	B --> O["Optimizer step<br/>súlyfrissítés"]
	O --> H["Hookok<br/>log, scheduler, checkpoint"]
- A dataset megadja, hol található egy minta és az annotációja.
- A pipeline betölti és tanításkor véletlenszerűen augmentálja az adatot.
- A dataloader több mintából batchet készít.
- A data preprocessor GPU-ra mozgatja az adatot és a pontokat pillarokba rendezi.
- A modell elkészíti a heatmap- és dobozpredikciókat.
- A loss összehasonlítja ezeket a ground truth célokkal.
- A backpropagation gradienst számít, az optimizer pedig módosítja a súlyokat.
- A hookok naplóznak, learning rate-et módosítanak vagy checkpointot mentenek.
Validáció és inferencia közben nincs backward() és optimizer-lépés: a súlyok nem változnak.
Az alábbi fa a helyi /home/dot1bp/git/mmdetection3d repo munkához legfontosabb részeit emeli ki:
mmdetection3d/
├── configs/
│   ├── _base_/
│   │   ├── datasets/          # dataset, pipeline, dataloader, evaluator
│   │   ├── models/            # architektúrák alapkonfigurációi
│   │   ├── schedules/         # optimizer, LR schedule, epochok
│   │   └── default_runtime.py # hookok, logolás, futtatási környezet
│   ├── centerpoint/           # CenterPoint kísérleti configok
│   └── pointpillars/          # PointPillars kísérleti configok
├── mmdet3d/
│   ├── apis/                  # init_model, inference_detector stb.
│   ├── datasets/              # dataset osztályok és transzformációk
│   ├── engine/                # hookok, runner-kiegészítések
│   ├── evaluation/            # KITTI, nuScenes és más metrikák
│   ├── models/
│   │   ├── detectors/         # teljes detektorok és adatútjuk
│   │   ├── voxel_encoders/    # pontok → voxel/pillar jellemzők
│   │   ├── middle_encoders/   # sparse tensor vagy pszeudokép
│   │   ├── backbones/         # SECOND, DGCNN stb.
│   │   ├── necks/             # SECONDFPN és más feature-aggregátorok
│   │   ├── dense_heads/       # CenterHead és más detekciós fejek
│   │   └── task_modules/      # bbox coderek, assignerek, priorok
│   ├── structures/            # 3D dobozok, pontok, data sample
│   ├── visualization/         # 3D vizualizáció
│   └── registry.py            # MMDetection3D registryk
├── tools/
│   ├── train.py               # tanítás belépési pontja
│   ├── test.py                # teszt és kiértékelés
│   ├── create_data.py         # nyers dataset előkészítése
│   └── misc/print_config.py   # összeolvasztott config kiírása
├── projects/                  # kísérleti vagy külső bővítmények
├── tests/                     # automatikus tesztek
└── docs/                      # felhasználói és fejlesztői dokumentáció
| Kérdés | Elsőként vizsgálandó hely |
|---|---|
| Milyen fájlokat és augmentációt kap a modell? |
configs/_base_/datasets/ és mmdet3d/datasets/transforms/
|
| Milyen rétegekből áll a háló? | configs/_base_/models/ |
| Hol állítom az LR-t vagy az epochszámot? |
configs/_base_/schedules/ és a kísérleti config |
| Hol képződik a heatmap target? | mmdet3d/models/dense_heads/centerpoint_head.py |
| Hol lesz a heatmapből méteres 3D doboz? | mmdet3d/models/task_modules/coders/centerpoint_bbox_coders.py |
| Miért nem töltődik be egy komponens? | az adott registry.py, __init__.py és a config type mezője |
| Mi fut le tanításkor? |
tools/train.py → MMEngine Runner → modell loss()
|
Az MMDetection3D config nem pusztán paraméterlista. Egy Python fájl, amely egymásba ágyazott szótárakkal egy teljes kísérletet ír le:
A behúzás parent--child kapcsolatot jelent. Például:
model = dict(
	pts_bbox_head=dict(
		loss_bbox=dict(
			type='mmdet.L1Loss',
			loss_weight=0.25,
		),
	),
)
A loss_weight teljes kulcsútvonala:
model.pts_bbox_head.loss_bbox.loss_weight
Ezt balról jobbra így olvassuk: a modellen belül → a pontfelhő bbox headben → a bbox lossban → a loss súlya. A pontozott alak nem feltétlenül szerepel szó szerint a fájlban, de dokumentációban és parancssori felülíráskor így hivatkozunk rá.
| Configrész | Mit épít vagy vezérel? | Tipikus kérdés |
|---|---|---|
model |
A neurális hálózat moduljai, lossai és modellezési train/test beállításai. | Milyen a pillar mérete, a backbone vagy a detekciós fej? |
train_dataloader |
A train dataset, pipeline, sampler, batchméret és CPU workerszám. | Melyik info-fájlból és hány mintát töltünk egyszerre? |
val_dataloader, test_dataloader
|
A validációs és tesztadatok betöltése, véletlen train augmentáció nélkül. | Melyik spliten mérünk? |
val_evaluator, test_evaluator
|
A predikciókból metrikát számító objektum. | NuScenes mAP/NDS vagy más metrika készüljön? |
optim_wrapper |
Optimizer, gradiensvágás és vegyes pontosság körüli logika. | Hogyan frissüljenek a tanult súlyok? |
param_scheduler |
A learning rate időbeli változása. | Mikor és mennyire csökkenjen az LR? |
gyökérszintű train_cfg
|
A Runner tanítási ciklusa. | Hány epoch legyen, milyen gyakran validáljunk? |
default_hooks |
Logolás, checkpoint, időmérés és más automatikus műveletek. | Hány iterációnként írjunk logot? |
load_from, resume
|
A futás kezdőállapota. | Előre tanított súlyból indulunk vagy félbeszakadt futást folytatunk? |
Az azonos név ellenére két külön szint létezik:
model = dict(
	train_cfg=dict(
		pts=dict(max_objs=500, min_radius=2),
	),
)

train_cfg = dict(max_epochs=20, val_interval=20)- A
model.train_cfg.ptsa CenterHead számítását szabályozza: például hány GT objektumot kezeljen és mekkora legyen a minimális Gauss-sugár. - A gyökérszintű
train_cfga Runner ciklusát szabályozza: például hány epochig fusson és mikor validáljon.
Ez gyakori hibaforrás: az epochszámot nem a model.train_cfg alatt kell keresni.
A notebook belépési configja:
configs/centerpoint/
└── centerpoint_pillar02_second_secfpn_head-circlenms_8xb4-cyclic-20e_nus-3d.py
	└── centerpoint_pillar02_second_secfpn_8xb4-cyclic-20e_nus-3d.py
		├── ../_base_/datasets/nus-3d.py
		├── ../_base_/models/centerpoint_pillar02_second_secfpn_nus.py
		├── ../_base_/schedules/cyclic-20e.py
		└── ../_base_/default_runtime.py
flowchart TB
	D["datasets/nus-3d.py<br/>pipeline, dataloader, evaluator"] --> E["pillar02...nus-3d.py<br/>konkrét kísérlet"]
	M["models/centerpoint_pillar02...py<br/>hálózat, loss, coder"] --> E
	S["schedules/cyclic-20e.py<br/>AdamW, LR, 20 epoch"] --> E
	R["default_runtime.py<br/>hookok, logolás"] --> E
	E --> N["...head-circlenms...py<br/>NMS felülírás"]
	N --> F["Végleges összeolvasztott config"]
Az _base_ lista betölti a parent configokat. A child configban megadott értékek rekurzívan felülírják az azonos kulcsokat. Így az utolsó fájl mindössze ezt módosítja:
_base_ = [
	'./centerpoint_pillar02_second_secfpn_8xb4-cyclic-20e_nus-3d.py'
]

model = dict(test_cfg=dict(pts=dict(nms_type='circle')))
A teljes modell ettől még tartalmazza a pillar encodert, a SECOND backbone-t, a SECONDFPN neck-et és a CenterHeadet: ezeket az öröklési lánc adja hozzá.
Alapesetben a beágyazott szótárak összeolvadnak:
# A parent config többi optimizer mezője megmarad, csak az lr változik.
optim_wrapper = dict(optimizer=dict(lr=5e-5))
Ha egy teljes részfát le akarunk cserélni, _delete_=True szükséges:
optim_wrapper = dict(
	_delete_=True,
	type='OptimWrapper',
	optimizer=dict(type='AdamW', lr=5e-5, weight_decay=0.01),
	clip_grad=dict(max_norm=10, norm_type=2),
)
Ez különösen fontos, ha a child configban nem ugyanazt a komponenstípust használjuk, mint a parent configban.
Egy config-részlet:
pts_bbox_head=dict(
	type='CenterHead',
	in_channels=384,
	loss_cls=dict(type='mmdet.GaussianFocalLoss', reduction='mean'),
)
nem közvetlen konstruktorkód. A registry megkeresi a CenterHead néven regisztrált osztályt, majd a többi mezőt konstruktorargumentumként átadja neki:
flowchart LR
	C["config dict<br/>type = CenterHead"] --> R["MODELS registry"]
	R --> K["CenterHead osztály"]
	K --> O["példányosított modul"]
Az osztály feletti @MODELS.register_module() dekorátor teszi elérhetővé a nevet. Egy tipikus „ismeretlen type” hiba ezért nem feltétlenül elírás: az is lehet, hogy az osztályt tartalmazó modul nem importálódott.
A hosszú fájlnév tömör kísérleti leírás:
centerpoint_pillar02_second_secfpn_head-circlenms_8xb4-cyclic-20e_nus-3d.py
| Rész | Jelentés |
|---|---|
centerpoint |
detektor |
pillar02 |
pillar reprezentáció, 0,2 m-es BEV-cella |
second |
backbone |
secfpn |
neck |
head-circlenms |
CenterHead és circle NMS változat |
8xb4 |
referenciafutás: 8 GPU, GPU-nként 4 minta |
cyclic-20e |
ciklikus/cosine schedule, 20 epoch |
nus-3d |
nuScenes 3D detekció |
Az öröklés után létrejövő modellconfigot érdemes az adatút sorrendjében olvasni. Az alábbi értékek a notebookban használt pillar CenterPoint konfigurációból származnak.
| Kulcs | Érték | Mit jelent? | A változtatás fő hatása |
|---|---|---|---|
point_cloud_range |
[-51.2, -51.2, -5, 51.2, 51.2, 3] |
A feldolgozott LiDAR-tér: |
Nagyobb tartomány több objektumot fed le, de több cellát és számítást igényel. A tartományon kívüli pontokat és GT dobozokat a pipeline kiszűri. |
voxel_size |
[0.2, 0.2, 8] |
Egy pillar alapterülete |
Kisebb |
max_num_points |
20 |
Legfeljebb 20 pont marad egy pillarban; a hiányzó helyek paddinget kapnak. | Nagyobb érték több pontinformációt őrizhet, de növeli a voxelizált tenzor méretét. |
max_voxels |
(30000, 40000) |
Legfeljebb 30 000 nem üres pillar tanításkor és 40 000 tesztkor. A tuple sorrendje (train, test). |
Ha kevés, sűrű jelenetben pillarok veszhetnek el; ha nagy, nő a memória- és időigény. |
grid_size |
[512, 512, 1] |
A pillar-rács cellaszáma |
Származtatott érték: konzisztensnek kell lennie a tartománnyal és a voxelmérettel. |
A
Együtt változtatandó értékek:
point_cloud_range,voxel_size,grid_size,PointPillarsScatter.output_shape, a bbox coderpc_range/voxel_sizemezői és a pipeline range filterei ugyanazt a geometriát írják le. Egyetlen mező külön módosítása hibás alakot vagy eltolódott dobozokat okozhat.
| Kulcs | Érték | Mit szabályoz? |
|---|---|---|
pts_voxel_encoder.type |
PillarFeatureNet |
A pillaron belüli pontokat egy tanult vektorrá összegző modul típusa. |
in_channels |
5 |
A nyers pont öt bemeneti jellemzője: tipikusan |
feat_channels |
[64] |
A PFN kimenete pillaronként 64 szám. Több csatorna nagyobb reprezentációs kapacitást és több számítást jelent. |
with_distance |
False |
Nem fűzi hozzá külön skalárként a pont origótól mért euklideszi távolságát. |
norm_cfg |
BN1d |
Batch normalization stabilizálja a pontjellemzők skáláját a PFN-ben. |
pts_middle_encoder.type |
PointPillarsScatter |
A ritka pillar-vektorokat szabályos BEV-vászonra írja. |
output_shape |
(512, 512) |
A pszeudokép térbeli mérete. Az eredmény alakja batch nélkül |
Itt a 64 csatornaszám, nem osztályszám. A csatornák tanult jellemzők; egy-egy csatornának nincs előre rögzített fizikai jelentése.
| Kulcs | Érték | Kezdőbarát értelmezés |
|---|---|---|
pts_backbone.in_channels |
64 |
Meg kell egyeznie a pszeudokép csatornaszámával. |
out_channels |
[64, 128, 256] |
A három backbone-szint csatornaszáma. Mélyebben többféle tanult mintázat tárolható. |
layer_nums |
[3, 5, 5] |
A három szinten alkalmazott konvolúciós blokkok száma. Nagyobb érték mélyebb, lassabb modellt jelent. |
layer_strides |
[2, 2, 2] |
Minden szint első blokkja felezi a térbeli felbontást. A 512-es bemenetből rendre 256, 128 és 64 körüli felbontású feature map készül. |
pts_neck.in_channels |
[64, 128, 256] |
A neck az előbbi három backbone-kimenetet várja. |
out_channels |
[128, 128, 128] |
Mindhárom léptéket 128 csatornára alakítja. |
upsample_strides |
[0.5, 1, 2] |
Az első szintet tovább csökkenti, a másodikat változatlanul hagyja, a harmadikat felnagyítja, hogy mindhárom |
A neck a három, egyenként 128 csatornás térképet összefűzi:
ezért a CenterHead.in_channels=384. Ha egy korábbi modul csatornaszáma változik, a következő modul bemeneti csatornaszámát is hozzá kell igazítani.
| Kulcs | Érték | Mit jelent? |
|---|---|---|
tasks |
6 csoport, összesen 10 osztály | A hasonló osztályokat közös task head kezeli, például truck és construction_vehicle. Minden tasknak külön heatmapje és regressziós ágai vannak. |
share_conv_channel |
64 |
A neck 384 csatornáját egy közös 64 csatornás reprezentációvá alakítja a task headek előtt. Nagyobb érték több paramétert és GPU-memóriát jelent. |
num_heatmap_convs |
alapértéke 2
|
Ennyi konvolúcióból áll egy task heatmap-ága. A modellconfig nem írja ki, ezért az osztály konstruktorának alapértéke érvényesül. |
common_heads.reg |
(2, 2) |
Két offsetérték, két konvolúcióval előállítva. A párok alakja (kimeneti csatornák, konvolúciók száma). |
height |
(1, 2) |
Egy |
dim |
(3, 2) |
Három log-méret: |
rot |
(2, 2) |
Két iránykomponens: |
vel |
(2, 2) |
Két síkbeli sebességkomponens: |
loss_cls |
GaussianFocalLoss |
A ritka középponti heatmap tanítására szolgál. |
loss_bbox.loss_weight |
0.25 |
A teljes bbox L1 loss szorzója a heatmap losshoz képest. |
norm_bbox |
True |
A méreteket logaritmikus térben tanítja; dekódoláskor exponenciális visszaalakítás történik. |
A regressziós head 10 csatornát tanít, de a dekódolt nuScenes doboz code_size=9: a két rotációs csatornából atan2 után egyetlen yaw érték lesz.
| Kulcsútvonal | Érték | Szerep |
|---|---|---|
model.train_cfg.pts.out_size_factor |
4 |
A heatmap térbeli lépése négyszerese a pillar méretének: |
max_objs |
500 |
Legfeljebb ennyi GT objektum kap regressziós célt egy mintában. |
gaussian_overlap |
0.1 |
A gaussian_radius() dobozméretből számított sugarának egyik feltétele. |
min_radius |
2 |
A target heatmap Gauss-foltjának minimális sugara feature-map cellában. Ez tanítási paraméter. |
code_weights |
nyolc 1.0, két 0.2
|
Az offset, magasság, méret és rotáció teljes súlyt, a két sebességkomponens kisebb súlyt kap. |
bbox_coder.max_num |
500 |
Taskonként legfeljebb ennyi heatmap-csúcs kerül dekódolásra. |
bbox_coder.score_threshold |
0.1 |
A gyengébb jelöltek még NMS előtt kiesnek. Nagyobb küszöb kevesebb fals pozitívat, de több kihagyott objektumot okozhat. |
bbox_coder.out_size_factor |
4 |
A rácskoordináták méterre alakításához ugyanazt a skálát kell használnia, mint a targetképzésnek. |
post_center_range |
[-61.2, -61.2, -10, 61.2, 61.2, 10] |
A dekódolás után csak ezen, a bemeneti ponttartománynál szándékosan tágabb utószűrési térfogaton belüli dobozok maradnak meg. Ez bbox-középpontokra vonatkozó szűrő, nem a betöltött pontok tartománya. |
Az
out_size_factor=4értéknek a targetképzésben (model.train_cfg.pts), a tesztconfigban és a bbox coderben is egyeznie kell. Különben a tanítás és a dekódolás más fizikai helyet rendel ugyanahhoz a heatmap-cellához.
A modell alapconfigja rotate NMS-t tartalmaz. A notebook által használt legfelső child config ezt circle NMS-re írja felül:
model = dict(
	test_cfg=dict(
		pts=dict(nms_type='circle'),
	),
)| Kulcs | Érték | Hatás inferenciakor |
|---|---|---|
nms_type |
circle |
A jelöltek elnyomása a BEV-középpontok távolsága alapján történik. |
min_radius |
[4, 12, 10, 1, 0.85, 0.175] |
A hat task minimális középpont-távolsága méterben. A nagy járművek nagyobb, a gyalogos/traffic-cone task kisebb sugarat kap. |
pre_max_size |
1000 |
Legfeljebb ennyi legerősebb jelölt kerül az NMS elé. |
post_max_size |
83 |
NMS után taskonként legfeljebb ennyi jelölt marad; ez nem a hat task együttes kerete. |
score_threshold |
0.1 |
A test config score-küszöbe. Circle NMS-nél a bbox coder azonos célú küszöbe már a dekódolás során szűr. |
nms_thr |
0.2 |
A forgatott IoU-alapú NMS küszöbe; circle mód mellett ez a mező nem aktív. |
A
model.train_cfg.pts.min_radius=2és amodel.test_cfg.pts.min_radius=[...]nem ugyanaz. Az első Gauss-foltot rajzol feature-map cellákban tanításkor; a második center-distance NMS-t végez méterben inferenciakor.
A train dataloaderben a tényleges nuScenes datasetet egy mintavételi burkoló veszi körül:
train_dataloader.dataset                 → CBGSDataset burkoló
train_dataloader.dataset.dataset         → belső NuScenesDataset
train_dataloader.dataset.dataset.ann_file → az info-fájl neve
A CBGSDataset jelentése Class-Balanced Grouping and Sampling. Nem olvas új fájlformátumot; a belső dataset mintáit úgy ismétli/mintavételezi, hogy a ritkább osztálycsoportok gyakrabban kerüljenek batchbe. Ezért kell a saját ann_file értéket két dataset szint alatt megadni.
A pipeline lista sorrendje számít: minden transzformáció az előző kimenetét kapja.
| Transzformáció | Mit csinál? | Miért szükséges? |
|---|---|---|
LoadPointsFromFile |
Betölti az 5 dimenziós LiDAR-pontokat. | Ez hozza létre a modell nyers bemenetét. |
LoadAnnotations3D |
Betölti a GT 3D dobozokat és osztálycímkéket. | Ezekből készül a heatmap- és bbox-cél. |
ObjectSample |
Előre kivágott GT objektumpontokat másol a jelenetbe a ground-truth adatbázisból. | Növeli a ritka osztályok előfordulását; kizárólag train augmentáció. |
GlobalRotScaleTrans |
A teljes jelenetet és minden GT dobozt együtt forgatja és skálázza. | A modell kevésbé függjön egy pontos orientációtól vagy méretskálától. |
RandomFlip3D |
Véletlenszerűen tükrözi a BEV-jelenetet és a dobozokat. | További geometriai augmentáció. |
PointsRangeFilter |
Eldobja a point_cloud_range tartományon kívüli pontokat. |
A modell csak a konfigurált térrel dolgozzon. |
ObjectRangeFilter |
Eldobja a tartományon kívüli GT dobozokat. | A targetek ugyanabban a térben maradjanak, mint a pontok. |
ObjectNameFilter |
Csak a konfigurált class_names osztályokat tartja meg. |
Ismeretlen kategória ne kerüljön a head targetjei közé. |
PointShuffle |
Megkeveri a pontok sorrendjét. | A modell ne használhassa ki a fájl véletlen sorrendi sajátosságait. |
Pack3DDetInputs |
Szabványos inputs és Det3DDataSample szerkezetbe csomagol. |
Ezt az interfészt várja az MMEngine Runner és a modell. |
A val/test pipeline nem alkalmaz ObjectSample augmentációt és nem végez véletlen train transzformációkat. Kiértékeléskor ugyanazt a mintát mindig ugyanúgy kell a modellnek megkapnia.
Saját train splitnél az
ann_fileés azObjectSampleáltal használtdb_sampler.info_pathugyanahhoz a train splithez tartozzon. Ellenkező esetben validációs vagy tesztobjektum kerülhet a tanításba.
- Alakot változtat? Például csatornaszám módosításakor illeszkedik-e a következő réteg?
- Geometriát változtat? Például voxelméret módosításakor frissült-e minden kapcsolódó range/grid/coder mező?
- Checkpoint-kompatibilis? Egy réteg csatornaszámának módosítása után a régi súlytenzor alakja már nem illeszkedik.
-
Csak tanításra vagy inferenciára hat? Például
loss_weightnem változtatja a már elkészült modell predikcióját;score_thresholdnem tanítja újra a hálót.
A tools/train.py nem tartalmaz külön CenterPoint-specifikus tanítási ciklust. Ugyanaz a belépési pont sok különböző modellhez használható:
- A
Config.fromfile(...)beolvassa és összefésüli a_base_configokat. - Az MMEngine
Runnera végleges configból felépíti a modellt, dataloadereket, evaluatort, optimizert, schedulert és hookokat. - A
model.type='CenterPoint'alapján aMODELSregistry megkeresi aCenterPointPython-osztályt. - A
CenterPointparent osztályának konstruktora a beágyazotttypemezők alapján külön felépíti aPillarFeatureNet,PointPillarsScatter,SECOND,SECONDFPNésCenterHeadmodulokat. - Tanításkor a Runner a modell
loss()útját hívja, majd visszaterjesztést és optimizer-lépést végez. - Validációkor és tesztkor a
predict()út fut, amely dekódolt dobozokat ad; nincs súlyfrissítés.
flowchart LR
	C["Config.fromfile<br/>öröklés + felülírás"] --> R["Runner.from_cfg"]
	R --> REG["MODELS registry<br/>type = CenterPoint"]
	REG --> D["CenterPoint detektor"]
	D --> SUB["Almodulok buildelése<br/>encoder, backbone, neck, head"]
	SUB --> TRAIN["train: loss()"]
	SUB --> TEST["val/test: predict()"]
Ez a szétválasztás teszi lehetővé, hogy ugyanazt a modellt külön kézzel írt tréningciklus nélkül lehessen tanítani és tesztelni.
| Fájl | Fontos elem | Szerep |
|---|---|---|
mmdet3d/models/detectors/centerpoint.py |
CenterPoint |
Vékony detektorosztály; a komponenseket az örökölt detektorhoz továbbítja. |
mmdet3d/models/detectors/mvx_two_stage.py |
extract_pts_feat() |
Pillar encoder → scatter → backbone → neck adatút. |
| ugyanott | loss() |
Jellemzőkinyerés után meghívja a bbox head lossát. |
| ugyanott | predict() |
Jellemzőkinyerés után meghívja a bbox head predikcióját, és Det3DDataSample objektumba csomagolja. |
Fontos kódolvasási tanulság: a CenterPoint osztály önmagában rövid, mert a tényleges előremenet jelentős részét a parent osztály implementálja. Ha csak a név szerinti osztályt olvassuk el, nem látjuk a teljes működést.
| Fájl | Metódus | Kapcsolat az 1. résszel |
|---|---|---|
mmdet3d/models/voxel_encoders/pillar_encoder.py |
PillarFeatureNet.forward() |
Kiszámítja a cluster- és pillar-center offseteket, maszkolja a paddinget, majd PFN rétegeket futtat. |
mmdet3d/models/middle_encoders/pillar_scatter.py |
PointPillarsScatter.forward_batch() |
A nem üres pillarok jellemzőit a |
A legfontosabb fájl:
mmdet3d/models/dense_heads/centerpoint_head.py
| Osztály/metódus | Mit érdemes benne megkeresni? |
|---|---|
SeparateHead.__init__() |
A reg, height, dim, rot, vel és heatmap konvolúciós ágak felépítése. |
SeparateHead.forward() |
A külön ágak kimeneti szótárának előállítása. |
CenterHead.forward_single() |
Közös konvolúció, majd taskonként külön fej futtatása. |
CenterHead.get_targets_single() |
Középpont rácskoordinátája, Gauss-sugár, heatmap rajzolása és a 10 elemű regressziós célvektor. |
CenterHead.loss_by_feat() |
Gaussian Focal Loss, regressziós kimenetek összefűzése, középponti értékek kigyűjtése, súlyozott L1. |
CenterHead.predict_by_feat() |
Sigmoid, bbox coder meghívása, circle vagy rotate NMS és a taskok eredményeinek egyesítése. |
A dekódolás külön task-modulban található:
mmdet3d/models/task_modules/coders/centerpoint_bbox_coders.py
| Metódus | Szerep |
|---|---|
_topk() |
Kiválasztja a legerősebb hőtérképpozíciókat és osztályukat. |
_transpose_and_gather_feat() |
A kiválasztott indexeknél kigyűjti a regressziós értékeket. |
decode() |
Offset, méret, irány és sebesség dekódolása; méteres koordináták és tartományszűrés. |
sequenceDiagram
	participant R as MMEngine Runner
	participant D as MVXTwoStageDetector
	participant P as Pillar + backbone + neck
	participant H as CenterHead
	R->>D: loss(batch_inputs, data_samples)
	D->>P: extract_pts_feat(...)
	P-->>D: BEV feature map
	D->>H: loss(features, data_samples)
	H->>H: forward()
	H->>H: get_targets_single()
	H->>H: loss_by_feat()
	H-->>R: loss_heatmap + loss_bbox
sequenceDiagram
	participant D as MVXTwoStageDetector
	participant H as CenterHead
	participant C as CenterPointBBoxCoder
	D->>H: predict(features, data_samples)
	H->>H: forward()
	H->>C: decode(heatmap, reg, height, dim, rot, vel)
	C-->>H: dobozjelöltek
	H->>H: circle_nms() / nms_bev()
	H-->>D: InstanceData
	D-->>D: add_pred_to_datasample()
A bevett megoldás nem egy meglévő model-zoo config átírása, hanem egy rövid child config létrehozása. Így látható marad, mit változtattunk, és az eredeti baseline reprodukálható.
Az alábbi példa akkor helyezhető a configs/centerpoint/centerpoint_pillar02_nus_custom.py fájlba, ha az alapconfig ugyanebben a mappában található:
# A teljes model-zoo kísérletet örököljük; lent csak az eltéréseket írjuk le.
_base_ = [
	'./centerpoint_pillar02_second_secfpn_head-circlenms_8xb4-cyclic-20e_nus-3d.py'
]

# Az útvonal a repository gyökeréhez képest értendő.
data_root = 'data/nuscenes/'

train_dataloader = dict(
	batch_size=2,              # GPU-nként 2 minta; az alapconfigban 4.
	num_workers=2,             # GPU-nként 2 CPU betöltőfolyamat; az alapban 4.
	persistent_workers=True,   # A workerek epochok között is életben maradnak.
	dataset=dict(
		# A külső dataset CBGSDataset, ezért a tényleges NuScenesDataset
		# beállításai a második `dataset` szint alatt találhatók.
		dataset=dict(
			data_root=data_root,
			ann_file='nuscenes_infos_train.pkl',  # A train minták info-fájlja.
		),
	),
)

# Validációkor batch_size=1 marad az alapconfigból; csak az adatútvonalat
# és az annotációs fájlt tesszük explicitté.
val_dataloader = dict(
	dataset=dict(
		data_root=data_root,
		ann_file='nuscenes_infos_val.pkl',
	),
)

# A példában a test ugyanazt a hivatalos mini_val splitet használja.
test_dataloader = val_dataloader

# Az evaluator ugyanahhoz a val info-fájlhoz és adatgyökérhez tartozzon.
val_evaluator = dict(
	data_root=data_root,
	ann_file=data_root + 'nuscenes_infos_val.pkl',
)
test_evaluator = val_evaluator

model = dict(
	pts_bbox_head=dict(
		# A következő két érték megegyezik az alapmodellel. Megmutatják, hol
		# állítható a head kapacitása, de így a checkpoint alakjai illeszkednek.
		share_conv_channel=64,   # Közös head feature csatornaszáma.
		num_heatmap_convs=2,     # Konvolúciók száma a heatmap ágban.

		# Csak a szorzót írjuk felül; a type='mmdet.L1Loss' öröklődik.
		loss_bbox=dict(loss_weight=0.5),  # Alapérték: 0.25.

		# A dekóder a 0.15 alatti jelölteket NMS előtt eldobja.
		bbox_coder=dict(score_threshold=0.15),  # Alapérték: 0.10.
	),
	test_cfg=dict(
		pts=dict(
			nms_type='circle',     # Középpont-távolság alapú NMS.
			post_max_size=100,     # Taskonként legfeljebb 100 doboz NMS után; alap: 83.
		),
	),
)

# A teljes örökölt optimizer-részfát lecseréljük, ezért kell a _delete_.
optim_wrapper = dict(
	_delete_=True,
	type='OptimWrapper',
	optimizer=dict(
		type='AdamW',
		lr=5e-5,                 # Kezdő learning rate; az alapérték 1e-4.
		betas=(0.9, 0.999),      # A gradiens mozgóátlagainak simítása.
		weight_decay=0.01,       # AdamW regularizációs erőssége.
	),
	clip_grad=dict(
		max_norm=10,             # A teljes gradiens L2 normájának felső korlátja.
		norm_type=2,
	),
)

# A lista lecseréli az örökölt kétfázisú, 20 epochos schedule-t.
param_scheduler = [
	dict(
		type='CosineAnnealingLR',
		T_max=4,                 # A cosine görbe hossza epochban.
		eta_min=5e-6,            # A learning rate alsó határa.
		begin=0,                 # Az első epochtól aktív.
		end=4,                   # A negyedik epoch végéig aktív.
		by_epoch=True,           # Epoch-egységben adjuk meg a tartományt.
		convert_to_iter_based=True,  # Iterációnként simán változtatja az LR-t.
	),
]

train_cfg = dict(
	by_epoch=True,             # Epochalapú tanítási ciklus.
	max_epochs=4,              # Rövid oktatási futás; az alapconfigban 20.
	val_interval=1,            # Minden epoch végén validál; az alapban 20.
)

default_hooks = dict(
	logger=dict(interval=20),  # 20 iterációnként ír logsort; az alapban 50.
	checkpoint=dict(
		interval=1,              # Minden epoch végén ment.
		max_keep_ckpts=2,        # Csak a két legutóbbi periodikus mentést tartja meg.
	),
)

# Finomhangolás: csak a modellsúlyokat tölti be, az optimizer új állapotból indul.
# Ezt a fájlt a gyakorlati notebook checkpoint-letöltő cellája hozza létre.
load_from = 'checkpoints/centerpoint_pillar02_nuscenes.pth'
resume = False
Ha a hivatalos train split helyett saját splitet használunk, az ann_file mellett az örökölt ObjectSample transzformáció db_sampler.info_path értékét is a saját train splitből készített ground-truth adatbázisra kell cserélni.
| Kulcs | Alap → példa | Gyakorlati következmény |
|---|---|---|
train_dataloader.batch_size |
4 → 2 |
Körülbelül feleannyi minta fér egyszerre a GPU-ra. Csökken a memóriaigény, de zajosabb lehet a gradiens és több iteráció kell egy epochhoz. |
num_workers |
4 → 2 |
Kevesebb párhuzamos CPU-folyamat tölt adatot. Gyenge CPU-n stabilabb lehet, gyors GPU mellett viszont adatbetöltési várakozást okozhat. |
persistent_workers |
True |
Nem indulnak újra a workerek minden epoch elején, ezért kisebb az epochváltás költsége. |
ann_file |
explicit train/val fájlok | Egyértelművé teszi, melyik split tanít és melyiken mérünk. |
A batch_size itt GPU-nkénti érték. Két GPU esetén a globális batch 4 lenne. Mivel az auto_scale_lr.enable=False öröklődik, a keretrendszer nem módosítja automatikusan a learning rate-et a batchmérethez; ezt nekünk kell megfontolni.
A child configban definiált
data_rootváltozó nem írja át automatikusan az alapconfigban korábban összeállított összes útvonalat. Más adatgyökér esetén külön ellenőrizzük a dataset, evaluator ésdb_samplerútvonalait is aprint_config.pykimenetében.
| Kulcs | Alap → példa | Értelmezés |
|---|---|---|
share_conv_channel |
64 → 64 |
Szándékosan nem változik, hogy az előre tanított head súlyainak alakja illeszkedjen. |
num_heatmap_convs |
2 → 2 |
Szintén checkpoint-kompatibilis marad. |
loss_bbox.loss_weight |
0.25 → 0.5 |
A bbox regressziós hiba kétszer akkora relatív súlyt kap. Ez csak tanításkor hat, és nem garantál automatikus javulást. |
bbox_coder.score_threshold |
0.10 → 0.15 |
Kevesebb, de átlagosan magabiztosabb jelölt jut az NMS-hez. Csökkenhet a fals pozitív detekciók száma, de több valódi objektum maradhat ki. |
post_max_size |
83 → 100 |
Circle NMS után taskonként több doboz maradhat. Ez csak felső korlát, nem jelenti azt, hogy mindig 100 dobozt kapunk. |
Ha a share_conv_channel értékét például 96-ra változtatnánk, a head súlytenzorainak alakja megváltozna. A 64 csatornára tanított checkpoint ezekbe a rétegekbe nem tölthető be közvetlenül; betöltéskor méret- vagy size mismatch hiba várható. Architektúrakísérletnél vagy kompatibilis checkpoint szükséges, vagy a módosított rétegeket újonnan kell inicializálni és külön kezelni a súlybetöltést.
-
AdamW: adaptív learning rate-et használ paraméterenként, a weight decay-t az Adam momentumfrissítésétől elkülönítve alkalmazza. -
lr=5e-5: az alap$10^{-4}$ felére csökkentett kezdő lépésméret. Finomhangoláskor ez óvatosabb súlyfrissítést ad. -
betas=(0.9, 0.999): a gradiens első és második momentumának simítási tényezői. Kezdő kísérletben célszerű ezeket változatlanul hagyni. -
weight_decay=0.01: regularizáció, amely visszafogja a súlyok korlátlan növekedését. -
clip_grad.max_norm=10: ha a teljes gradiens L2 normája 10 fölé nő, a keretrendszer visszaskálázza. Ez az instabil, nagy frissítések ellen véd.
A _delete_=True itt azt jelenti: ne próbáljuk mezőnként összefésülni az örökölt optim_wrapper szótárat, hanem a teljes optimizer-konfigurációt cseréljük le az itt láthatóra.
A cosine scheduler a learning rate-et közelítőleg koszinuszgörbe mentén csökkenti convert_to_iter_based=True miatt a változás nem négy nagy epochugrásban, hanem minden iteráció után simán történik.
| Kulcs | Jelentés |
|---|---|
max_epochs=4 |
Az adathalmaz négyszeri bejárása. Ez rövid működésellenőrző futás („smoke test”), nem teljes CenterPoint tanítás. |
val_interval=1 |
Minden epoch után lefut a validáció. Ez több idő, de korán látható a metrika trendje. |
logger.interval=20 |
Húsz tanítási iterációnként jelenik meg új logbejegyzés. Nem 20 mintát és nem 20 epochot jelent. |
checkpoint.interval=1 |
Minden epoch végén periodikus checkpoint készül. |
max_keep_ckpts=2 |
A tárhely védelmében a két legutóbbi periodikus checkpoint marad meg. |
| Beállítás | Modellsúly | Optimizer/scheduler állapot | Tipikus használat |
|---|---|---|---|
load_from='...pth', resume=False
|
betöltődik | új állapotból indul | finomhangolás vagy új kísérlet előre tanított modellből |
resume=True |
betöltődik | folytatódik | megszakadt azonos futás folytatása ugyanabból a work_dir-ből |
Finomhangoláskor azt szeretnénk, hogy a modell már tanult súlyokból induljon, de az új learning rate schedule az első epochtól fusson; ezért használjuk a példában a load_from + resume=False párost.
Néhány érték nem módosítható biztonságosan egyetlen helyen:
-
point_cloud_rangemegjelenik a voxel layerben, a pillar encoderben, a bbox coderben, a train/test configban és a pipeline szűrőiben; -
voxel_sizemeghatározza agrid_size, azoutput_shape, a feature map és a dekódolt koordináták kapcsolatát; -
out_size_factorugyanazt a leskálázást kell jelentse a targetképzésben és a bbox coderben; -
class_namessorrendjének egyeznie kell a dataset metainfo, az objektumszűrő és a CenterHeadtaskscsoportjai között; - saját train split esetén az
ann_filemellett azObjectSampleground-truth adatbázisát is ugyanabból a splitből kell felépíteni.
Ha például csak a bbox_coder.voxel_size változik, a hálózat ugyanazt a cellát más fizikai helyre dekódolja. Ez futás közben akár észrevétlen maradhat, miközben minden doboz eltolódik.
Módosítás után először mindig a teljes, összeolvasztott configot érdemes megvizsgálni:
python tools/misc/print_config.py \
  configs/centerpoint/centerpoint_pillar02_nus_custom.py
Tanítás:
python tools/train.py \
  configs/centerpoint/centerpoint_pillar02_nus_custom.py \
  --work-dir work_dirs/centerpoint_pillar02_nus_custom
Kiértékelés:
python tools/test.py \
  configs/centerpoint/centerpoint_pillar02_nus_custom.py \
work_dirs/centerpoint_pillar02_nus_custom/epoch_4.pth-
Config: a
print_config.pykimenetében tényleg a várt érték szerepel? -
Adat: a dataloader egy mintája tartalmaz
points,gt_bboxes_3désgt_labels_3dmezőt? - Alakok: a pillar encoder, scatter, backbone, neck és head csatornaszámai illeszkednek?
- Koordináták: az adatok, range filterek, targetképzés és coder ugyanazt a LiDAR-frame-et használják?
- Loss: végesek az értékek, és kap pozitív mintát a heatmap?
- Dekódolás: megfelelő a score-küszöb, a fizikai tartomány és az NMS?
- Metrika: ugyanazon spliten és azonos evaluatorral hasonlítjuk össze a kísérleteket?
| Elméleti anyag | Gyakorlati notebook |
|---|---|
| Miért kell pillar vagy voxel reprezentáció? | Telepíti és betölti a pillar CenterPoint modellt. |
| Hogyan készül a pszeudokép? | A config PillarFeatureNet és PointPillarsScatter elemeit használja. |
| Mit jelentenek a head kimenetei? | Megjeleníti a dekódolt dobozokat, score-okat és osztályokat. |
| Hogyan működik a célképzés és a loss? | Rövid finomhangolási futást készít elő. |
| Hogyan áll össze a config? | Saját train/val/test info-fájlokat és training configot hoz létre. |
| Hol található az implementáció? |
init_model, inference_detector, tools.train és tools.test API-kat futtat. |
| Mi a korrekt mérési protokoll? | Hivatalos nuScenes mini validációt és metrikákat használ. |
- A pontfelhő rendezetlen, ritka és változó elemszámú; a hagyományos CNN szabályos rácsot vár.
- A PointNet szimmetrikus poolinggal, a VoxelNet tanult 3D voxelreprezentációval, a PointPillars pedig pillarokból képzett 2D pszeudoképpel kezeli ezt az eltérést.
- A PointPillars pontonkénti relatív geometriai jellemzőket képez, pillárisonként maximumot számít, majd a vektorokat BEV-vászonra scattereli.
- A CenterPoint anchor-free módon osztályonkénti középpont-hőtérképet és a középpontokhoz tartozó 3D dobozparamétereket becsül.
- A heatmapet Gaussian Focal Loss, a középpontoknál kigyűjtött dobozkódot súlyozott L1 loss tanítja.
- A dekóder Top-K heatmap-csúcsból, offsetből, méretből, irányból és sebességből készít 3D dobozt, majd score-szűrést és NMS-t alkalmaz.
- Az MMDetection3D-ben a config írja le a kísérletet, a registry építi fel a komponenseket, az MMEngine Runner pedig megszervezi a tanítást és a kiértékelést.
- A configértékek többsége hiperparaméter; a tanult súlyokat a lossból számított gradiensek alapján az optimizer módosítja.
- A dataloader, modell, optimizer, scheduler, Runner és hookok külön felelősségű elemek, amelyeket a config kapcsol össze.
- A geometriai paramétereket, például a range, voxelméret, gridméret és dekódolási skála értékeit konzisztensen kell módosítani.
- A CenterPoint matematikai lényege főként a
centerpoint_head.pycélképző, loss- és predikciós metódusaiban, valamint acenterpoint_bbox_coders.pydekóderében követhető.
- PointNet: Deep Learning on Point Sets for 3D Classification and Segmentation
- VoxelNet: End-to-End Learning for Point Cloud Based 3D Object Detection
- PointPillars: Fast Encoders for Object Detection from Point Clouds
- Center-based 3D Object Detection and Tracking
- MMDetection3D dokumentáció
- MMEngine config dokumentáció
A kapcsolódó, Colabban is futtatható gyakorlati notebook: