3. óra Konvolúciós neurális hálózatok - CooperativeResearchPlatform/object_detection_for_aeb GitHub Wiki
1. Ismétlés
KAHOOT
Az elmúlt órán a fully connected (MLP - multilayer perceptron) neurális hálókat használtunk regressziós, illetve klasszifikációs feladatokra. A második órához tartozó notebookban így oldottunk meg kézírásos számfelismerést. Neurális hálózatok alapjai
Hogyan kezeltünk ebben az esetben egy 28x28 pixeles képet? Először egy 784 elemű vektorrá lapítottuk ki (flattening), és ezt töltöttük be az MLP első rétegbe.
2. Problémafelvetés: bemenetként nagy felbontású képeink vannak. És több rétegű neur.hálót szeretnénk használni a jó teljesítmény érdekében.
De! Ha nagy felbontású képünk van és fully connected neurhálókkal etetjük meg őket akkor rengeteg lesz a paraméterünk (felrobban) (exploding parameters).
ÖTLET: használjunk más neur.háló struktúrát. -> konvolúciós neur.háló -> kevesebb paraméter is elég, és mégis effektívebben is tanul.
Működése:
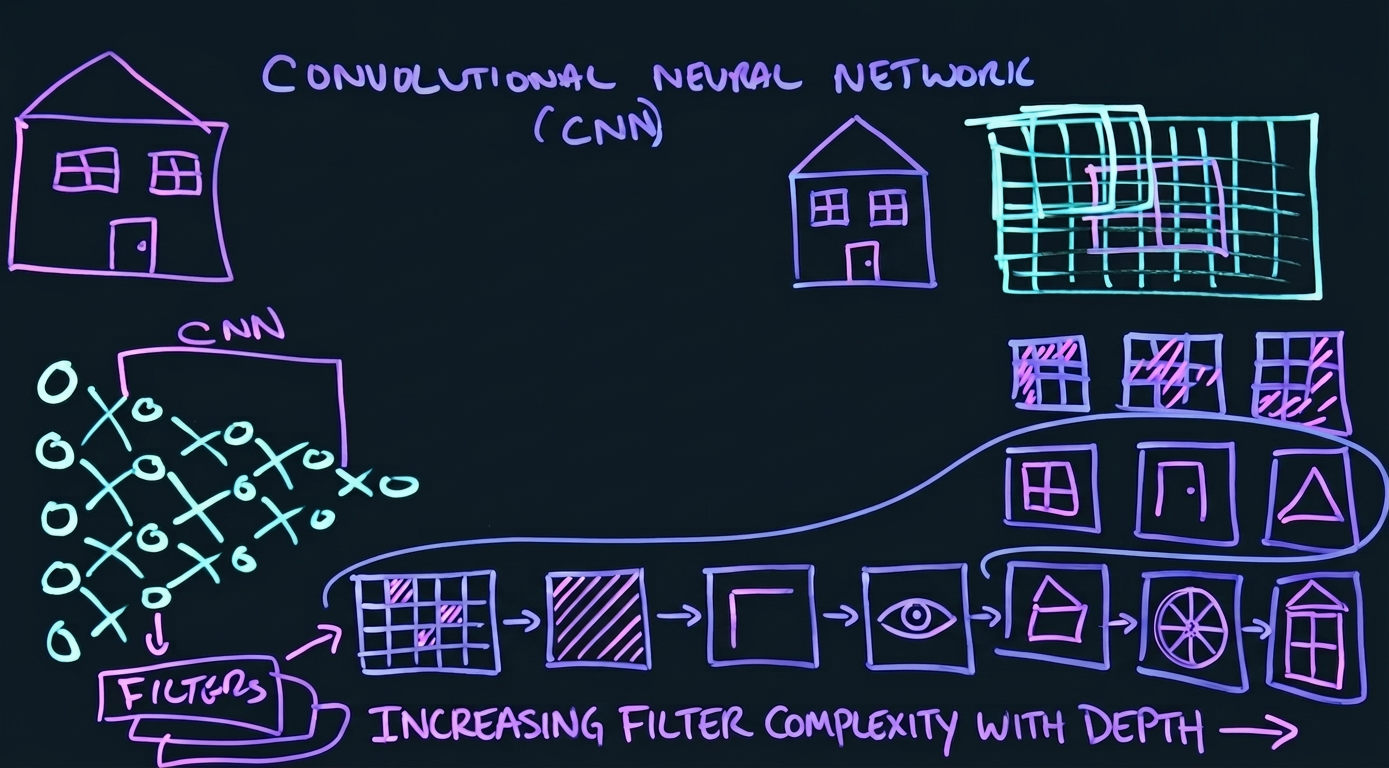
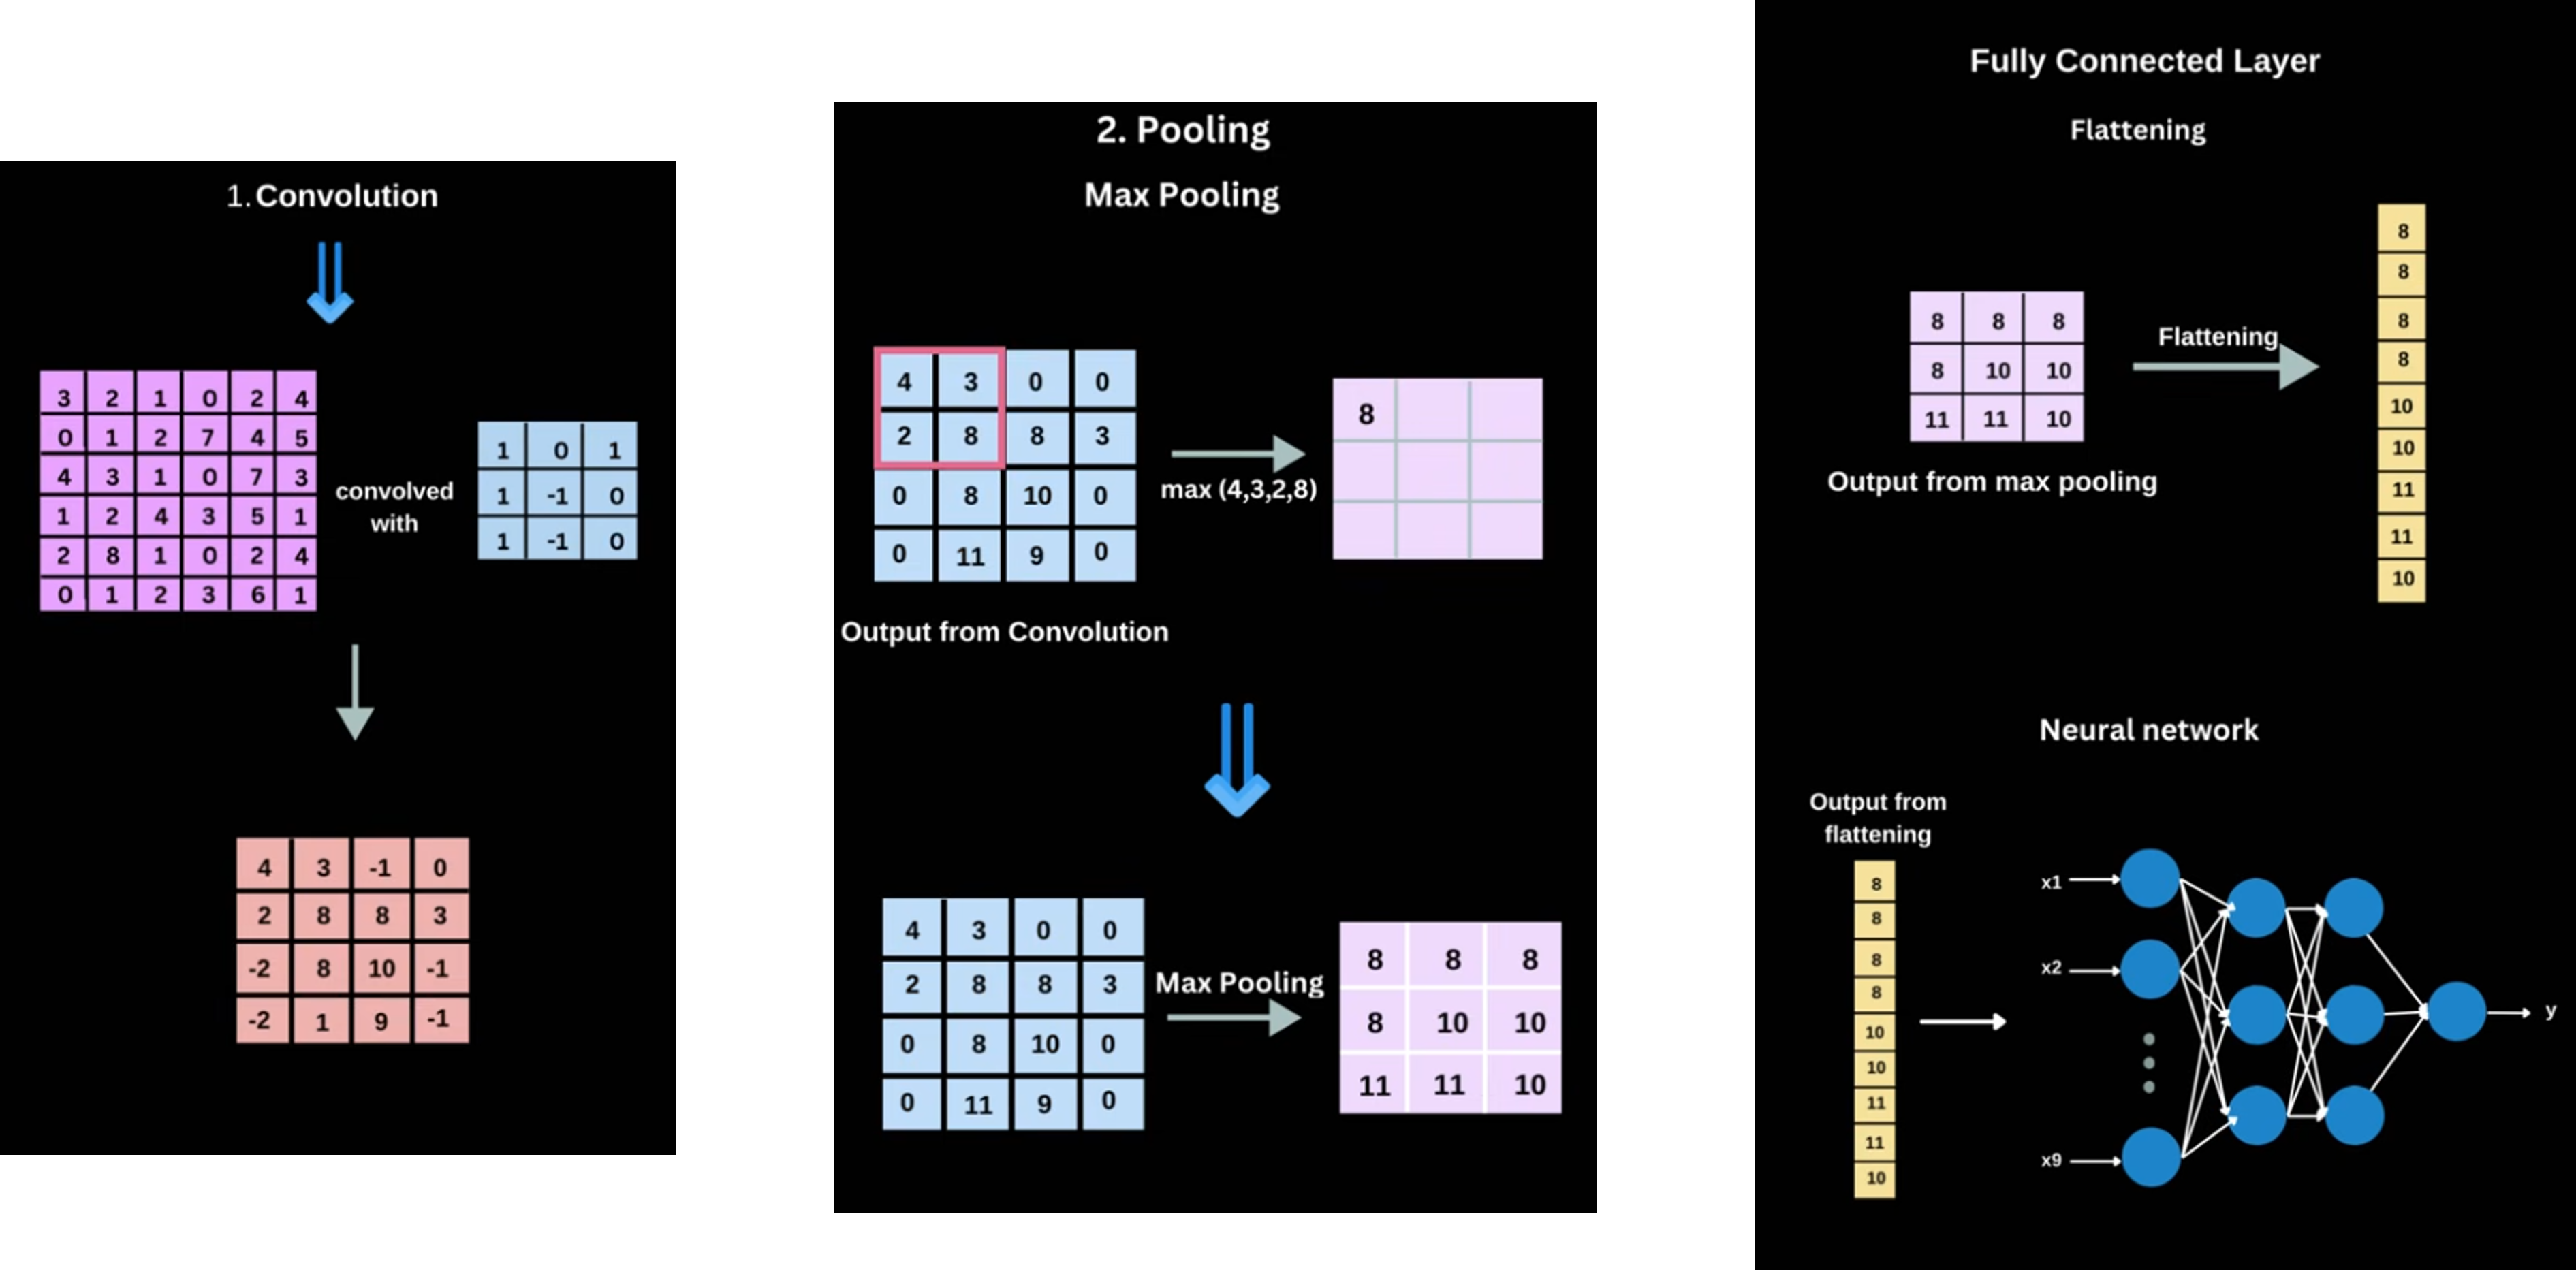
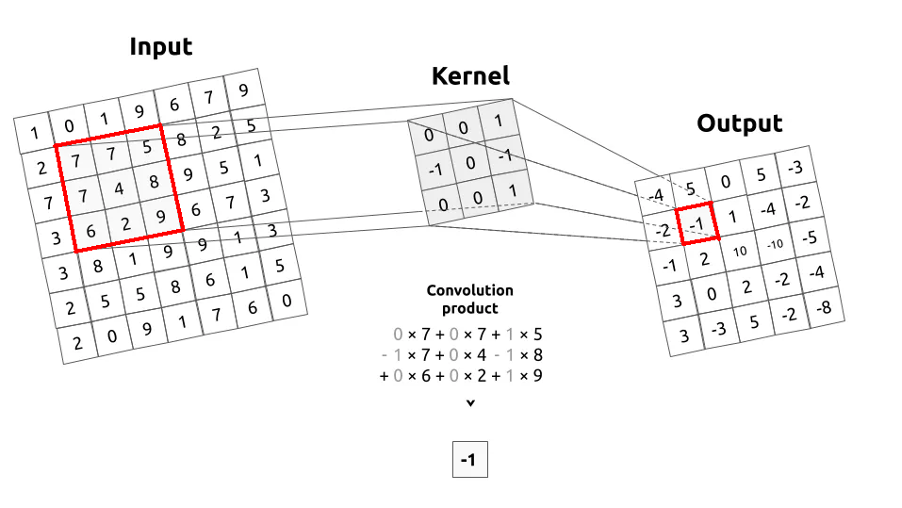
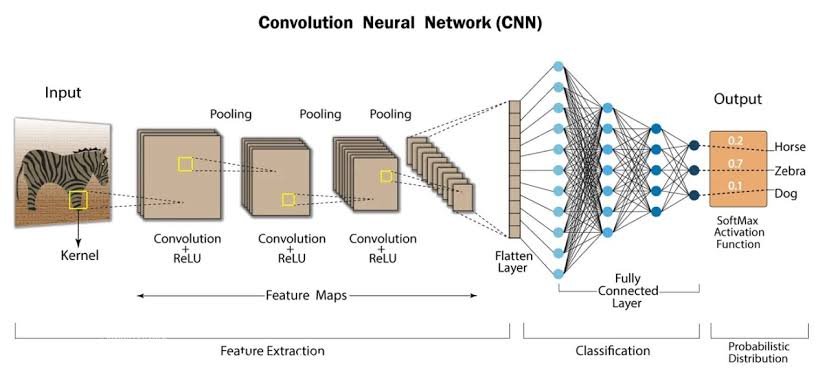
Konvolúciós szűrő: Apró mátrix szűrők (filterek / kernelek) csúsznak végig a bemeneti képen (vagy mélyebb rétegekkor az előző réteg kimenetén). A szűrő elemei és a kép éppen lefedett képpontjai között elemenkénti szorzást, majd összegzést végez a hálózat. Mi az értelme? Lokális minták felismerése: Ha a szűrő valamilyen jellegzetességet talál (pl élt) ott magas értéket ad vissza. Az első rétegek egyszerűbb formákat (vízszintes/függőleges élek, sarkok, színek), míg a mélyebb rétegek már komplexebb struktúrákat (szem, kerék, teljes arc vagy autó) azonosítanak. Paramétermegosztás: Mivel ugyanazt a szűrőt alkalmazzuk a kép minden részén, a hálózat kevesebb tanulandó paramétert igényel, mintha teljesen összekötött rétegeket használnánk. Eltolás-invariancia: Ha egy mintázat (pl. egy ház sarka) a kép egy másik részén is megjelenik, a szűrő ott is képes lesz felismerni azt.
Padding: A kép szélét kipaddeljük, azért hogy a kimeneti dimenzió ne csökkenjen szélességbe és magasságba.
Aktivációs réteg: A konvolúciós lépés után (mint ahogyan a fully connected lineáris része után is) egy nemlineáris aktivációs függvényt alkalmazunk. A leggyakoribb választás a ReLU (Rectified Linear Unit). Hogyan működik? A ReLU függvény végigpásztázza a konvolúció kimenetét, és minden negatív értéket nullára cserél, míg a pozitív értékeket változatlanul hagyja (f(x)=max(0,x)). Segít abban, hogy a hálózat bonyolult, nemlineáris összefüggéseket is meg tudjon tanulni.
Pooling (csökenti a diemnziókat): Hogyan működik? Egy rögzített ablak (például egy 2×2-es rács) végighalad a térképen, és csak a legmagasabb értéket (Max-Pooling) vagy az értékek átlagát (Average Pooling) tartja meg, a többit eldobja. Mi az értelme? Dimenziócsökkentés: Csökkenti a reprezentáció méretét, ezáltal kevesebb számítási kapacitásra és memóriára van szükség a következő rétegekben. +előny: nem növeljük a tanulható paraméterek számát.
Fully connected: Az adott réteg összes neuronja összeköttetésben áll a szomszédos rétegeinek neuronjaival. Ez a réteg a konvolúciós neur.hálók legvégén helyezkedik el (HEAD). Hogyan működik? A klasszifikációs problémakörnél maradva: Először a többdimenziós feature-mapet egyetlen hosszú, egydimenziós vektorrá lapítjuk (Flattening). Ezután ezt a vektort egy hagyományos, többrétegű perceptronhoz (MLP) csatlakoztatjuk, ahol minden bemeneti neuron össze van kötve minden kimeneti neuronnal. És annyi neuron van ahány osztály. Majd egy soft max-al valószínűségi eloszlássá alakítjuk. Mi az értelme? Osztályozás és döntéshozatal: Míg a korábbi rétegek (konvolúció és pooling) kinyerték a képből a fontos jellemzőket, a teljesen összekötött réteg feladata, hogy ezen jellemzők alapján meghozza a végső döntést (pl. "95% eséllyel kutya van a képen").
Matematika a konvolúciós háló felépítése mögött:
O=(I-K+2*P)/S+1
- O (kimenet)
- I (Input = WidthHeight): A bemenet szélességemagassága (pixelben).
- K (Kernel size): A szűrő (kernel) mérete.
- P (Padding): A margó/párnázás mérete (a kép széleihez adott extra pixelsorok száma).
- S (Stride): A lépésköz (hány pixellel ugrik odébb a szűrő minden lépésnél).
Példa:
- I = 28×28x3
- K = 5×5
- P = 2
- S = 1
O=28x28x3
3. Hogyan teljesítenek a konvolúciós neurháló architekturák?
A LeNet, a VGG16 és a ResNet a mélytanulás és a számítógépes látás fejlődésének három legmeghatározóbb mérföldkövét jelentő konvolúciós neurális hálózat (CNN) architektúrái. A fejlődésük jól mutatja, hogyan váltak a hálózatok egyre mélyebbé, és milyen matematikai, illetve strukturális innovációkra volt szükség a mélységből adódó mérnöki problémák leküzdésére.
- LeNet architektúra
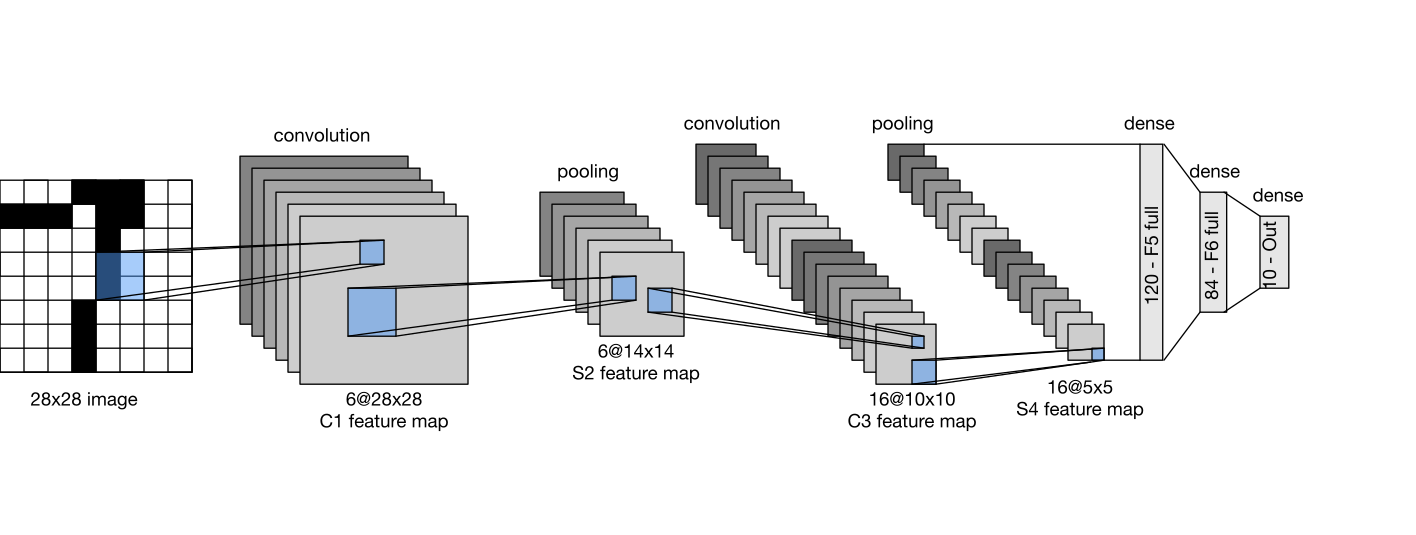
Yann LeCun és munkatársai fejlesztették ki az írott karakterek felismerésére az MNIST adatbázison. Fő jellemzők: Sekély hálózat: Összesen 5 rétegből áll (innen a LeNet-5 elnevezés), amelyből 2 konvolúciós (Convolutional) és 3 Fully Connected réteg. Aktivációs függvények: Eredetileg tanh és sigmoid függvényeket használt (a modernebb ReLU ekkor még nem volt elterjedt). Mintavételezés (Pooling): Average Pooling rétegeket alkalmazott a térbeli dimenziók csökkentésére. Jelentősége: Megalapozta a modern CNN-ek alapelveit (konvolúció, mintavételezés és súlymegosztás koncepciója). Mai szemmel nézve rendkívül kicsi a paraméterszáma (kb. 60 ezer paraméter), így modern hardvereken pillanatok alatt betanítható.
- VG16 architektúra
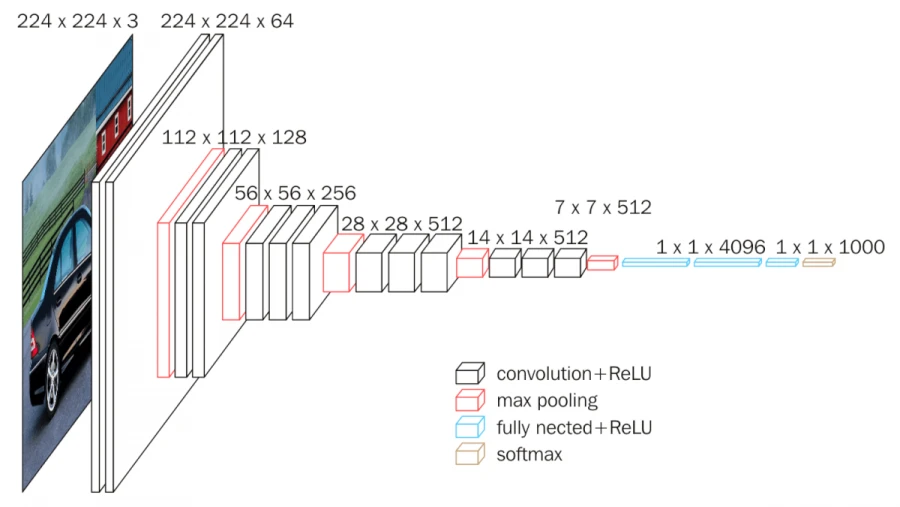
Az Oxfordi Egyetem Visual Geometry Group (VGG) kutatócsoportja mutatta be 2014-ben az ImageNet versenyen. Fő jellemzők: Egységes felépítés: Szakított a korábbi egyedi tervezésű nagy szűrőkkel (11×11 / 5×5). Helyette kizárólag apró, 3×3 méretű konvolúciós szűrőket és 2×2 méretű Max Pooling rétegeket használt egymás után pakolva . Miért a 3×3 szűrő? Két egymás utáni 3×3-as konvolúció ugyanakkora látómezőt (receptive field) fed le, mint egy 5×5-ös, de sokkal kevesebb paramétert igényel, és kétszeres nemlineáris aktivációt tesz lehetővé. Mélység: 16 súlyozott rétegből áll (13 konvolúciós és 3 teljesen összekötött réteg) . Hátrányai: Rendkívül nagy méretű. Körülbelül 138 millió paramétert tartalmaz, aminek nagy része a hálózat végén található teljesen összekötött rétegekben összpontosul. Emiatt lassú a tanítása és hatalmas a memóriatár-igénye. Itt jelentkezett az eltűnő gradiens (vanishing gradient) problémája a mélység miatt
- ResNet architektúra (Skip connections)
(Azt a problémát oldották meg, hogy hogyan lehet úgy mélyebb hálókat létrehozni, hogy képesek legyenek tanulni. Megoldás: skip connections.)
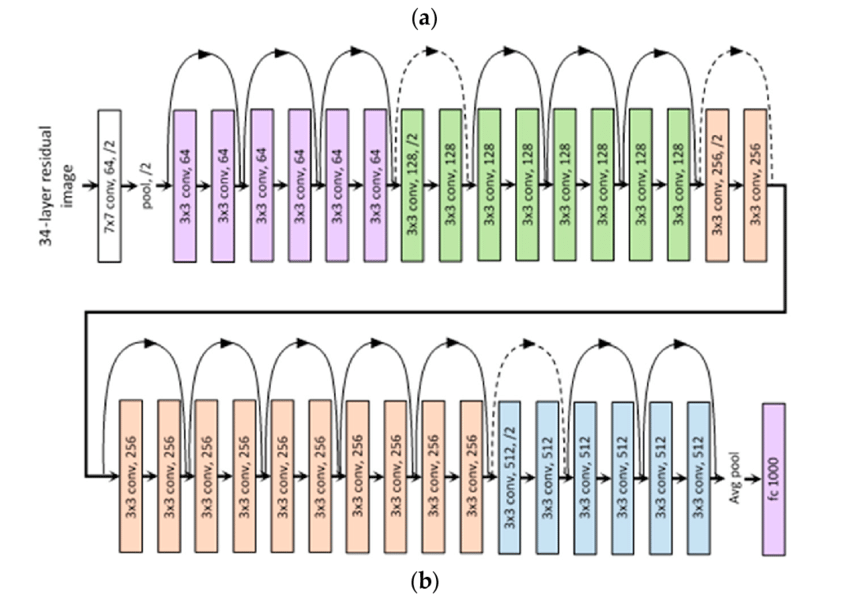
A Kaiming He és csapata által fejlesztett hálózat megnyerte a 2015-ös ImageNet versenyt. Megoldotta azt a problémát, hogy a túl mély hálózatok (20-30 réteg felett) a degradációs probléma és az eltűnő gradiensek miatt paradox módon rosszabbul teljesítettek, mint a sekélyebb társaik. Fő jellemzők: Maradék blokkok (Residual Blocks) és Skip Connections (vagy shortcut): A ResNet kulcsfontosságú újítása, hogy a rétegek nem csak közvetlenül egymás után adják át az információt, hanem átugró kapcsolatokkal (skip connections) közvetlenül átmásolják az inputot (x) néhány réteggel későbbre, majd hozzáadják a konvolúciók kimenetéhez: Kimenet=F(x)+x Miért működik? Ha egy réteg felesleges vagy rontaná a teljesítményt, a hálózat könnyen megtanulhatja nullára redukálni a konvolúciós súlyokat (F(x)≈0), így az információ torzítás nélkül halad tovább (x). Ez drasztikusan megkönnyíti a gradiens visszaáramlását a tanítás során (backpropagation). Hatalmas mélység: A ResNet változattól függően létezik 34, 50, 101, vagy akár 152 réteges verzióban is. Könnyebb modell: Annak ellenére, hogy sokkal mélyebb, mint a VGG16, a teljesen összekötött rétegek elhagyásának (helyette globális átlagoló mintavételezést használnak) köszönhetően a paraméterek száma lényegesen kisebb (pl. a ResNet-50 kb. 25-26 millió paramétert tartalmaz)
NOTEBOOK
Most van backboneunk, ami legyártja a feature mapet. Hogyan lehet ebből ojektum detekciót csinálni? ->head hozzácsatolása
-
A klasszikus „Two-Stage” megközelítés (pl. R-CNN) Region Proposal: Egy külön algoritmus átnézi a képet, és kivág belőle 1000-2000 olyan téglalapot, ahol úgy tűnik, van valami (objektum-jelöltek). Klasszifikáció és Finomítás: Ezeket a kivágott képrészeket egyenként átküldjük a CNN-en, hogy megmondja, mi van ott, és pontosítsa a dobozt. A probléma: Ez rendkívül pontos, de elképesztően lassú. Ha 1000 régiót kell egyenként osztályozni, az autó már rég nekiment a stoptáblának, mire a hálózat lefuttatta a számításokat.
-
A „One-Stage” forradalom (pl. YOLO - You Only Look Once) Az elv: Nincs javaslattétel, nincs különválasztott lépés. A képet csak egyszer nézzük meg. A teljes képet átküldjük a Backbone-on, és a Head közvetlenül, egyetlen menetben (Single Shot) adja meg a koordinátákat és az osztályokat.
(Eddig az utolsó réteget használtuk fel mint döntési bemenet (HEAD bemenet). Itt alacsony a térbeli reprezentáció de magas szemantika. A modern rendszerek nem csak az utolsó réteget használják fel.-> NECK.) A hálózat elején (sekély rétegek): Nagy a felbontás, kiválóan látszanak az élek, apró részletek, precíz a lokalizáció, de nincs szemantika (a háló még nem tudja, hogy az ott egy autó kereke). A hálózat végén (mély rétegek): Kicsi a felbontás. A hálózat már pontosan tudja, hogy a képen van egy busz (magas szemantika), de a durva felbontás miatt teljesen elvesztette a pontos koordinátákat (főleg ha a busz messze van és kicsi). A Neck (mint egy nyak a törzs és a fej között) összegyűjti a Backbone különböző szintjeiről származó jellemzőtérképeket: Felskálázza a mély, szemantikailag erős rétegeket. Oldalirányú kapcsolatokkal (skip connections) hozzákeveri a korábbi, nagy felbontású rétegek információit. Az eredmény: Olyan több-skálás jellemzőtérképeket kapunk, amelyek egyszerre hordozzák a pontos helyszíni információt és a magas szintű megértést. Ezzel a trükkel a detektorunk képes lesz a szélvédőhöz közeli hatalmas teherautókat és a távoli, pár pixeles gyalogosokat is egyszerre, hibátlanul felismerni.
4 Objektumdetektálás konvolúciós neurális hálózatokkal
Határoló doboz
Egy objektum helyét gyakran téglalappal közelítjük. Ez a bounding box, magyarul határoló doboz. Többféleképpen parametrizálható:
$$ (x_{min},y_{min},x_{max},y_{max}) $$
vagy
$$ (c_x,c_y,w,h), $$
ahol $(c_x,c_y)$ a doboz középpontja, $w$ a szélessége, $h$ a magassága. A gyakorlatban ezeket sokszor a képmérethez viszonyítva normalizáljuk, például $0$ és $1$ közötti értékekre.
4.1 Első detektor: egy kép, egy objektum
4.1.1 A legegyszerűbb gondolatkísérlet
Tegyük fel, hogy minden tanítóképünkön pontosan egy fontos objektum szerepel. Lehet ez például egy autó, gyalogos vagy kerékpáros. A feladat:
- mondjuk meg, milyen osztályú az objektum;
- adjuk meg a határoló dobozát.
Ez még nem teljes objektumdetektálás, hanem inkább osztályozás + lokalizáció. Mégis ez a legjobb belépési pont, mert csak egyetlen új ötletet adunk a már ismert CNN-hez: a háló ne csak osztálypontszámot adjon, hanem dobozkoordinátákat is.
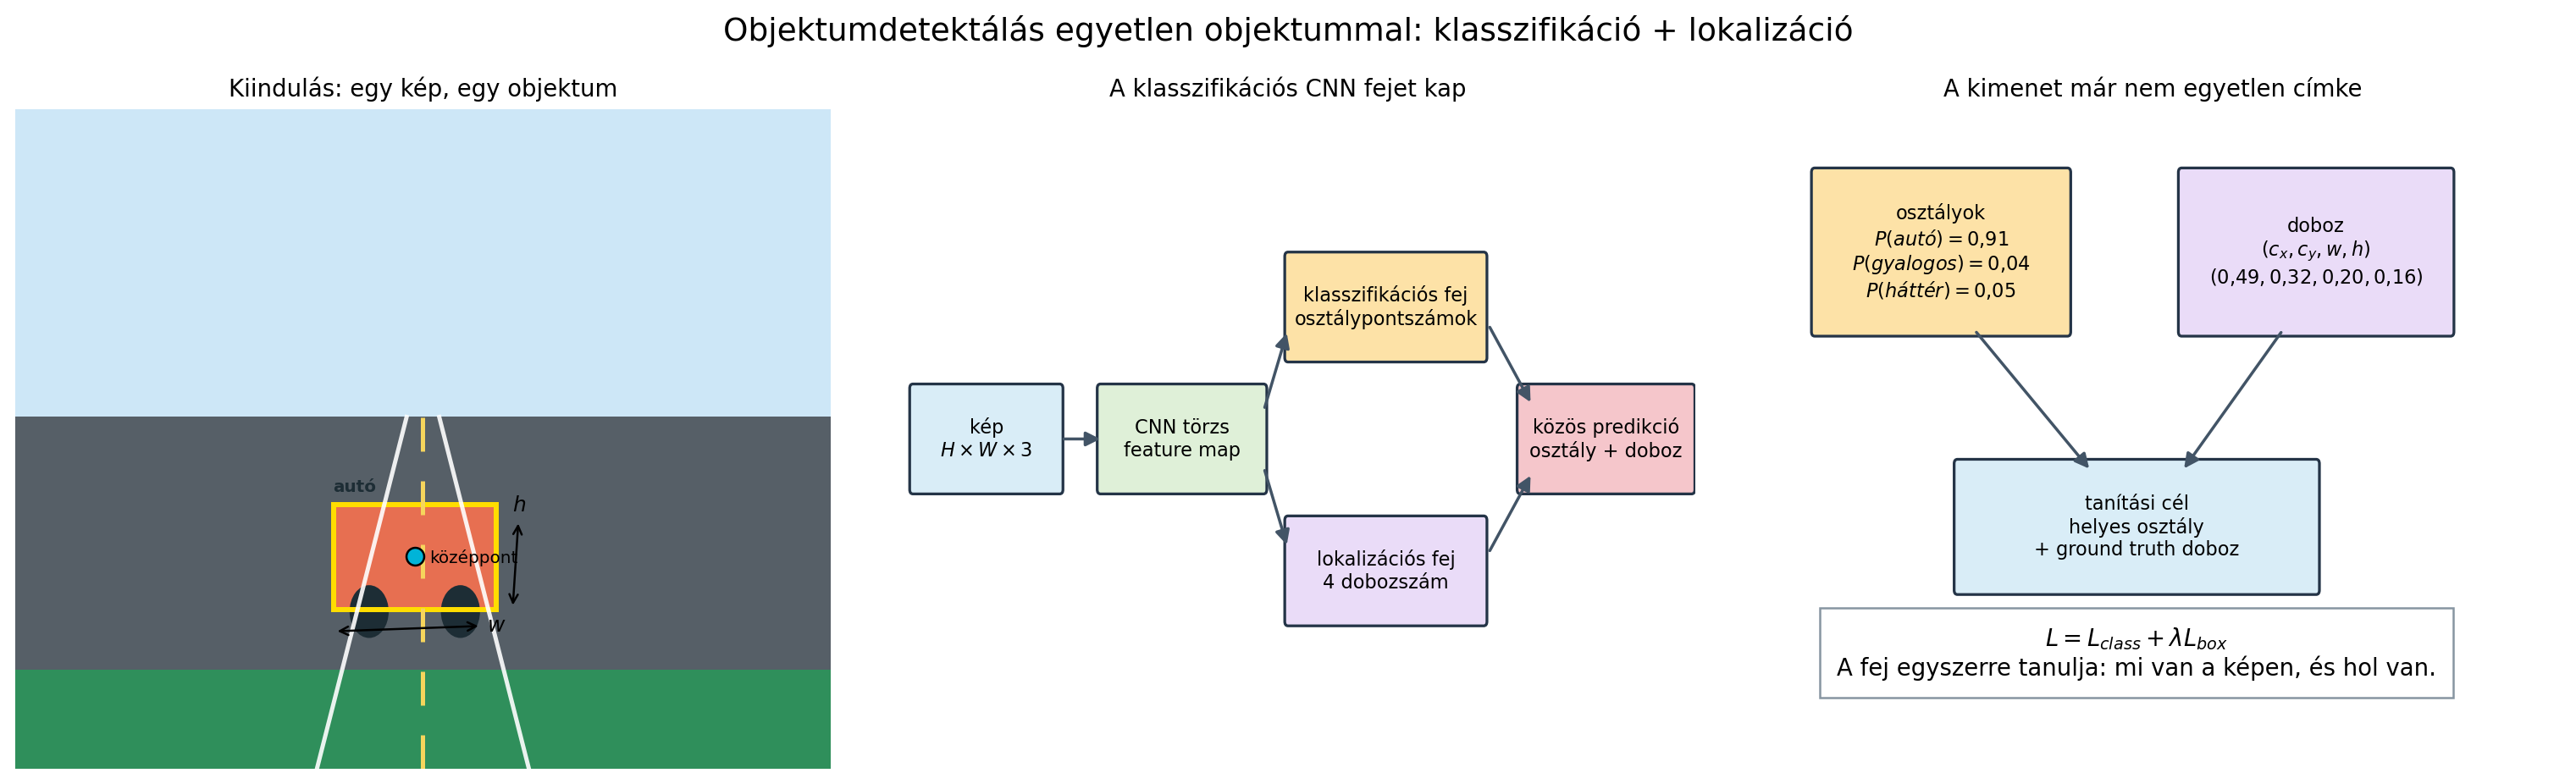
4.1.2 CNN-törzs és két fej
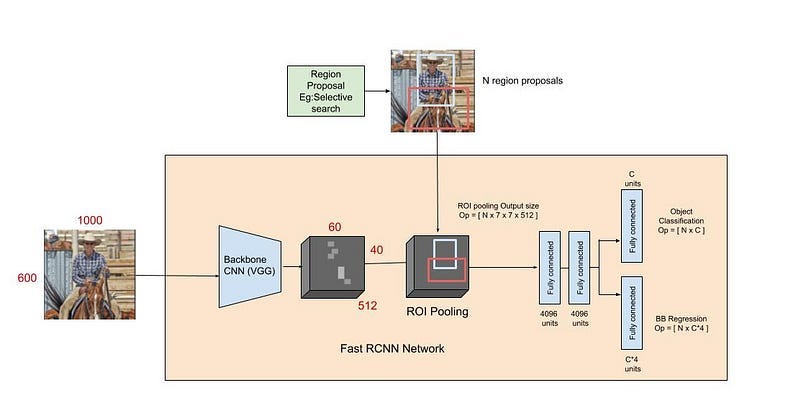
A VGG16-hoz vagy ResNethez hasonló osztályozó háló két nagy részre bontható:
- CNN-törzs (backbone): konvolúciós rétegek, amelyek képi jellemzőtérképeket tanulnak.
- Osztályozó fej: a jellemzőkből osztálypontszámokat készít.
Egy egyszerű lokalizációs modellben a CNN-törzs után két fej lehet:
- osztályozó fej: $C$ osztály logitját adja;
- dobozregressziós fej: 4 számot ad, például $(c_x,c_y,w,h)$.
Formálisan:
$$ \mathbf{h}=\mathrm{CNN}_{backbone}(I), $$
$$ \mathbf{z}{class}=f{class}(\mathbf{h}), $$
$$ \hat{\mathbf{b}}=f_{box}(\mathbf{h})=(\hat{c}_x,\hat{c}_y,\hat{w},\hat{h}). $$
A modell kimenete tehát nem egyetlen vektor, hanem két különböző természetű becslés: egy diszkrét osztályeloszlás és egy folytonos geometriai mennyiség.
4.1.3 Mi lesz a címke?
Osztályozásnál egy tanítóminta:
$$ (I,y), $$
ahol $I$ a kép, $y$ pedig az osztálycímke.
Lokalizációnál a címke bővül:
$$ (I,y,\mathbf{b}), $$
ahol $\mathbf{b}$ a ground truth doboz. Például:
$$ y=\text{autó},\qquad \mathbf{b}=(0{,}49,0{,}32,0{,}20,0{,}16). $$
Ez azt jelenti, hogy a doboz középpontja a kép szélességének 49%-ánál és magasságának 32%-ánál van, a doboz szélessége a kép 20%-a, magassága pedig a kép 16%-a.
4.1.4 Veszteség: osztályhiba + dobozhiba
Az egyszerű egyobjektumos modell vesztesége két részből állhat:
$$ L=L_{class}+\lambda L_{box}. $$
Az $L_{class}$ tipikusan keresztentrópia:
$$ L_{class}=-\log P(y_{helyes}\mid I). $$
Az $L_{box}$ lehet például L1, L2 vagy Smooth L1 veszteség a becsült és a helyes dobozkoordináták között:
$$ L_{box}=\left\lVert \hat{\mathbf{b}}-\mathbf{b}\right\rVert_1. $$
A $\lambda$ súly azt szabályozza, hogy a tanításban mennyire legyen fontos a geometriai pontosság az osztályozáshoz képest. Ha túl kicsi, a modell jól osztályozhat, de rosszul lokalizál. Ha túl nagy, a dobozillesztés dominálhatja az osztálytanulást.
4.1.5 Miért regresszió a doboz?
Az osztály diszkrét: autó, gyalogos, kerékpár. A doboz koordinátái viszont folytonosak. Egy objektum bal széle lehet a kép 13,2%-ánál vagy 13,3%-ánál is. Ezért a lokalizációt regressziós problémaként kezeljük.
Az intuíció:
- az osztályozó fej azt tanulja, milyen mintázat látszik;
- a dobozfej azt tanulja, hol helyezkedik el ez a mintázat a képen.
4.1.6 IoU: mennyire jó a doboz?
Koordinátahiba helyett gyakran természetesebb azt kérdezni: mennyire fed át a becsült doboz a helyes dobozzal? Erre szolgál az Intersection over Union, röviden IoU:
$$ IoU=\frac{|B_{pred}\cap B_{gt}|}{|B_{pred}\cup B_{gt}|}. $$
Ha a két doboz pontosan azonos, akkor $IoU=1$. Ha nem fedik egymást, akkor $IoU=0$.
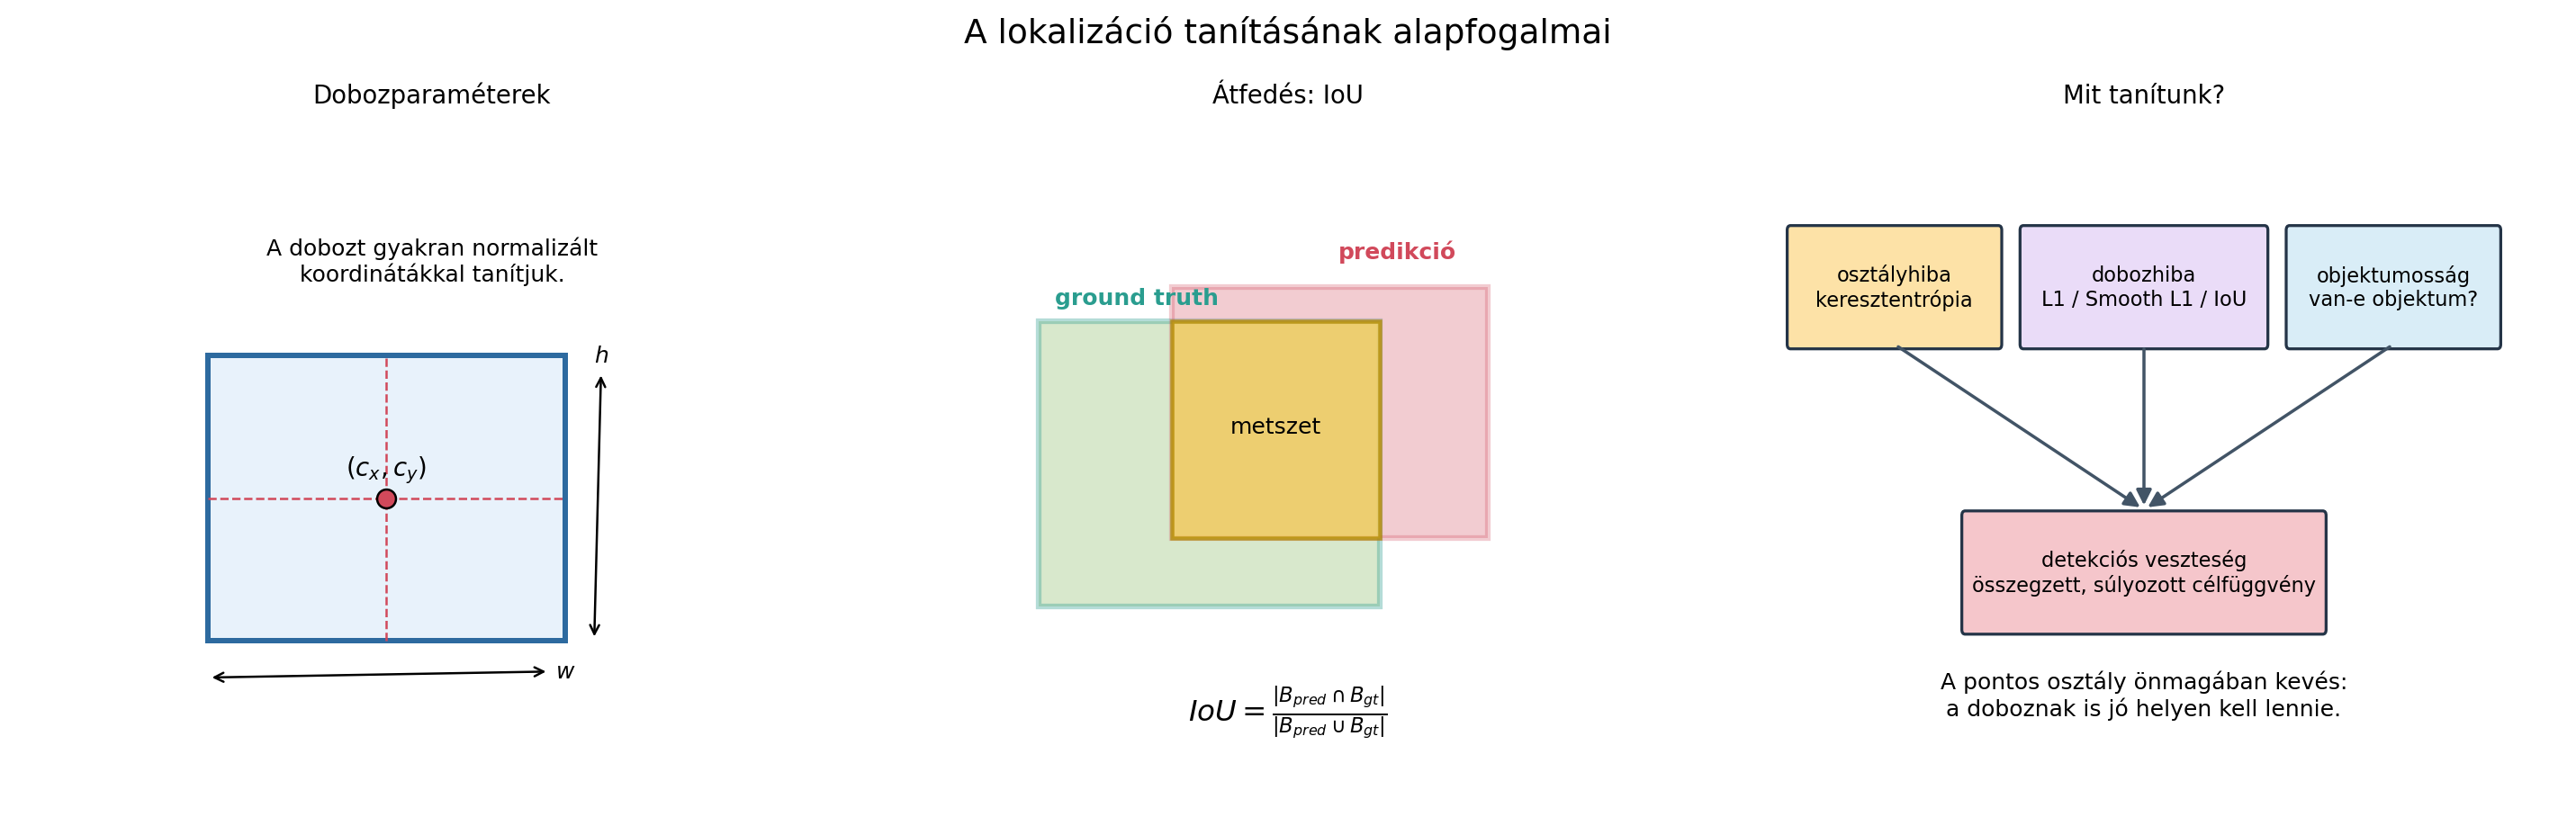
Egy objektumdetektor kiértékelésénél gyakori szabály:
- ha a becsült osztály helyes és $IoU\geq0{,}5$, akkor a detekció igaz pozitív;
- ha az IoU túl kicsi, a doboz rossz helyen van, tehát a detekció hibás;
- ha egy objektumhoz nem tartozik megfelelő predikció, az kihagyott detekció.
4.2. Több objektum egy képen
4.2.1. Mi romlik el az egyobjektumos modellben?
Az előző modell pontosan egy dobozt ad. De mi történik, ha a képen három autó és egy gyalogos van?
Egyetlen doboz nem elég. A modellnek változó számú objektumot kell visszaadnia:
$$ {(y_1,\mathbf{b}_1,s_1),(y_2,\mathbf{b}_2,s_2),\ldots,(y_N,\mathbf{b}_N,s_N)}, $$
ahol $s_i$ a detekció pontszáma vagy konfidenciája. A gond az, hogy $N$ képenként változik. Egy képen lehet nulla objektum, a másikon tizenöt.
A neurális háló kimeneti tenzora viszont általában rögzített alakú. Ezért trükkre van szükség: a modell sok lehetséges helyre készít predikciót, majd a végén kiválasztjuk a jókat.
4.2.2 Rács- vagy jellemzőtérkép-alapú predikció
Osszuk fel a képet vagy a jellemzőtérképet (feature map) cellákra. Minden cella felelhet azokért az objektumokért, amelyeknek a középpontja az adott cellába esik. A cella kimenete tartalmazhat:
- objektumossági pontszámot: van-e itt objektum;
- egy vagy több dobozt;
- osztálypontszámokat.
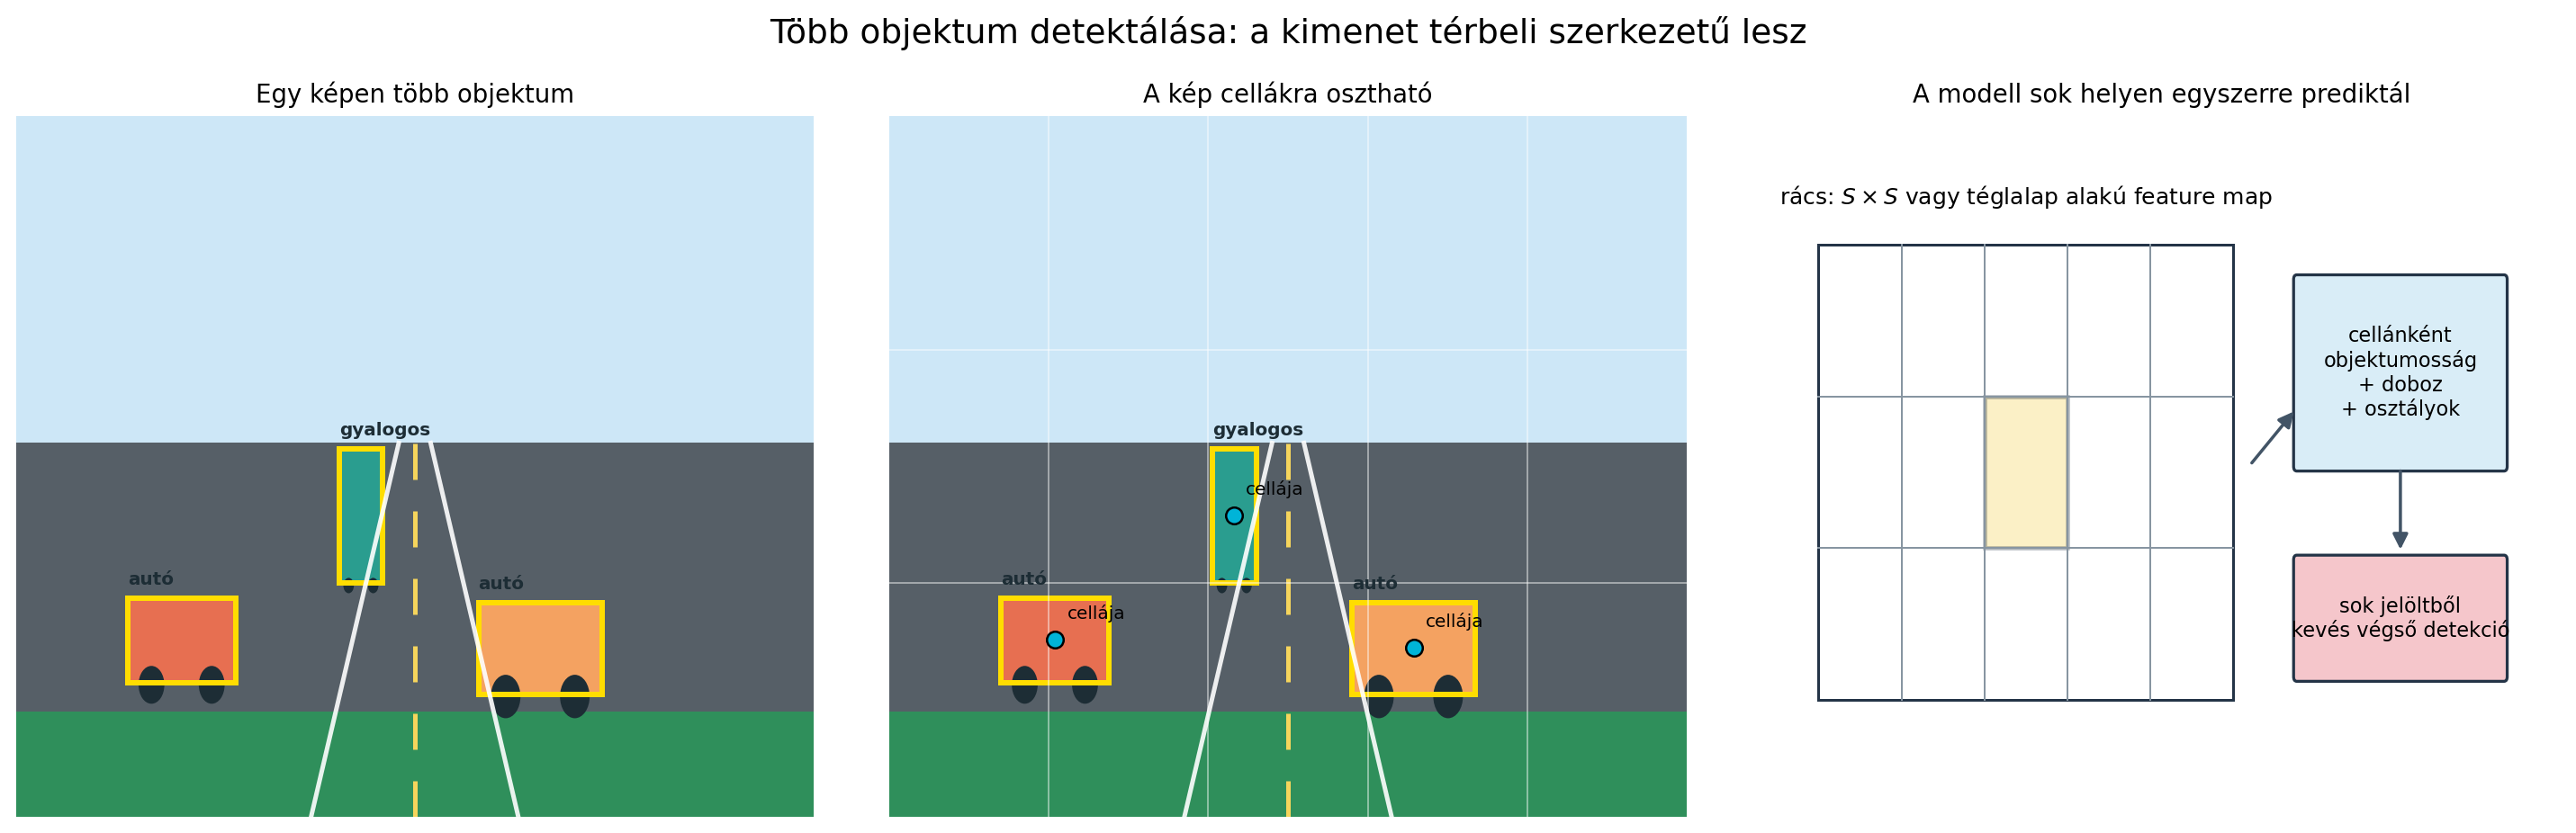
Ez a gondolat jelenik meg több egyfokozatú detektorban, például YOLO-ban és SSD-ben is. A háló nem külön fut minden objektumra. Egyetlen előremenetben egy teljes predikciós mezőt állít elő.
4.2.3 Objektumosság
Osztályozásnál minden képnek volt osztálya. Detekciónál a legtöbb cellában nincs objektum. Ezért a modellnek azt is meg kell tanulnia, hogy egy helyen egyáltalán érdemes-e dobozt mondani.
Ezt nevezzük objektumossági (objectness) pontszámnak:
$$ P(\text{object}). $$
Magas objektumosság azt jelenti: a modell szerint ezen a helyen valamilyen tanított objektum található. Az osztálypontszám ezután mondja meg, hogy autó, gyalogos vagy más kategória.
Gyakori gondolkodási minta:
$$ s_{\mathrm{vegso}}=P(\mathrm{object})\cdot P(\mathrm{class}\mid \mathrm{object}). $$
4.2.4 Sok jelöltből kevés végső doboz: NMS
Egy valós objektumra gyakran több cella és több horgony-doboz (anchor box) is magas pontszámot ad. Ez sok egymást átfedő dobozt eredményez. A végén ezekből egyet kell megtartani.
Erre szolgál a Non-Maximum Suppression, röviden NMS:
- rendezzük a dobozokat pontszám szerint csökkenő sorrendbe;
- tartsuk meg a legmagasabb pontszámú dobozt;
- dobjuk el azokat a gyengébb dobozokat, amelyek vele túl nagy IoU-val fednek át;
- ismételjük a megmaradt dobozokon.
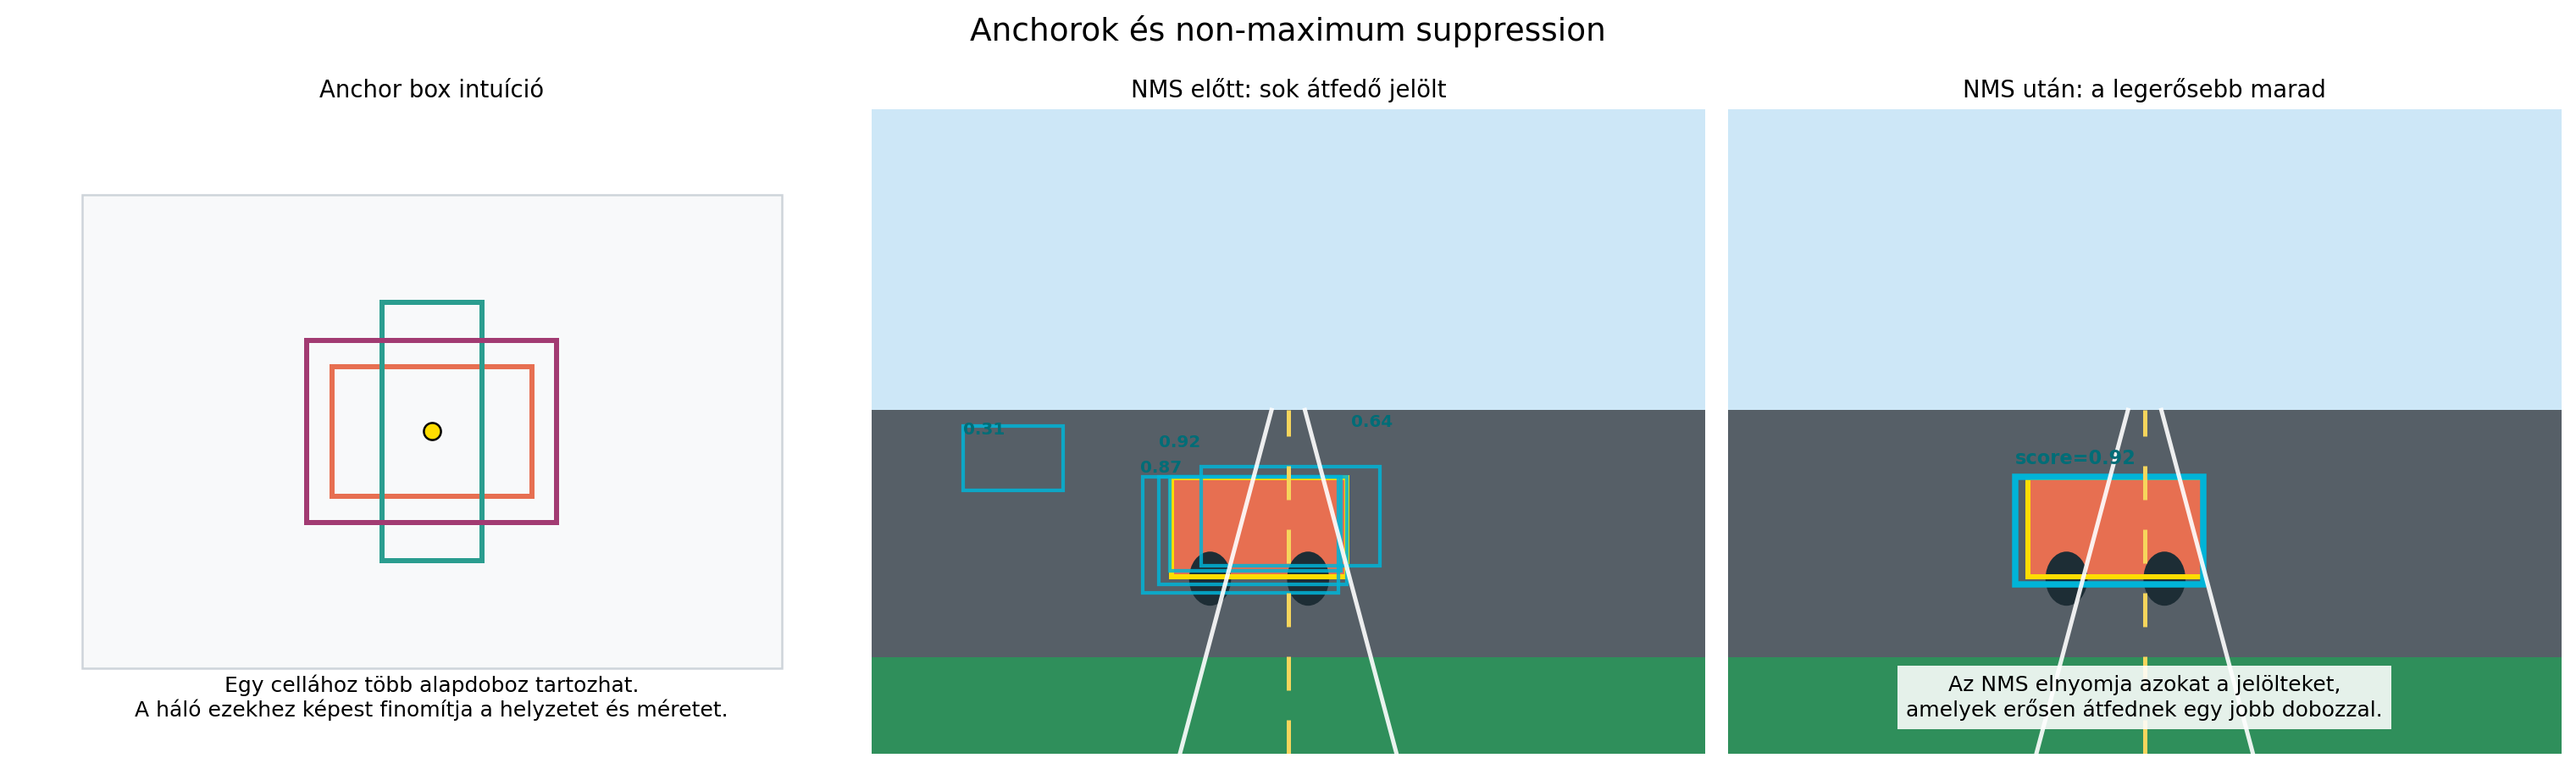
Az NMS nem neurális réteg a klasszikus értelemben, hanem utófeldolgozás. Mégis döntő része sok detektornak: nélküle ugyanarra az autóra több tucat dobozt is kapnánk.
4.3 YOLOv1 esettanulmány
4.3.1 A fő ötlet
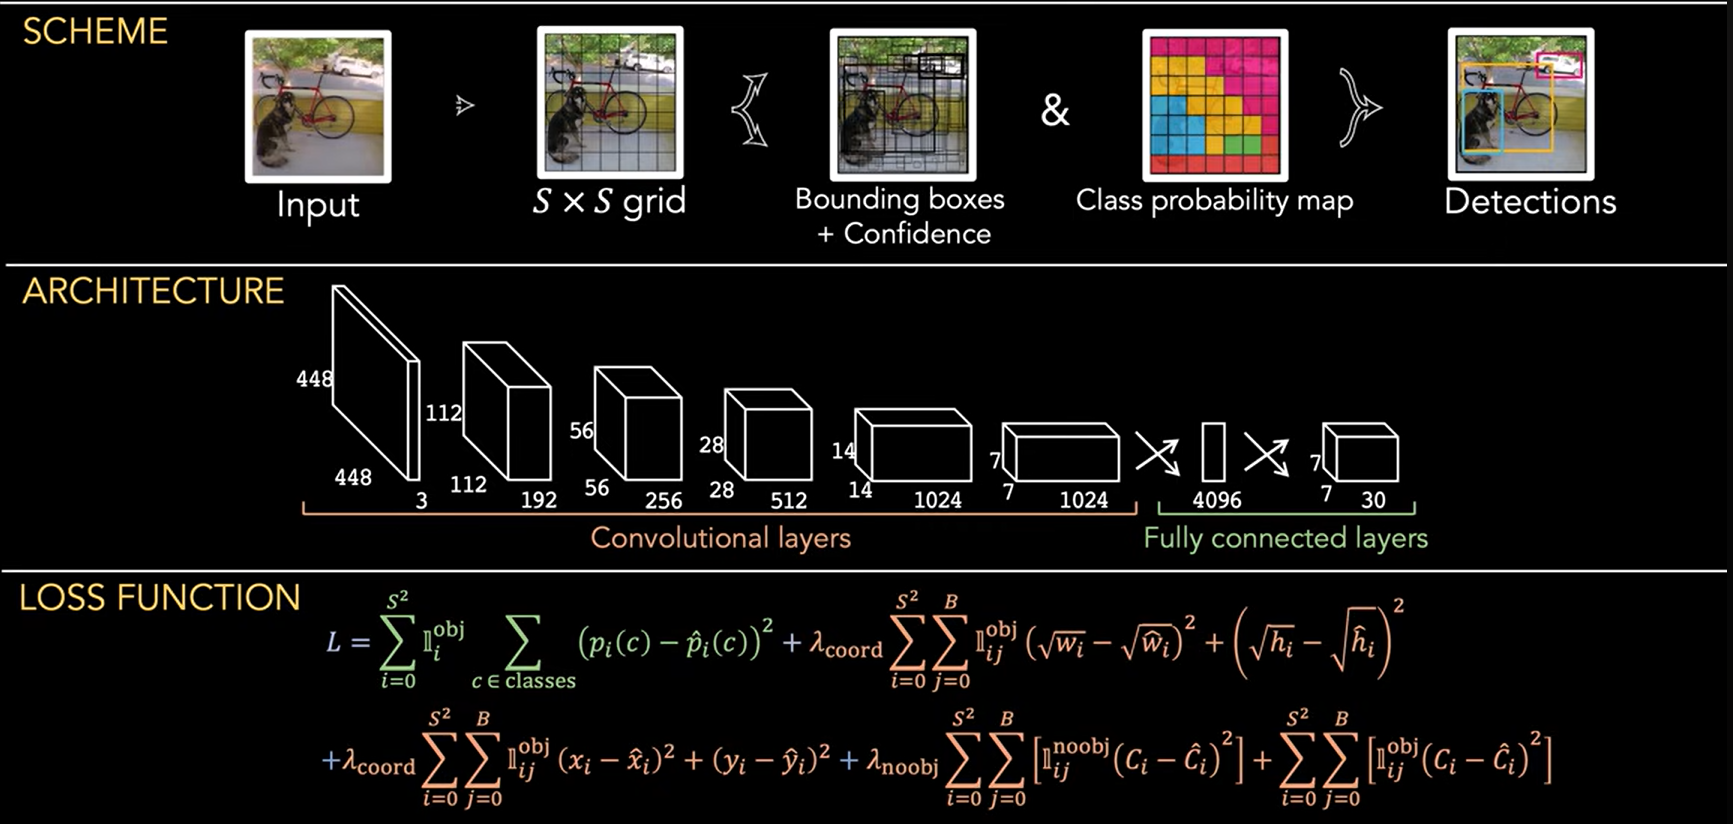
A YOLO név jelentése: You Only Look Once. Az alapgondolat az, hogy a detektálást egyetlen regressziós problémaként kezeljük. A háló egyetlen előremenettel a teljes képre megjósolja:
- hol lehetnek objektumok;
- milyen dobozok tartoznak hozzájuk;
- milyen osztályúak.
Ez éles különbség a csúszó ablakos szemlélethez képest. Nem futtatunk klasszifikátort sok ezer kivágáson. A teljes kép egyszer megy át a hálón, a kimenet pedig egy rács alakú predikció.
4.3.2 A kép felosztása rácsra
YOLOv1-ben a képet $S\times S$ rácsra osztjuk. Az eredeti YOLOv1 a Pascal VOC feladaton $S=7$ értéket használt, tehát 7x7 cellát.
Szabály:
Az objektumért az a cella felel, amelybe az objektum középpontja esik.
Ez egyszerű, de fontos következménye van: ha két objektum középpontja ugyanabba a cellába esik, YOLOv1 nehezen kezeli őket. Ez a kis, egymáshoz közeli objektumok egyik fő problémája.
4.3.3 Mit prediktál egy cella?
Minden cella $B$ darab dobozt prediktál. Az eredeti YOLOv1-ben $B=2$. Egy dobozhoz 5 szám tartozik:
$$ (x,y,w,h,confidence). $$
Itt az $(x,y)$ a doboz középpontja a cellához viszonyítva, $w$ és $h$ a képhez viszonyított szélesség és magasság, a konfidencia (confidence) pedig azt jelzi, mennyire biztos a modell abban, hogy a doboz objektumot tartalmaz és jól illeszkedik.
A YOLOv1 konfidenciájának definíciója:
$$ confidence=P(\text{object})\cdot IoU_{pred}^{truth}. $$
Ha nincs objektum a cellában, akkor $P(\text{object})=0$, tehát a célkonfidencia 0. Ha van objektum, akkor a konfidencia a becsült és a helyes doboz IoU-ját közelíti.
Emellett minden cella osztályvalószínűségeket is prediktál:
$$ P(\text{class}_i\mid \text{object}). $$
4.3.4 A kimeneti tenzor mérete
Ha:
- $S$ a rács mérete;
- $B$ a cellánkénti dobozok száma;
- $C$ az osztályok száma;
akkor a YOLOv1 kimenete:
$$ S\times S\times(B\cdot5+C). $$
Pascal VOC esetén $S=7$, $B=2$, $C=20$, ezért:
$$ 7\times7\times(2\cdot5+20)=7\times7\times30. $$
Ez azt jelenti, hogy a háló 49 cellára, cellánként 30 számot ad.
4.3.5 Hogyan lesz ebből végső detekció?
Egy adott osztályra a doboz végső pontszáma:
$$ score_i=P(\text{class}_i\mid \text{object})\cdot confidence. $$
A confidence felbontását behelyettesítve:
$$ score_i=P(\text{class}_i\mid \text{object})\cdot P(\text{object})\cdot IoU. $$
Ez egyszerre fejezi ki:
- milyen valószínű osztályról van szó;
- van-e ott objektum;
- mennyire jó a doboz.
Az inferencia tipikus lépései:
- a háló elkészíti a $7\times7\times30$ predikciót;
- minden dobozhoz és osztályhoz pontszámot számítunk;
- az alacsony pontszámú jelölteket eldobjuk;
- osztályonként NMS-t futtatunk;
- a megmaradt dobozok lesznek a végső detekciók.
4.3.6 A YOLOv1 veszteség intuíciója
YOLOv1 vesztesége több tagból áll. A cél, hogy a modell egyszerre tanulja:
- a doboz középpontját;
- a doboz méretét;
- az objektumossági konfidenciaértéket;
- az osztályvalószínűségeket.
A veszteség sematikusan:
$$ L=L_{coord}+L_{confidence}+L_{class}. $$
Az eredeti YOLOv1 néhány fontos trükköt használ:
1. Csak a felelős doboz tanulja az objektum koordinátáit.
Egy objektumért az a cella felel, amelybe a középpontja esik. A cellán belül a két prediktált doboz közül az lesz felelős, amelyiknek nagyobb az IoU-ja a ground truth dobozzal.
2. A koordinátahiba nagyobb súlyt kap.
YOLOv1-ben $\lambda_{coord}=5$. Ez azért kell, mert a pontos lokalizáció fontos, és sok cella nem tartalmaz objektumot.
3. Az üres cellák konfidenciahibája kisebb súlyt kap.
Mivel a legtöbb cellában nincs objektum, különben a tanítást elárasztaná a „nincs objektum” jel. Erre szolgál $\lambda_{noobj}=0{,}5$.
4. A szélesség és magasság négyzetgyökét tanítja.
A hiba nem közvetlenül $w,h$ értékeken, hanem $\sqrt{w},\sqrt{h}$ értékeken jelenik meg. Így egy kis dobozon elkövetett abszolút hiba relatíve fontosabb, mint ugyanakkora hiba egy nagy dobozon.
4.3.7 Miért volt fontos a YOLOv1?
YOLOv1 jelentősége nem az volt, hogy minden metrikán a legjobb lett, hanem hogy nagyon egyszerű és gyors szemléletet adott:
- a detektálást egyetlen neurális hálós regressziós feladatként fogta fel;
- valós idejű sebességre törekedett;
- a teljes képi kontextust használta, nem csak lokális javaslatokat;
- könnyen magyarázható rácsalapú kimenetet adott.
4.3.8 YOLOv1 korlátai
YOLOv1-nek több ismert gyengesége volt:
- egy cella csak korlátozott számú objektumot tud jól kezelni;
- közeli, kis objektumoknál könnyen hibázik;
- a rácsszerkezet miatt a lokalizáció durvább lehet;
- a dobozformák kezelése kevésbé rugalmas, mint későbbi horgony-doboz alapú változatokban;
- szokatlan képarányú vagy ritka objektumokon gyengébben általánosíthat.
A későbbi YOLO-változatok sokat javítottak ezeken: horgony-dobozokat, jobb CNN-törzseket, többléptékű predikciót, modernebb veszteségfüggvényeket és fejlettebb tanítási eljárásokat használnak. A YOLOv1 mégis kiváló tanulási példa, mert a fő gondolat tiszta és követhető.
5. ML-projekt rendszerezése
5.1 A modell fejlesztésének sorrendje
Az ortogonalizálás azt jelenti, hogy a fejlesztési problémákat elkülönített lépésekben kezeljük. A járműirányításhoz hasonlóan a hosszirányú és az oldalirányú szabályozót sem egyszerre hangoljuk: előbb azonosítjuk, melyik alrendszer okozza a hibát, majd célzottan módosítjuk.
Mélytanulási projektben a következő sorrend segít a hibák elkülönítésében:
| Ellenőrzési cél | Ha nem teljesül | Elsődleges beavatkozások |
|---|---|---|
| A modell illeszkedjen a tanítóhalmazra. | Magas a tanítási hiba. | Nagyobb vagy megfelelőbb architektúra, hosszabb tanítás, jobb optimalizáló, hiperparaméter-keresés. |
| A modell általánosítson a validációs halmazra. | A validációs hiba lényegesen nagyobb a tanítási hibánál. | Több vagy változatosabb tanítóadat, regularizáció, adataugmentáció. |
| A választott megoldás a teszthalmazon is megbízható legyen. | A teszteredmény eltér a validációs eredménytől. | A validációs halmaz és a hangolási folyamat felülvizsgálata; a teszthalmazhoz nem nyúlunk iteratívan. |
| A modell a célalkalmazásban is működjön. | Éles környezetben romlik a teljesítmény. | Reprezentatívabb validációs és tesztadat, a célfüggvény vagy az értékelési metrika módosítása. |
A fejlesztési iterációkhoz célszerű egy elsődleges metrikát kijelölni. Bináris osztályozásnál ilyen lehet az F1-pontszám, amely a precision és recall harmonikus átlaga. Objektumdetektálásnál jellemzően az átlagos precizitást (AP) vagy annak osztályok közötti átlagát, az mAP-ot használjuk, rögzített IoU-küszöb mellett. Az elsődleges metrika a modellválasztást és a kísérletek összevetését szolgálja; az alkalmazásban ettől eltérő üzemi metrikák is szükségesek lehetnek.
5.2 Az adathalmazok megválasztása
A validációs és teszthalmaznak egymáshoz, valamint a célalkalmazáshoz is hasonló eloszlást kell képviselnie. Ez magában foglalja az osztályarányokat, a megvilágítást, az időjárást, a szenzorkonfigurációt és a forgalmi helyzeteket. Ha egy automatikus vészfékező rendszer validációs és tesztadata főként alacsony forgalmú autópályás jelenetekből áll, kevés gyalogossal és távoli objektumokkal, akkor a modellt nem a kívánt alkalmazási környezetre hangoljuk.
A validációs és teszthalmaz jelöli ki a célt: azt a környezetet, amelyben jó teljesítményt várunk. A tanítóhalmaz adja azokat a példákat, amelyekből a modell megtanulja ezt a célt megközelíteni.
Az adathalmaz felosztása a rendelkezésre álló adatmennyiségtől és a döntések kockázatától függ. Nagy adathalmaznál kis, de reprezentatív validációs és teszthalmaz is elég lehet; kisebb adathalmaznál nagyobb arányú elkülönített halmazokra van szükség. Ha nincs önálló teszthalmaz, akkor ezt a korlátot egyértelműen dokumentálni kell.
| Helyzet | Lehetséges felosztás | Megjegyzés |
|---|---|---|
| Korlátozott mennyiségű adat | 60/20/20 vagy 70/15/15 | A validációs és teszteredmény bizonytalansága jelentős lehet. |
| Több millió példa | 98/1/1 | Csak akkor megfelelő, ha az 1% továbbra is reprezentatív és elég nagy abszolút elemszámú. |
| Nincs elkülönített teszthalmaz | tanító/validációs | A validációs eredmény optimista lehet a sok iteratív hangolás miatt. |
5.3 Emberszintű teljesítmény mint referencia
Környezetérzékelési feladatokban az emberszintű teljesítmény hasznos referencia lehet, de nem azonos a Bayes-optimális teljesítménnyel. Ha teljesítménymetrikát használunk, ahol a nagyobb érték jobb, akkor a Bayes-optimális teljesítmény elméleti felső korlát. Ha hibametrikát használunk, ahol a kisebb érték jobb, akkor a Bayes-hiba az elméletileg elérhető legkisebb hiba. Az emberi teljesítmény gyakorlati közelítésként használható, mert sok környezetérzékelési feladatban az emberek nagyon erős referenciát adnak.
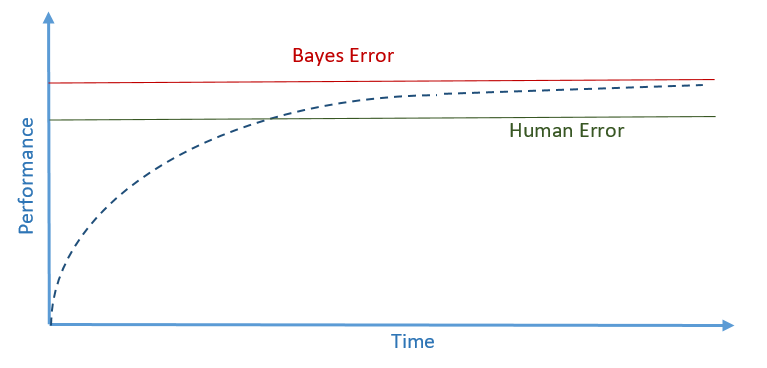
Amíg a modell lényegesen gyengébb az emberi referenciánál, érdemes több jó minőségű címkézett adatot gyűjteni, hibaelemzést végezni, és elkülöníteni a torzításból (bias), illetve varianciából eredő hibát. Emberi referencia hiányában a korábbi modell, a szakértői elvárás vagy a feladatból származó követelmény is betöltheti ezt a szerepet.
5.4 Torzítás és variancia diagnosztikája
Az elkerülhető torzítás (avoidable bias) azt mutatja meg, mennyire marad el a tanítási teljesítmény a választott referenciaértéktől. A variancia azt mutatja, mekkora teljesítménykülönbség keletkezik a tanító- és validációs halmaz között. A képletekben $E_{train}$ a tanítási hiba, $E_{dev}$ a validációs hiba, $E_{ref}$ pedig az emberszintű vagy Bayes-alapú referenciahiba.
$$ \mathrm{avoidable\ bias} \approx E_{train}-E_{ref}, $$
$$ \mathrm{variance} \approx E_{dev}-E_{train}. $$
| Hibatünet | Példa | Következő lépés |
|---|---|---|
| Magas elkerülhető torzítás | referenciahiba: 0,5%; tanítási hiba: 5%; validációs hiba: 6% | Növeljük a modell kapacitását, tanítsunk tovább, vagy javítsuk az optimalizálást és az architektúrát. |
| Magas variancia | referenciahiba: 0,5%; tanítási hiba: 1%; validációs hiba: 5% | Növeljük és változatosabbá tesszük a tanítóadatot, alkalmazzunk regularizációt és adataugmentációt. |
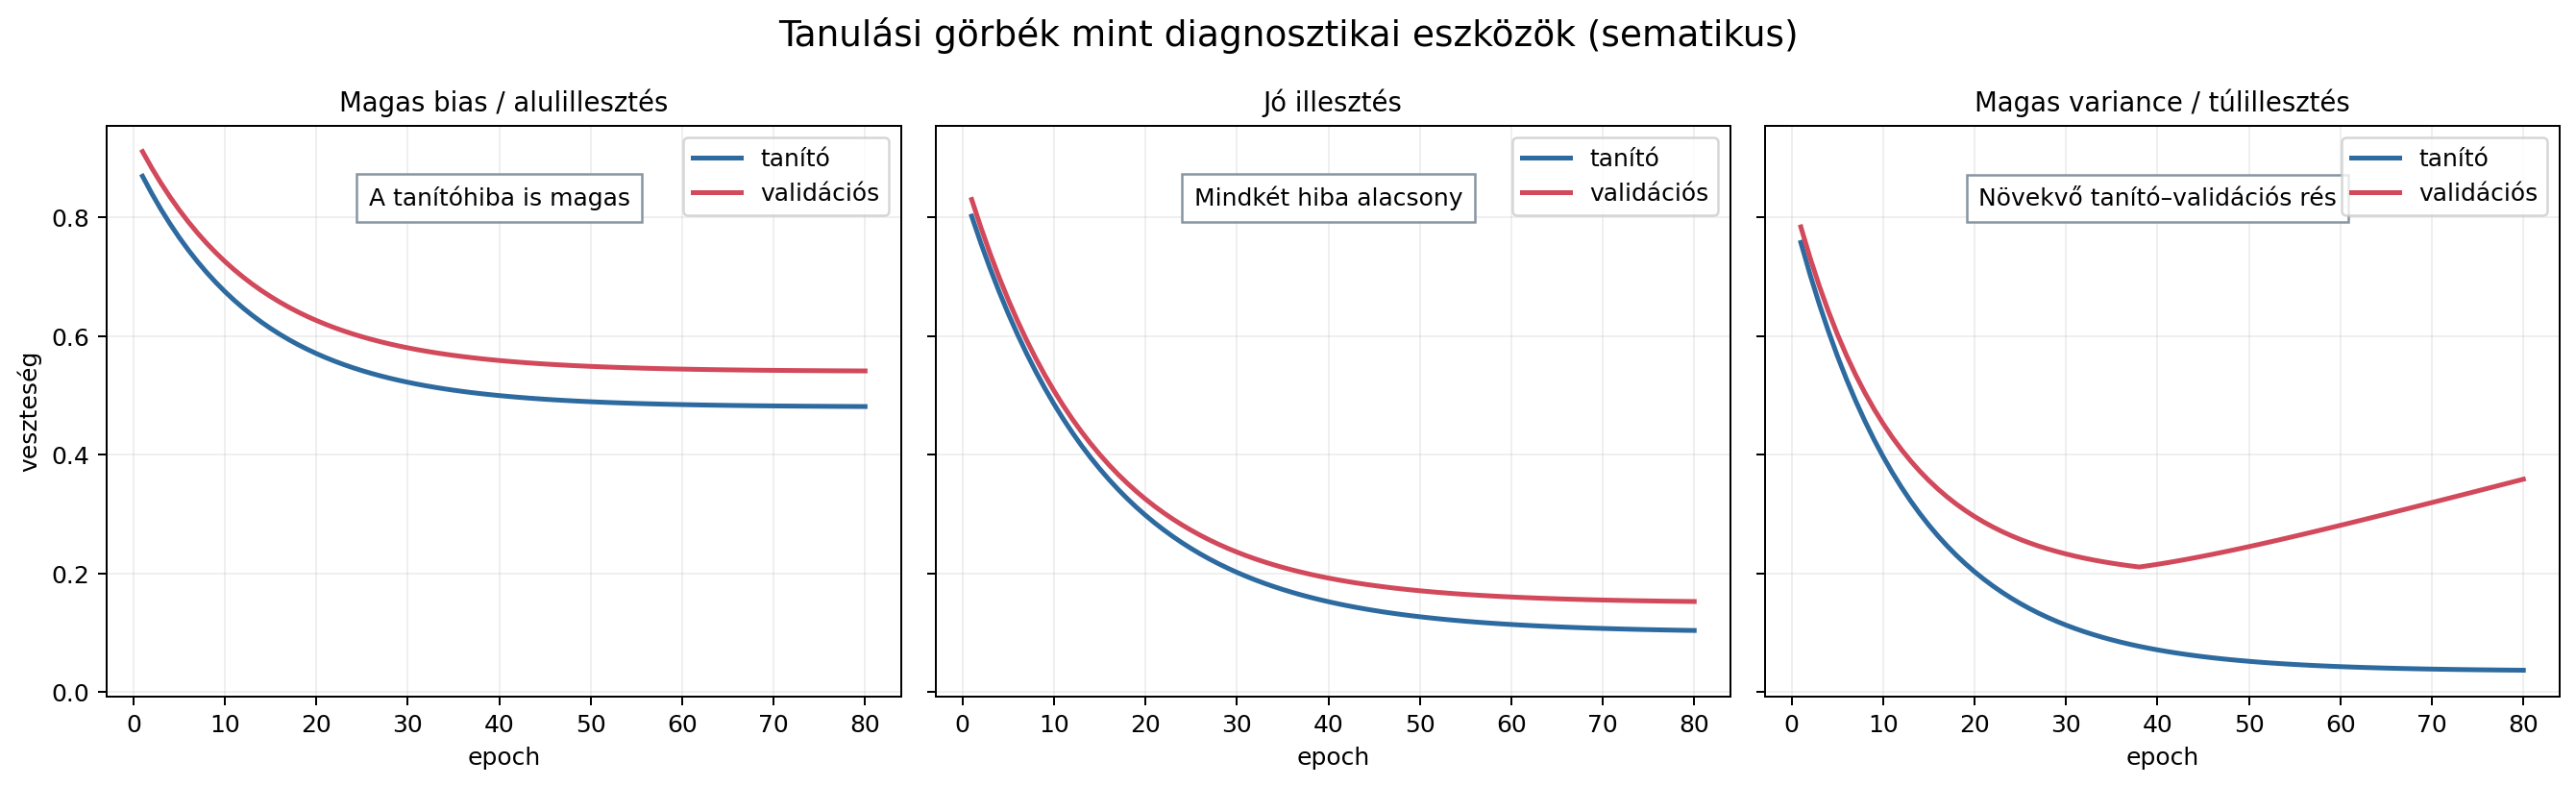
A tanulási görbék segítenek a hibajelenségek elkülönítésében. Magas torzításnál a tanítási és a validációs hiba is magas, magas varianciánál pedig a két görbe közötti rés nagy. A diagnózis után egyszerre csak az ahhoz tartozó beavatkozást változtassuk, majd mérjük meg újra a kijelölt metrikát.
5.5 Mi van ha nem működik jól / nem tanul a háló?
5.5.1. Overfit a single batch
Mielőtt elindítanál egy hosszú tanítást a teljes adathalmazon, próbálj meg overfittelni a modellt mindössze 1 vagy 2 darab mintán.
- Hogyan csináld? Szűkítsd le a DataLoader-t úgy, hogy mindig ugyanazt az 1-2 képet adja vissza, és tanítsd a hálót 50-100 epochon keresztül.
- Mit kell látnod? A tanítási veszteségnek szinte nullára kell csökkennie, az osztályozási pontosságnak pedig 100%-ra kell ugrania.
- Miért fontos ez?
Ha a modell nem képes megjegyezni 2 darab képet, akkor strukturális hiba van a kódban (pl. elfelejtetted az optimizerrel frissíteni a paramétereket, rossz a veszteségfüggvény, vagy a forward pass-ban megszakad a számítási gráf). Ha ez a teszt sikeres, a kódod matematikailag és szerkezetileg helyes, és magabiztosan továbbléphetsz a teljes adatra.
5.5.2. Ha a veszteség „NaN” (Not a Number) vagy „Inf” lesz
A leggyakoribb ijesztő jelenség, amikor a loss hirtelen eltűnik, és csak nan vagy inf értékeket kapsz.
- A kiváltó ok: Gradiens-felrobbanás (exploding gradient) vagy numerikus instabilitás (pl. nullával való osztás vagy negatív szám logaritmusa).
- Gyakorlati fogások a megoldásra:
Gradiens levágás (Gradient Clipping): Korlátozd a gradiensek maximális normáját, mielőtt az optimizer lépne egyet: Veszteségfüggvény stabilitása: Neurháló mélységének csökkentése
5.5.3. Tanító és validációs adatok függetlensége
Amikor a hálózatod a validációs és teszthalmazon 99.9%-os pontosságot ér el, de a valóságban, az autóba szerelve teljesen használhatatlan.
- A probléma: A tanító- és a tesztadatok nem teljesen függetlenek egymástól.
- Járműipari példa: Ha egy videó egymást követő képkockáit (amik 99%-ban megegyeznek) véletlenszerűen osztod szét a tanító- és teszthalmaz között, a hálózat nem általánosítani fog, hanem egyszerűen felismeri a szinte azonos képeket.
- A megoldás: Jelenet vagy útvonal (Sequence/Scene-based) alapú felosztás. Ha a "A" útvonal képei a tanítóhalmazban vannak, a "B" útvonal (amit teljesen más időben, más fényviszonyok között rögzített a kamera) menjen a teszthalmazba.
5.5.4. Ha stagnál a háló, és nem akar javulni a pontosság
- Ellenőrizd az adatok skálázását (Normalization): A neurális hálózatok gyűlölik a nagy számokat. Ha a pixelértékek 0 és 255 között vannak, a gradiensek felrobbanhatnak vagy a Tanh/Szigmoid rétegek azonnal telítődnek (eltűnő gradiens).
- Aranyszabály: Mindig skálázd a bemeneteket [0,1] vagy [−1,1] közé, vagy standardizáld őket (μ=0,σ=1).
- Tanulási ráta (LR) finomhangolás:
Túl magas LR: A veszteség vadul oszcillál, vagy az első epochnál lecsökken egy picit, majd megreked egy rossz szinten. Túl alacsony LR: A loss elképesztően lassan, szinte láthatatlanul csökken.
- Megoldás: Kezdj 10−3 (Adam esetén) vagy 10−1 (SGD esetén) értékkel, és használj tanulási ráta ütemezőt (Learning Rate Scheduler), ami a tanítás előrehaladtával fokozatosan csökkenti az LR-t (pl. ReduceLROnPlateau).
5.5.5. Címkekiegyensúlyozatlanság (Class Imbalance)
- A probléma: Az autós kameraképek 99%-án az úttest üres (nincs veszély). Ha a hálózatot arra tanítod, hogy döntse el, kell-e vészfékezni (igen/nem), a modell nagyon gyorsan rájön egy lusta csalásra: ha mindig "NEM"-et jósol, a pontossága 99%-os lesz, miközben a feladatát egyáltalán nem látja el.
- Gyakorlati fogások:
Ne a sima pontosságot (Accuracy) nézd! Kiegyensúlyozatlan adatoknál az F1-score, a Precision/Recall (Érzékenység) és az IoU az igazi mérőszámok. Használj súlyozott veszteségfüggvényt (pos_weight a BCE-ben), ami sokkal szigorúbban bünteti, ha a hálózat elvéti a ritka, de fontos (pozitív) osztályt.