2. óra Neurális háló alapok - CooperativeResearchPlatform/object_detection_for_aeb GitHub Wiki
Bevezetés a neurális hálózatokba
Ez a jegyzet a klasszikus képfeldolgozástól indul, majd a lineáris és logisztikus regresszión keresztül vezeti be a neurális hálózatok tanítását, kiértékelését és számítási komplexitását. A cél nem csupán a képletek használata, hanem annak megértése, hogy egy érzékelési feladatban mit tanul a modell, hogyan tanulja meg, és hogyan dönthető el, hogy megbízhatóan működik-e.
1. Klasszikus környezetérzékelés
1.1 Intuíció: kézzel tervezett feldolgozási lánc
A klasszikus vagy szabályalapú környezetérzékelésben a fejlesztő határozza meg, hogy a kamera képpontjaiból, a lidar vagy radar pontjaiból, illetve más szenzorjelekből milyen matematikai lépések vezetnek a kívánt objektumhoz. A rendszer tipikusan kézzel megválasztott szűrőkből, küszöbökből, geometriai feltételekből és heurisztikákból áll.
Például egy stopvonal-detektor a következő előfeltevéseket használhatja:
- a stopvonal világosabb az útfelületnél;
- a kép alsó, úttestet tartalmazó részén található;
- közel vízszintes és hosszú;
- összefüggő vagy morfológiai műveletekkel összekapcsolható komponens;
- perspektivikus transzformáció után közel téglalap alakú.
Ezek nem az adatokból megtanult szabályok. A fejlesztő választja meg őket, ezért a rendszer működése jól visszakövethető, ugyanakkor érzékeny lehet az útburkolat, a megvilágítás, az időjárás és a kamera beállításainak változására.
1.2 Példa: stopvonal detektálása kameraképen
Az alábbi feldolgozási lánc egy szintetikus, árnyékkal és szenorzajjal terhelt útképen szemlélteti a klasszikus megközelítést.
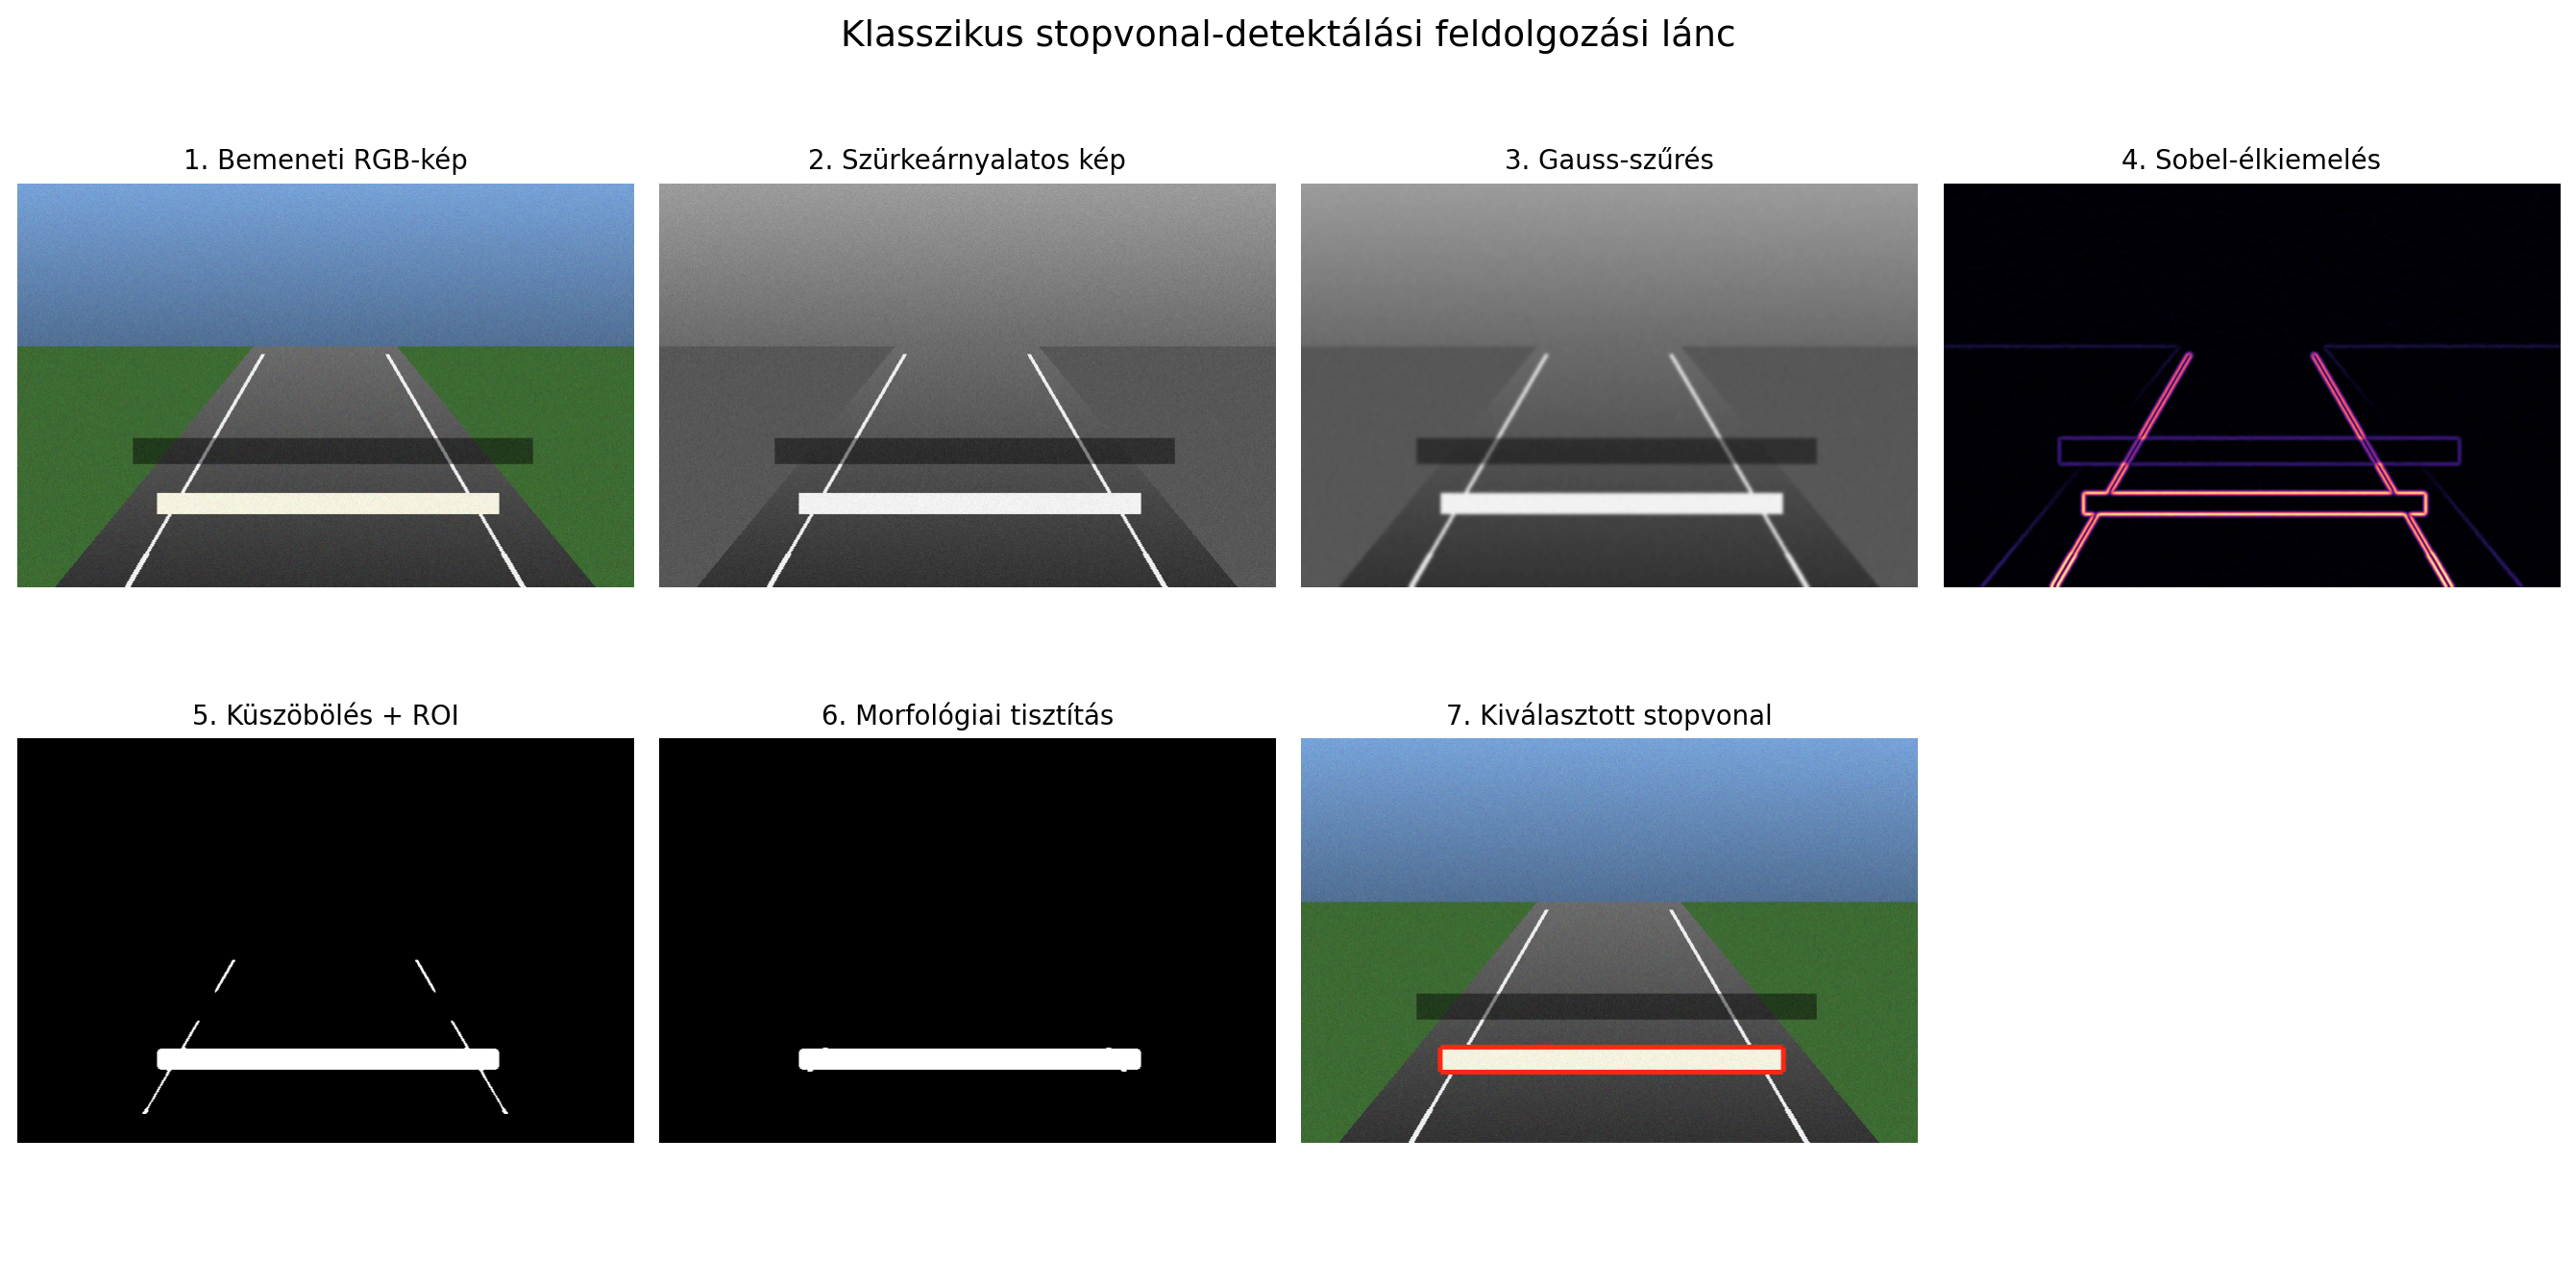
Az intuícióhoz elég a lánc szerepét megérteni:
- Előfeldolgozás: kalibráció, szürkeárnyalatos vagy más színtér, esetleg madártávlat.
- Szűrés: Gauss- vagy mediánszűrő csökkenti a szenorzajt.
- Jellemzőkinyerés: Sobel- vagy Canny-operátor éleket keres. Ezek kis konvolúciós maggal végzett lokális műveletek.
- Küszöbölés és ROI: bináris maszk marad a világos, útfelülethez tartozó képpontokból.
- Morfológia: a dilatáció összekapcsol, az erózió vékonyít; a zárás kitölti a stopvonal kisebb megszakadásait.
- Geometriai szabály: a rendszer hosszú, közel vízszintes, megfelelő helyen lévő komponenst választ.
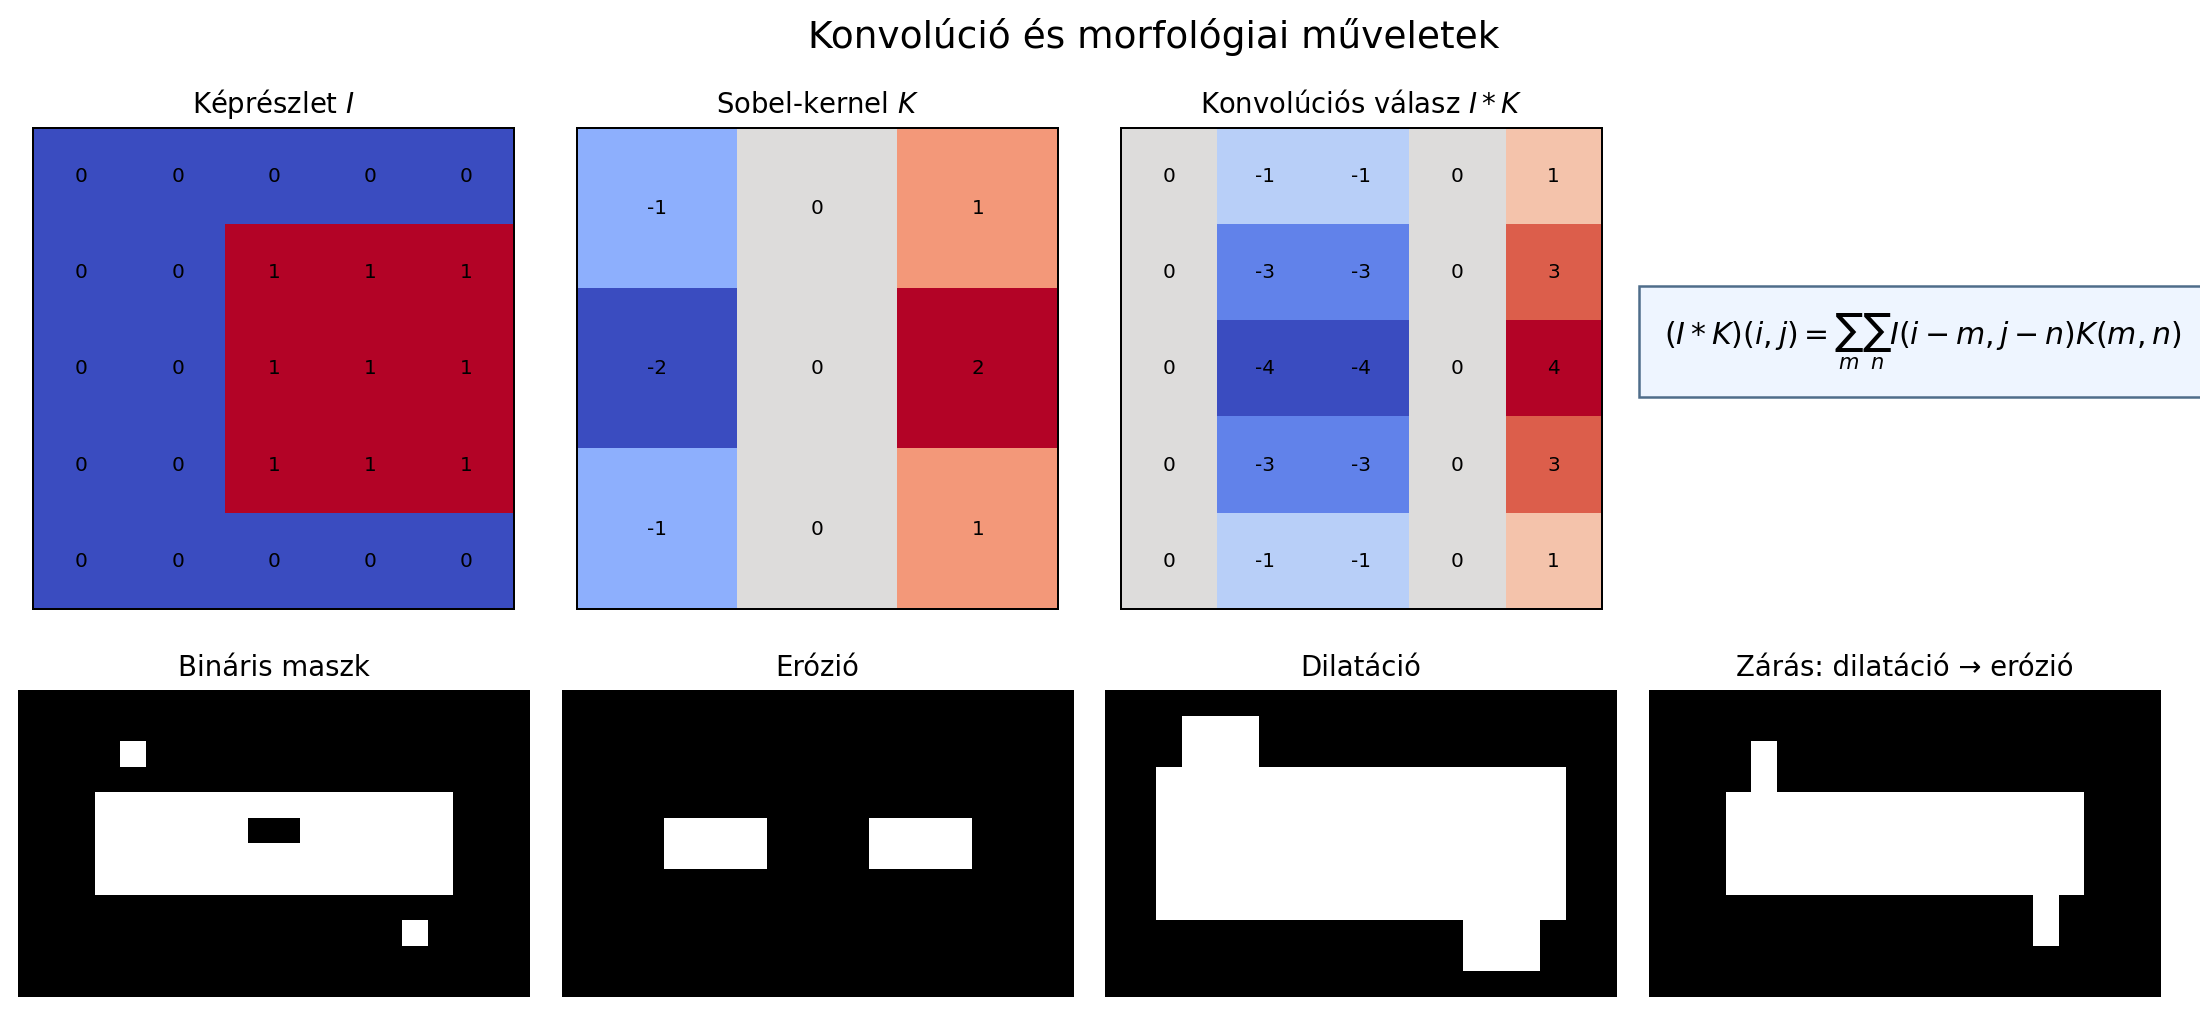
A konvolúció ugyanazt a kis $K$ magot csúsztatja végig a képen:
$$ (I*K)(i,j)=\sum_m\sum_n I(i-m,j-n)K(m,n). $$
A morfológiai műveletek egy választott strukturáló elem alapján módosítják a bináris maszk alakját. Mindkét esetben a fejlesztő dönti el, milyen lokális mintát tekint fontosnak.
1.3 A klasszikus rendszer erősségei és korlátai
Előnyök:
- minden döntés matematikai lépésekre vezethető vissza;
- kevés vagy semennyi címkézett adatot nem igényel;
- a futási idő és a memóriaigény jól becsülhető;
- egyszerű feladaton kis számítási kapacitással is működhet;
- fizikai és funkcionális biztonsági szabályok közvetlenül beépíthetők.
Korlátok:
- a kézzel választott küszöbök az alkalmazási tartomány változására érzékenyek;
- árnyék, kopott felfestés, ellenfény, eső és takarás új kivételeket hoz létre;
- a heurisztikák száma a feladat bonyolultságával gyorsan növekszik;
- nehéz egyetlen merev szabályrendszerrel minden ritka közlekedési helyzetet lefedni;
- a komponensek egymásra épülő hibái a végső eredményben összeadódhatnak.
A klasszikus algoritmusok nem tűntek el. A gyakorlatban gyakori a hibrid rendszer: a neurális háló detektál vagy szegmentál, majd geometriai ellenőrzések, pályakövetés, szenzorfúzió és biztonsági korlátok klasszikus algoritmusokra épülnek.
A továbbiak központi kérdése: hogyan váltható ki a kézzel választott jellemző és döntési szabály egy olyan parametrikus modellel, amely a megfelelő leképezést címkézett példákból tanulja meg?
2. Adatból tanuló modellek és lineáris regresszió
2.1 AI, gépi tanulás és mélytanulás
A fogalmak egymásba ágyazódnak:
- mesterséges intelligencia (AI): minden olyan módszer, amely intelligensnek tekintett döntést vagy viselkedést valósít meg;
- gépi tanulás (ML): a modell paramétereit adatok alapján becslő módszerek;
- neurális hálózat: egymásra épülő, tanulható affin transzformációk és nemlineáris aktivációk rendszere;
- mélytanulás (DL): több reprezentációs réteget tartalmazó neurális hálózatok tanítása.
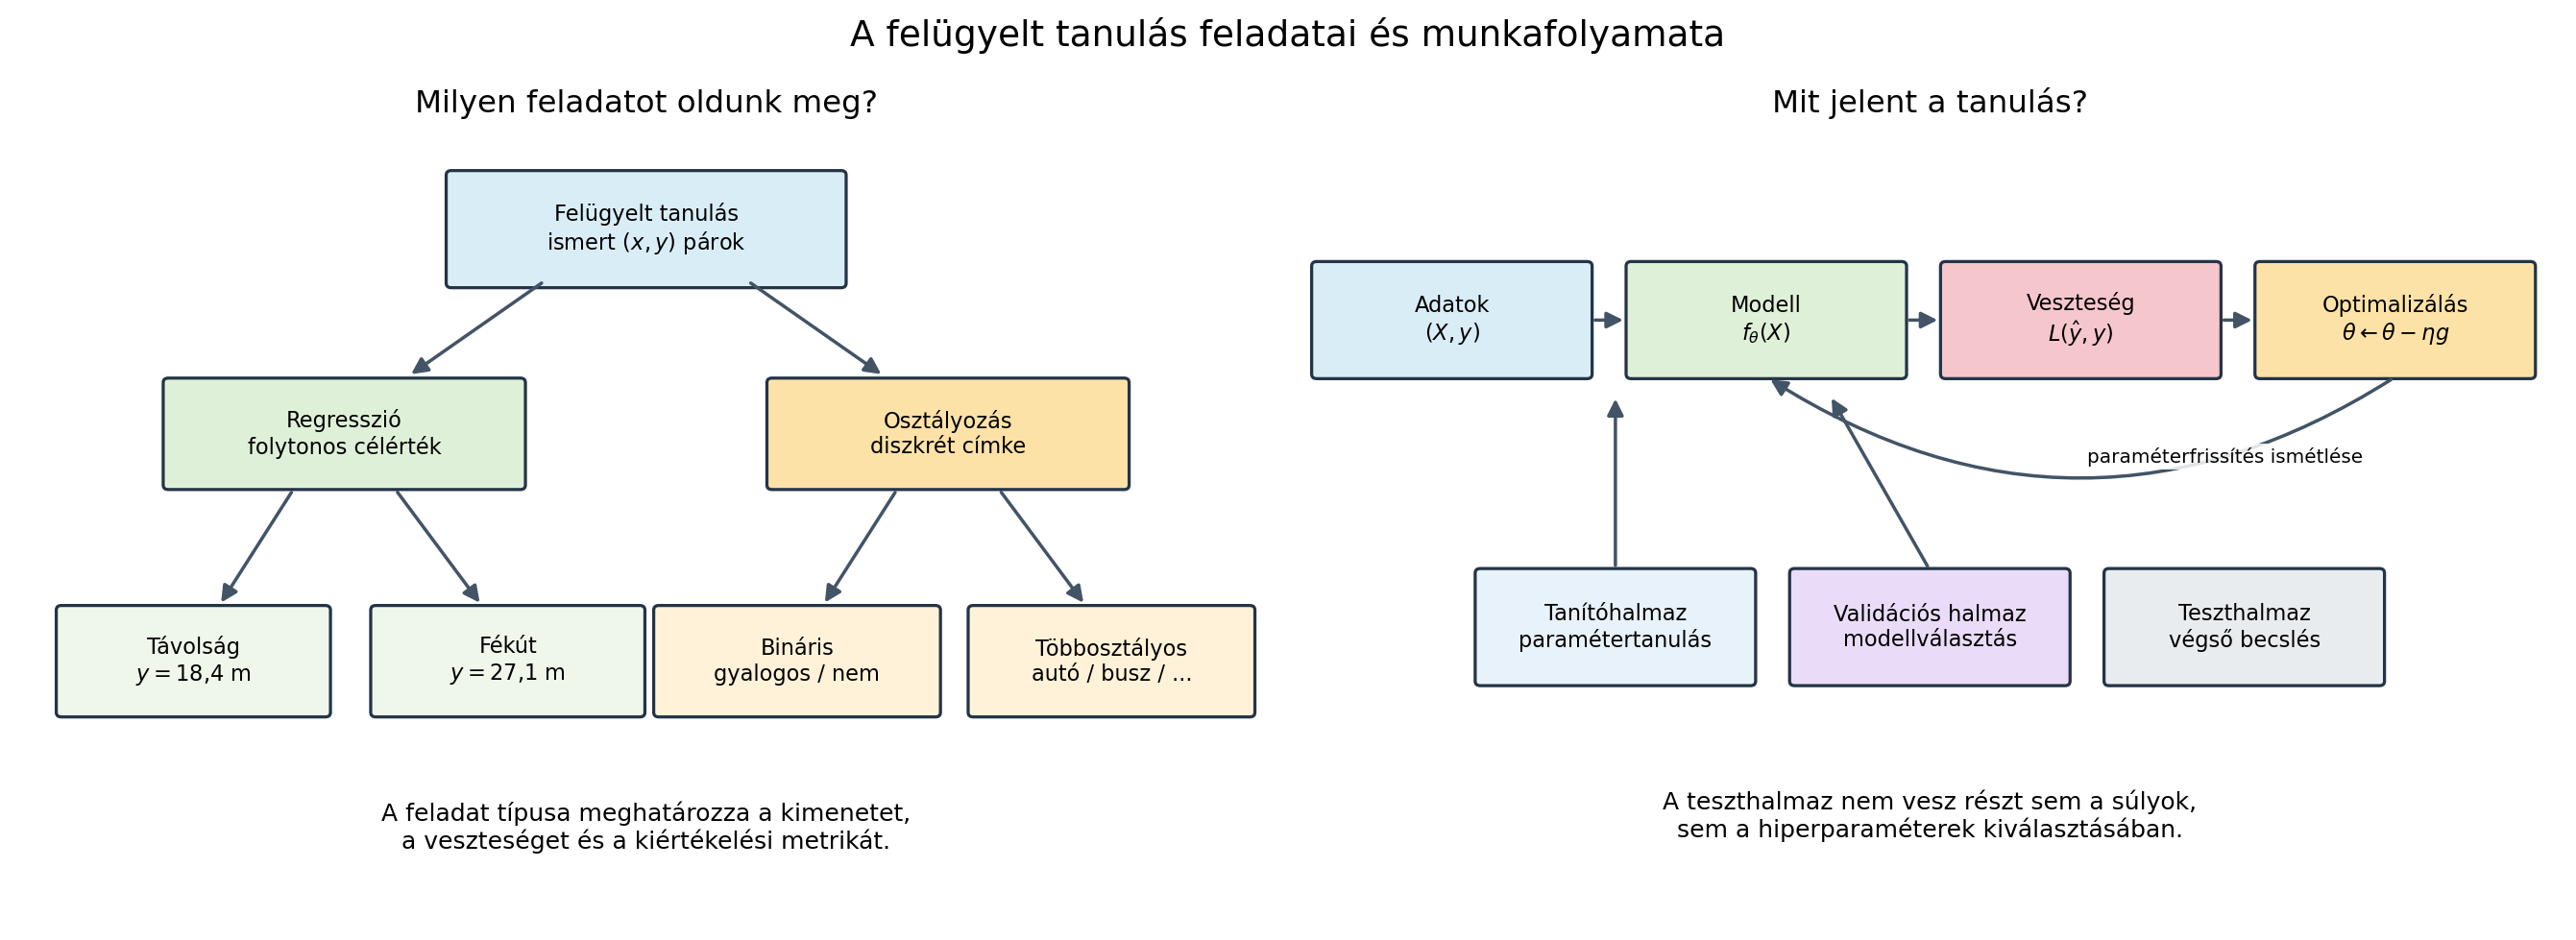
A tanulási paradigma szerint megkülönböztetünk felügyelt, felügyelet nélküli, önfelügyelt és megerősítéses tanulást. Ebben a fejezetben felügyelt tanulással foglalkozunk: minden bemenethez ismert célérték tartozik.
2.2 Regresszió és osztályozás
| Feladat | Kimenet | Példa járműkörnyezetben |
|---|---|---|
| Regresszió | folytonos szám | objektum távolsága, kormányzási szög, fékút |
| Bináris osztályozás | két osztály | gyalogos / nem gyalogos |
| Többosztályos osztályozás | egy címke több osztályból | autó / busz / kerékpár / gyalogos |
Mindkét esetben adott egy $n$ mintából és $d$ jellemzőből álló bemeneti mátrix:
$$ X=\begin{bmatrix} x_{11} & \cdots & x_{1d}\ \vdots & \ddots & \vdots\ x_{n1} & \cdots & x_{nd} \end{bmatrix}\in\mathbb{R}^{n\times d}. $$
A regressziós cél $\mathbf{y}\in\mathbb{R}^n$, az osztálycímke pedig például $y_i\in{0,1}$.
2.3 A felügyelt tanulás építőelemei
Egy felügyelt tanulási probléma nem pusztán egy neurális hálóból áll. A következő objektumokat világosan szét kell választani:
| Fogalom | Jelölés | Jelentés |
|---|---|---|
| Minta | $(\mathbf{x}^{(i)},y^{(i)})$ | egy megfigyelés a hozzá tartozó helyes válasszal |
| Jellemző | $x_j$ | a bemenet egy mérhető komponense |
| Címke vagy célérték | $y$ | amit a modellnek meg kell becsülnie |
| Modell | $f_{\boldsymbol{\theta}}$ | parametrikus leképezés a bemenetből a kimenetbe |
| Becslés | $\hat{y}=f_{\boldsymbol{\theta}}(\mathbf{x})$ | a modell aktuális kimenete |
| Paraméter | $\boldsymbol{\theta}$ | adatból tanult súlyok és eltolások |
| Hiperparaméter | például $\eta$, $B$, $h$ | a tanítás előtt vagy validációval választott beállítás |
| Veszteség | $\ell(\hat{y},y)$ | egy minta predikciós hibájának tanítható, deriválható mértéke |
| Költségfüggvény | $J(\boldsymbol{\theta})$ | a veszteségek aggregálása az adathalmazon |
| Mérőszám | például MAE, érzékenység | a teljesítmény értelmezhető jelentésére szolgál |
Minta, jellemző és címke
Egy AEB-példában $\mathbf{x}^{(i)}$ tartalmazhat képi jellemzőket, relatív sebességet és radar-távolságot. A címke lehet folytonos fékút, vagy bináris döntés arról, hogy veszélyes-e a helyzet. Az $i$ felső index a mintát, a $j$ alsó index a jellemzőt azonosítja.
Az egész tanítóhalmaz:
$$ \mathcal{D}{train}=\lbrace(\mathbf{x}^{(i)},y^{(i)})\rbrace{i=1}^{n}. $$
A modell nem az egyes mintákat akarja visszamondani, hanem olyan $f_{\boldsymbol{\theta}}$ leképezést keres, amely korábban nem látott, de ugyanabból a problémából származó bemeneteken is jól működik. Ez az általánosítás.
Empirikus kockázatminimalizálás
A tanítás matematikailag a paraméterek kiválasztása:
$$ \hat{\boldsymbol{\theta}} =\arg\min_{\boldsymbol{\theta}} J(\boldsymbol{\theta}), \qquad J(\boldsymbol{\theta})= \frac{1}{n}\sum_{i=1}^{n} \ell\left(f_{\boldsymbol{\theta}}(\mathbf{x}^{(i)}),y^{(i)}\right). $$
Ezt empirikus kockázatminimalizálásnak nevezzük: a valódi, ismeretlen adateloszláson mért várható hibát a rendelkezésre álló véges mintán közelítjük.
Tanító-, validációs és teszthalmaz
- A tanítóhalmaz alapján számítjuk a gradienst és frissítjük a paramétereket.
- A validációs halmaz alapján választunk architektúrát, tanulási rátát, regularizációt, küszöböt és leállítási időpontot.
- A teszthalmaz csak a végleges módszer egyszeri, elfogulatlan becslésére szolgál.
Ha a teszteredmény alapján új hiperparamétert próbálunk, a teszthalmaz gyakorlatilag validációs halmazzá válik. Videóadatoknál a szomszédos képkockák erős hasonlósága miatt az adatot jelenet vagy útvonal szerint célszerű felosztani, nem véletlen képkockánként.
A feladat határozza meg a kimenetet
| Feladat | Modellkimenet | Tanítási veszteség | Gyakori mérőszám |
|---|---|---|---|
| Skalár regresszió | egy valós szám | MSE, MAE vagy Huber | MAE, RMSE, $R^2$ |
| Bináris osztályozás | egy logit | bináris keresztentrópia | pozitív prediktív érték, érzékenység, F1, ROC-AUC |
| $K$ osztályos osztályozás | $K$ logit | softmax keresztentrópia | helyes besorolási arány, makro-F1 |
A logit a bináris esetben a becsült esély logaritmusa, $\log(p/(1-p))$; a modell nyers kimeneteként tetszőleges valós szám lehet. A szigmoid vagy a softmax alakítja valószínűséggé. A tanítási veszteségnek használható gradienst vagy szubgradienst kell adnia, a jelentett mérőszámnak viszont elsősorban a feladat szempontjából kell értelmezhetőnek lennie.
2.4 A lineáris regresszió modellje
Egyetlen jellemző esetén $\hat{y}_i=wx_i+b$. Több jellemzővel:
$$ \hat{y}_i=\mathbf{x}_i^T\mathbf{w}+b. $$
Az eltolásparaméter beépíthető a paramétervektorba. Egy csupa egyes oszloppal kibővített $\tilde{X}=[X\ \mathbf{1}]$ mátrix és $\boldsymbol{\theta}=[\mathbf{w}^T\ b]^T$ mellett
$$ \hat{\mathbf{y}}=\tilde{X}\boldsymbol{\theta}. $$
2.5 Legkisebb négyzetes becslés
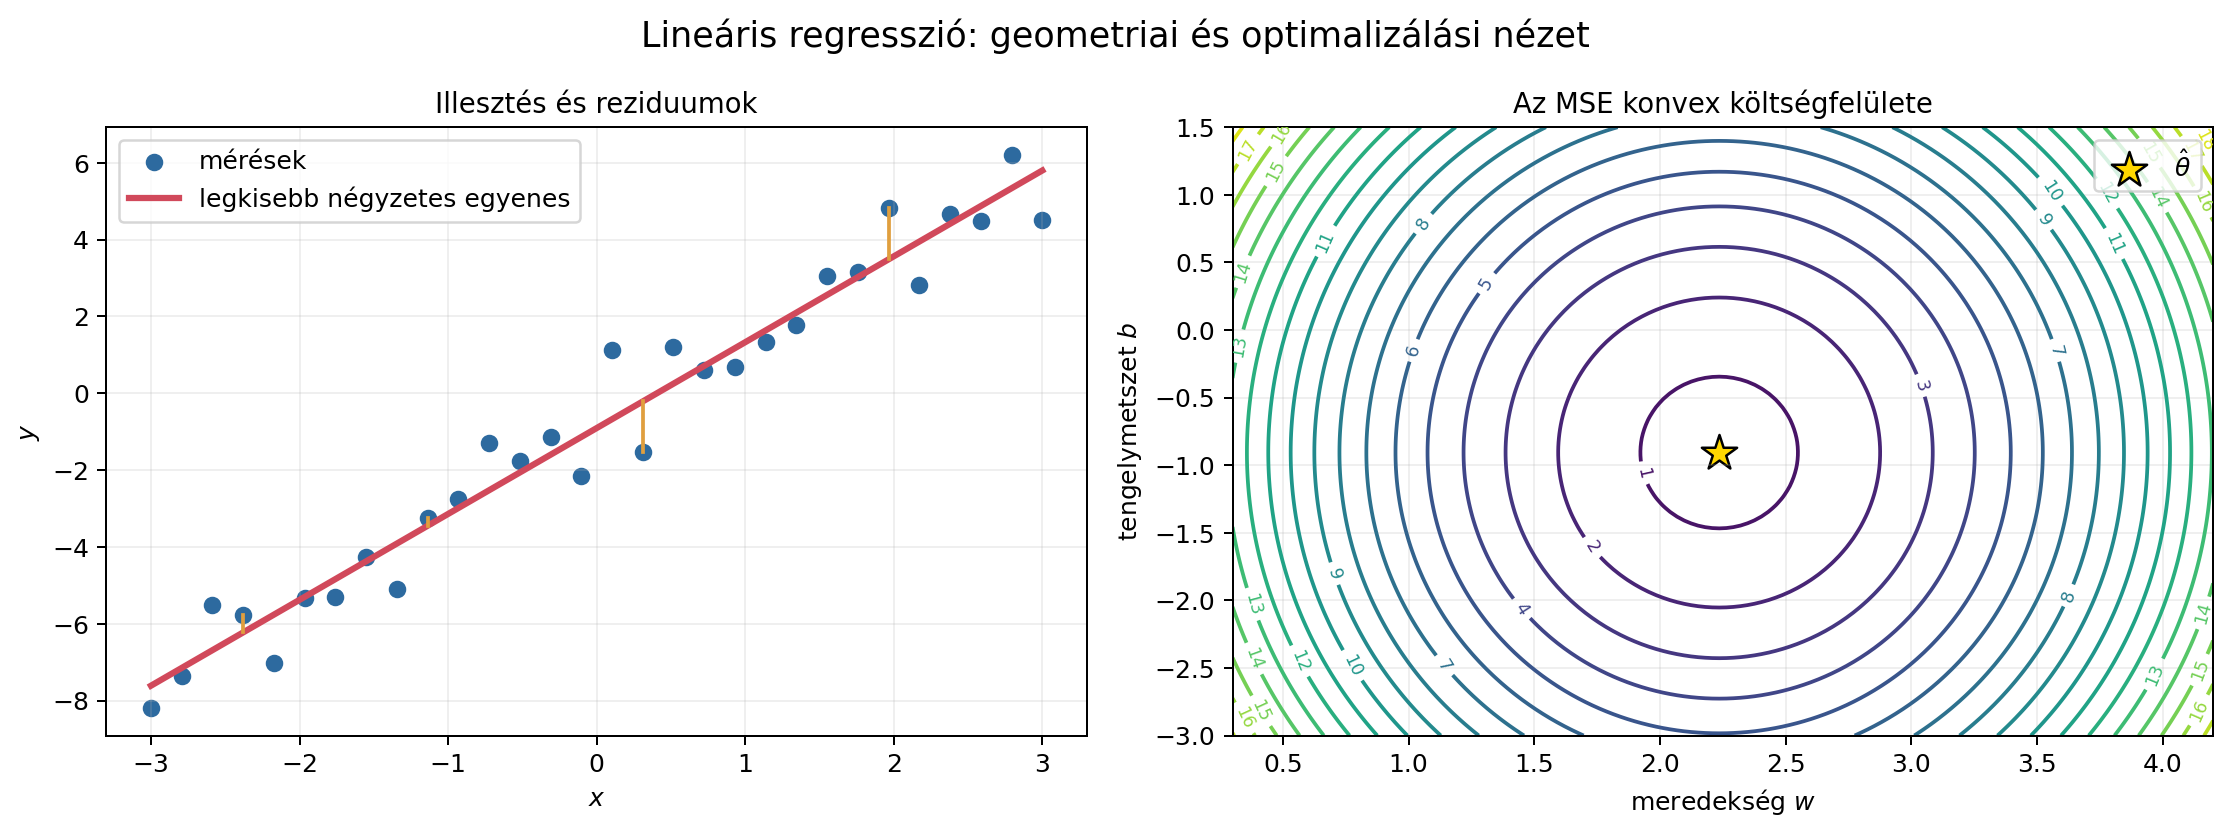
A reziduum $e_i=y_i-\hat{y}_i$. A legkisebb négyzetek módszere a reziduumok négyzetösszegét minimalizálja:
$$ J(\boldsymbol{\theta})= \lVert\tilde{X}\boldsymbol{\theta}-\mathbf{y}\rVert_2^2. $$
Az MSE csak az $1/n$ konstansban különbözik ettől, ezért ugyanott minimális:
$$ L(\boldsymbol{\theta})= \frac{1}{n}\sum_{i=1}^{n}(\hat{y}_i-y_i)^2. $$
Az analitikus megoldás levezetése
A költségfüggvény kifejtve:
$$ J(\boldsymbol{\theta})= (\tilde{X}\boldsymbol{\theta}-\mathbf{y})^T (\tilde{X}\boldsymbol{\theta}-\mathbf{y}). $$
A paramétervektor szerinti gradiens:
$$ \nabla_{\boldsymbol{\theta}}J =2\tilde{X}^T(\tilde{X}\boldsymbol{\theta}-\mathbf{y}). $$
A minimumban a gradiens nulla, így megkapjuk a normálegyenletet:
$$ \tilde{X}^T\tilde{X}\boldsymbol{\theta} =\tilde{X}^T\mathbf{y}. $$
Ha $\tilde{X}^T\tilde{X}$ invertálható, akkor
$$ \boxed{ \hat{\boldsymbol{\theta}} =(\tilde{X}^T\tilde{X})^{-1}\tilde{X}^T\mathbf{y} }. $$
Egyetlen jellemző esetén a normálegyenletből a jól ismert skalár alak következik:
$$ \hat{w}= \frac{\sum_{i=1}^{n}(x_i-\bar{x})(y_i-\bar{y})} {\sum_{i=1}^{n}(x_i-\bar{x})^2}, \qquad \hat{b}=\bar{y}-\hat{w}\bar{x}. $$
A meredekség tehát az $x$ és $y$ együtt változását méri az $x$ varianciájához viszonyítva. Ha minden $x_i$ azonos, a nevező nulla: az adatokból nem azonosítható meredekség.
Geometriailag $\tilde{X}\hat{\boldsymbol{\theta}}$ a $\mathbf{y}$ vektor merőleges vetülete $\tilde{X}$ oszlopterére. Ezért az optimális reziduum ortogonális minden jellemzőoszlopra:
$$ \tilde{X}^T(\mathbf{y}-\tilde{X}\hat{\boldsymbol{\theta}})=0. $$
A legkisebb négyzetes becslés önmagában nem bizonyít okozati kapcsolatot. A lineáris modell azt feltételezi, hogy a feltételes átlag megfelelően közelíthető lineárisan; a bizonytalansági állításokhoz további feltevések szükségesek a reziduumokról. Predikcióhoz a maradékok normalitása nem feltétlenül szükséges, de az erős kiugró értékek az MSE négyzetes büntetése miatt jelentősen elmozdíthatják az illesztést.
Mi történik, ha nincs inverz?
$\tilde{X}^T\tilde{X}$ szinguláris vagy rosszul kondicionált lehet, ha például két jellemző lineárisan függ egymástól. Gyakorlatban nem célszerű explicit inverzt számítani. Stabilabb lehet a QR-felbontás, az SVD, a Moore-Penrose pszeudoinverz vagy a numpy.linalg.lstsq használata.
L2-regularizált ridge regressziónál, a konstans tagot külön kezelve,
$$ J_{ridge}=\lVert X\mathbf{w}+b\mathbf{1}-\mathbf{y}\rVert_2^2 +\lambda\lVert\mathbf{w}\rVert_2^2, $$
ahol a $b$ konstans tagot szokás szerint nem regularizáljuk. Központosított $X$ és $\mathbf{y}$ esetén $b=0$, és
$$ \hat{\mathbf{w}}=(X^TX+\lambda I)^{-1}X^T\mathbf{y}. $$
2.6 Miért kell mégis iteratív optimalizálás?
A normálegyenlet kis lineáris problémán kiváló, de a mátrixfelbontás nagy $d$ mellett drága, a neurális háló pedig nemlineáris és nincs általános zárt alakú megoldása. Ezért használunk gradiens módszereket:
$$ \boldsymbol{\theta}_{t+1} =\boldsymbol{\theta}t-\eta\nabla{\boldsymbol{\theta}}L. $$
Az $\eta$ tanulási ráta. A teljes tanítóhalmaz gradiensét használó eljárás a teljes köteges gradiensmódszer, egyetlen mintáé a sztochasztikus gradiensmódszer (SGD), a gyakorlatban leggyakoribb kompromisszum pedig a miniköteges gradiensmódszer.
A jellemzők standardizálása
$$ x'_j=\frac{x_j-\mu_j}{\sigma_j} $$
kiegyensúlyozottabb költségfelületet és gyorsabb optimalizálást eredményezhet. A $\mu_j$ és $\sigma_j$ értékeket mindig csak a tanítóhalmazból szabad becsülni.
3. A perceptrontól a logisztikus regresszióig
3.1 A perceptron mint alapvető számítási egység
A „perceptron” szót két közeli értelemben használják:
- A klasszikus perceptron lineáris pontszámot és kemény küszöböt használ.
- A modern neurális háló neuronja ugyanilyen affin transzformációt, majd választott aktivációs függvényt alkalmaz.
Mindkettő közös lineáris része:
$$ z=\mathbf{w}^T\mathbf{x}+b =\sum_{j=1}^{d}w_jx_j+b. $$
A számítás két lépésből áll:
- Preaktiváció: a neuron súlyozottan összegzi a bemeneteket, majd hozzáadja az eltolásparamétert.
- Aktiváció: $a=\phi(z)$ meghatározza, milyen kimenetet adjon a neuron.
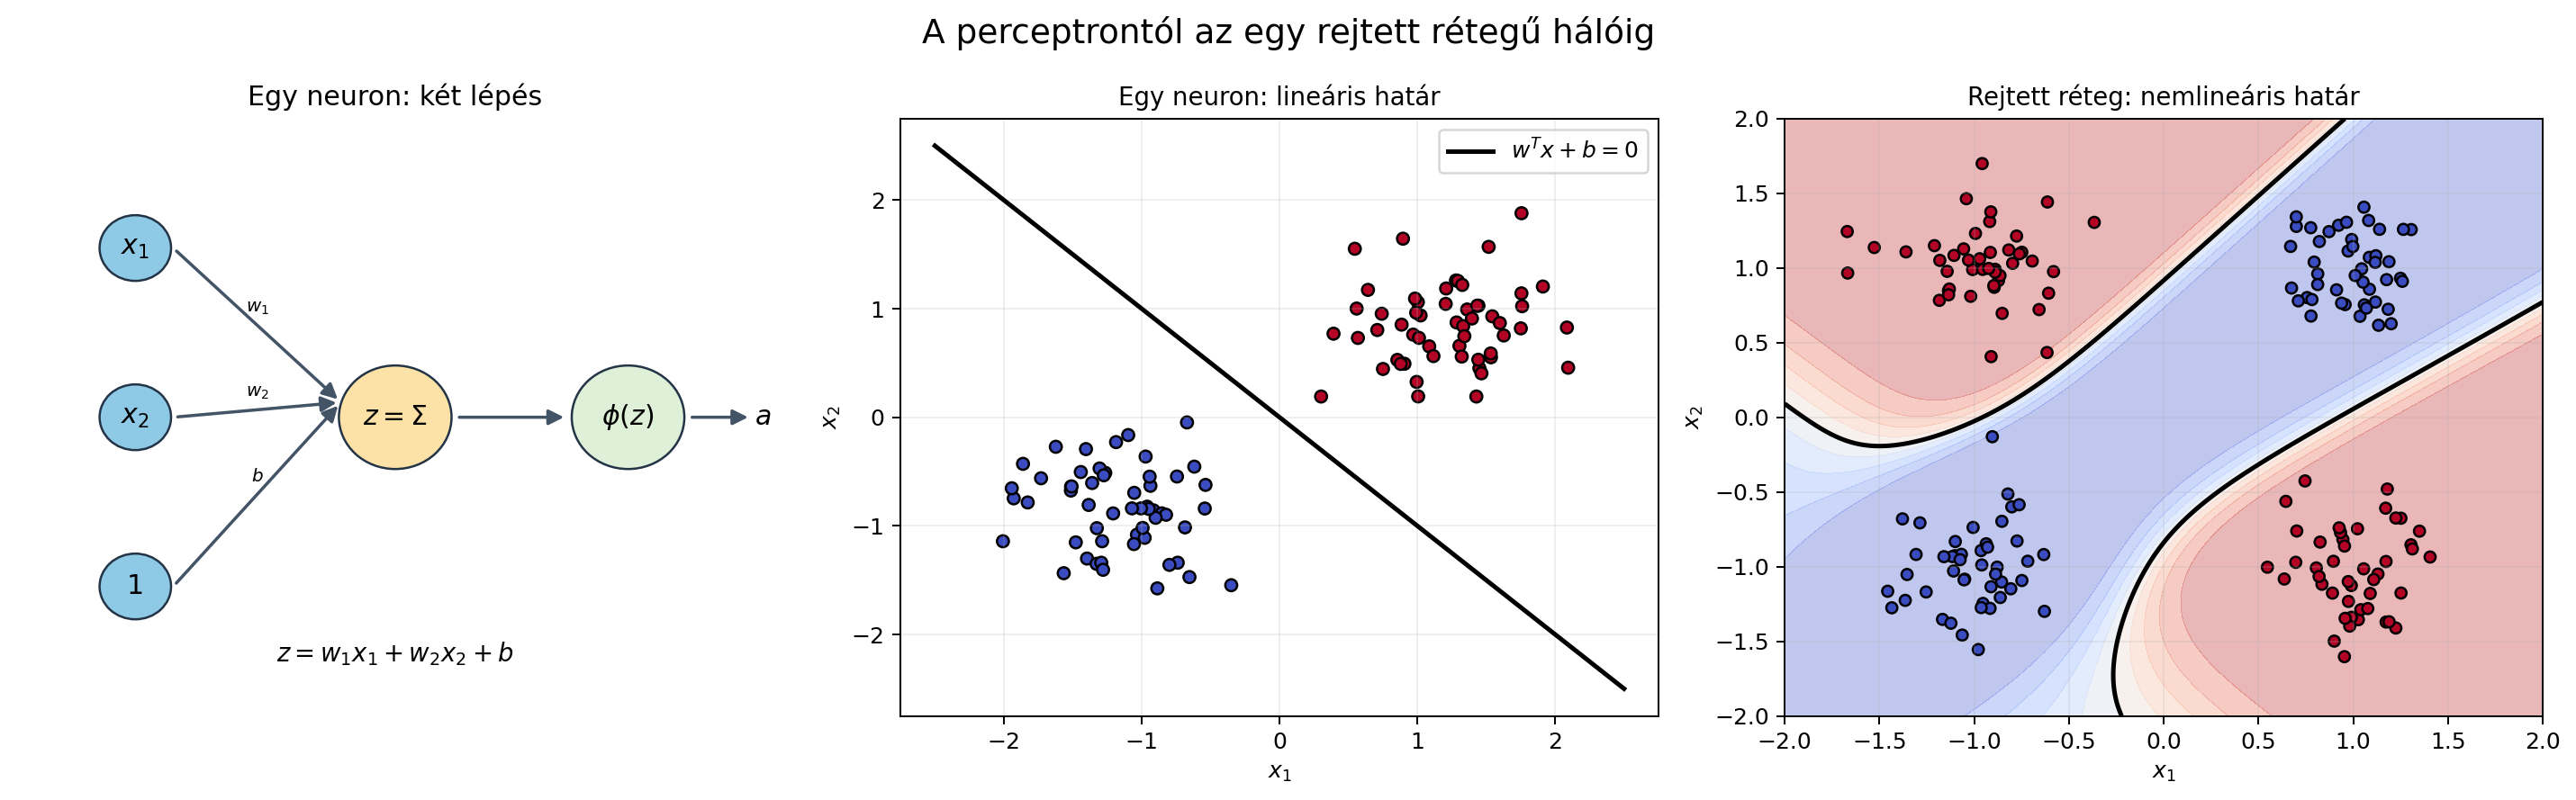
A $w_j$ súly előjele és nagysága azt írja le, hogyan változik $z$, ha az $x_j$ jellemző nő. Az eltolásparaméter nem egy bemeneti mérés súlya, hanem a döntési határ eltolását teszi lehetővé; felfogható egy állandó $x_0=1$ bemenet $w_0=b$ súlyaként.
Geometriai jelentés
A
$$ \mathbf{w}^T\mathbf{x}+b=0 $$
egyenlet hipersíkot definiál. A $\mathbf{w}$ vektor merőleges a hipersíkra, $b$ pedig annak origótól való eltolását szabályozza. A hipersík két oldalán a logit előjele eltér. Egyetlen neuron ezért csak lineáris döntési határt tud létrehozni az eredeti jellemzőtérben.
A klasszikus perceptron aktivációja kemény lépcsőfüggvény:
$$ \hat{y}=\mathbb{1}[z\geq0]. $$
Ez jól értelmezhető döntés, de a deriváltja majdnem mindenhol nulla, a küszöbnél pedig nem definiált. Gradiensalapú tanításhoz ezért sima veszteséget és tipikusan differenciálható aktivációt használunk.
3.2 Ugyanaz a neuron, eltérő feladat
Az affin rész nem dönti el, hogy regressziót vagy osztályozást végzünk. Ezt a kimeneti aktiváció és a veszteség együtt határozza meg.
Regressziós neuron
Lineáris kimenettel $\phi(z)=z$:
$$ \hat{y}=\mathbf{w}^T\mathbf{x}+b. $$
Ez pontosan a lineáris regresszió. A négyzetes veszteség népességszintű minimumhelye a feltételes várható érték, $\mathbb{E}[Y\mid X=x]$; a lineáris modell ezt csak a lineáris függvények osztályán belül közelíti.
Bináris osztályozó neuron
Szigmoid aktivációval:
$$ \hat{p}=\sigma(z)\in(0,1), $$
így a kimenet a pozitív osztály becsült valószínűségeként értelmezhető. Ez a logisztikus regresszió. A név ellenére osztályozási módszer.
Miért kell rejtett réteg?
Ha az osztályok XOR-szerűen vagy koncentrikus tartományokban helyezkednek el, egy hipersík nem választja szét őket. A rejtett neuronok különböző lineáris részproblémákat tanulnak, a kimeneti neuron pedig ezek aktivációit kombinálja. A fejezet eleji ábra jobb oldala ezt szemlélteti.
3.3 Lineáris pontszámból valószínűség
Bináris osztályozáskor először lineáris logitot számítunk:
$$ z=\mathbf{x}^T\mathbf{w}+b. $$
A szigmoid függvény ezt a $(0,1)$ intervallumba képezi:
$$ p=P(y=1\mid\mathbf{x})=\sigma(z)=\frac{1}{1+e^{-z}}. $$
A $p\geq 0{,}5$ döntési szabály ekvivalens a $z\geq0$ feltétellel. Ezért a logisztikus regresszió döntési határa
$$ \mathbf{x}^T\mathbf{w}+b=0, $$
ami kétdimenziós bemenetnél egyenes, háromdimenziósnál sík, általánosan hipersík.
3.4 A legnagyobb valószínűség elve és a bináris keresztentrópia
Egy Bernoulli-eloszlású címke valószínűsége:
$$ P(y_i\mid\mathbf{x}_i) =p_i^{y_i}(1-p_i)^{1-y_i}. $$
Feltételesen független minták együttes valószínűsége az egyedi valószínűségek szorzata. Ennek maximalizálása helyett numerikusan kényelmesebb az együttes valószínűség negatív logaritmusát minimalizálni:
$$ L_{BCE}=-\frac{1}{n}\sum_{i=1}^{n} \left[y_i\log p_i+(1-y_i)\log(1-p_i)\right]. $$
Ez a bináris keresztentrópia. A négyzetes hibával szemben közvetlenül valószínűségi modellből származik, és lineáris logit esetén konvex a paraméterekben.
Gyakorlatban a szigmoidot és a BCE-t egyetlen numerikusan stabil műveletben számítjuk. PyTorchban erre szolgál a BCEWithLogitsLoss: bemenetként nyers logitot, nem előre kiszámított valószínűséget vár.
Miért nem a pontosságot minimalizáljuk?
A helyes besorolási arány a küszöb átlépésekor ugrik, egyébként állandó. Emiatt nincs használható gradiense. A BCE folytonosan jelzi, mennyire magabiztos és mennyire hibás a becslés. Például $y=1$ mellett $p=0{,}49$ és $p=0{,}01$ ugyanúgy hibás címkét ad $0{,}5$-ös küszöbnél, de a második sokkal nagyobb BCE-veszteséget kap.
Többosztályos kiterjesztés
$K$ kölcsönösen kizáró osztályhoz a modell $K$ logitot ad. A softmax:
$$ p_k=\frac{e^{z_k}}{\sum_{j=1}^{K}e^{z_j}}, \qquad \sum_{k=1}^{K}p_k=1. $$
One-hot címkével a keresztentrópia
$$ \ell=-\sum_{k=1}^{K}y_k\log p_k =-\log p_{helyes\ osztály}. $$
Numerikus stabilitás miatt a logitokból először levonható a legnagyobb logit: $\mathrm{softmax}(\mathbf{z})=\mathrm{softmax}(\mathbf{z}-\max_j z_j)$. A keretrendszerek CrossEntropyLoss művelete közvetlenül logitokat vár.
3.5 Vektorizáció több mintán
Egyetlen minta képletei segítik az intuíciót, de a tanítás egész minikötegen fut. Legyenek a minták $X\in\mathbb{R}^{B\times d}$ soraiban, $\mathbf{w}\in\mathbb{R}^{d}$, $\mathbf{y}\in\mathbb{R}^{B}$. Ekkor
$$ \mathbf{z}=X\mathbf{w}+b\mathbf{1}, \qquad \mathbf{p}=\sigma(\mathbf{z}). $$
A miniköteg átlagos BCE-vesztesége:
$$ J=-\frac{1}{B}\sum_{i=1}^{B} \left[y_i\log p_i+(1-y_i)\log(1-p_i)\right]. $$
A teljes gradiens két mátrixműveletre egyszerűsödik:
$$ \boxed{ \frac{\partial J}{\partial\mathbf{w}} =\frac{1}{B}X^T(\mathbf{p}-\mathbf{y}) }, \qquad \boxed{ \frac{\partial J}{\partial b} =\frac{1}{B}\sum_{i=1}^{B}(p_i-y_i) }. $$
A vektorizáció nem másik matematikai modell: ugyanazokat a műveleteket rendezi hatékony tömbműveletekbe. A GPU-k és gyorsított lineárisalgebra-könyvtárak erre optimalizáltak.
3.6 Számítási gráf
A modell számítása elemi műveletek irányított gráfjaként írható le. A csomópontok tenzorok vagy műveletek, az élek pedig azt jelzik, hogy egy eredmény mely korábbi értékektől függ.
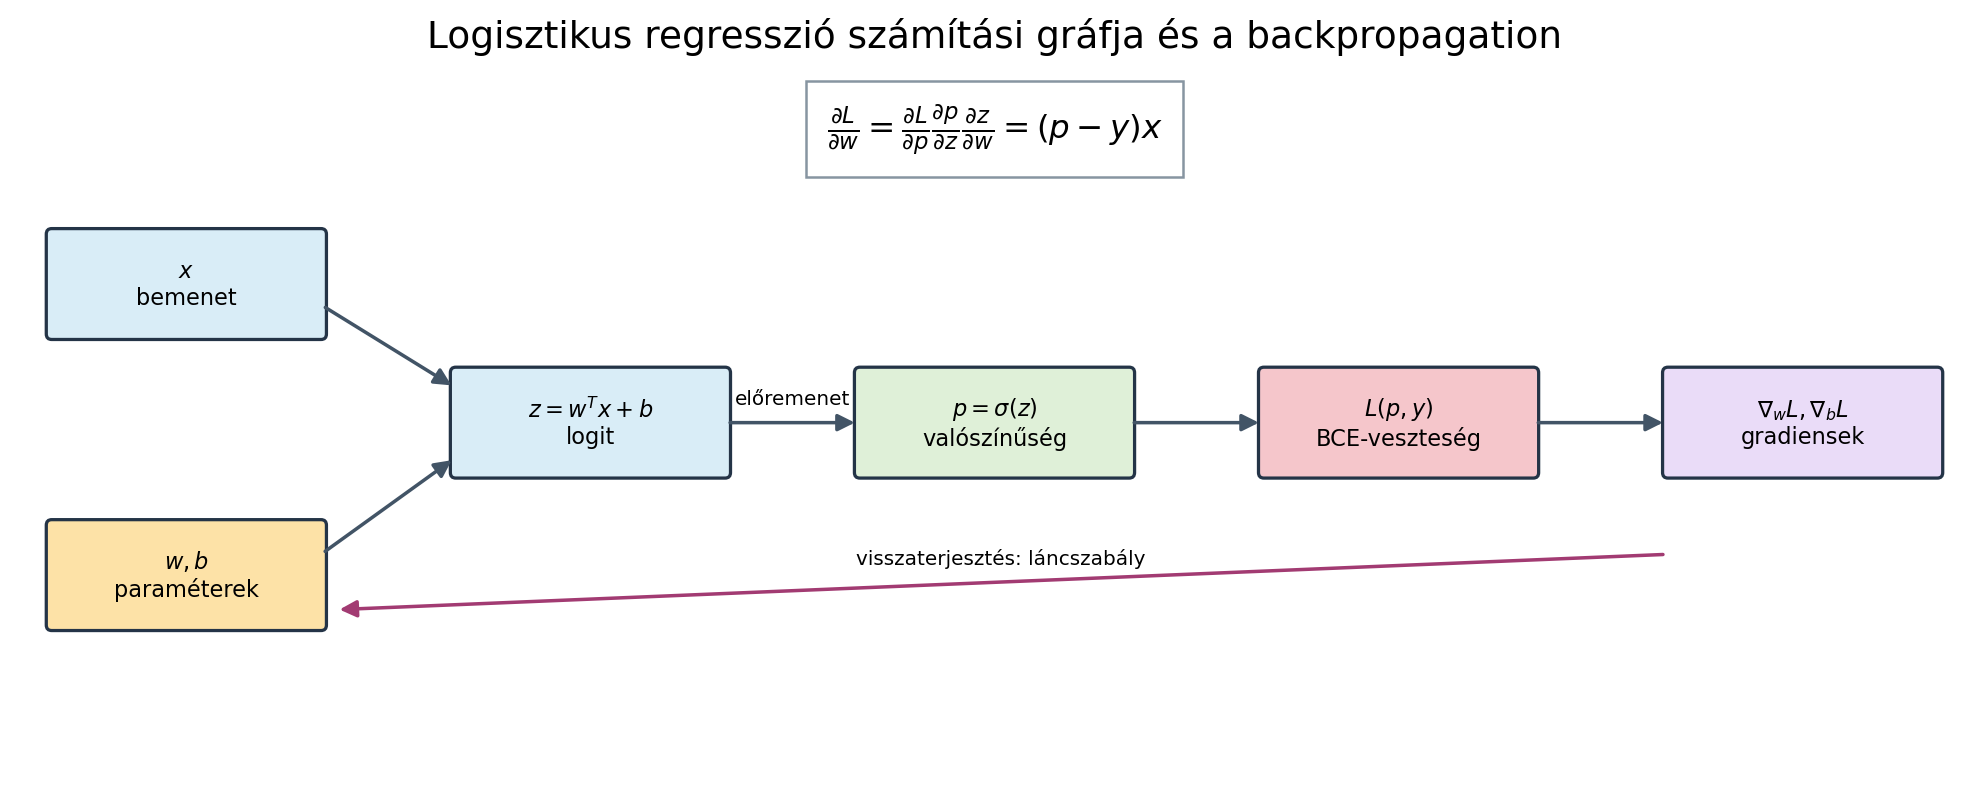
Az előreterjesztés sorrendje:
- $z=\mathbf{x}^T\mathbf{w}+b$;
- $p=\sigma(z)$;
- $L=L(p,y)$.
A visszaterjesztés ugyanazon gráfon fordított sorrendben alkalmazza a láncszabályt.
3.7 Láncszabály és a logisztikus regresszió gradiense
Egy minta esetén:
$$ \frac{\partial L}{\partial w_j} =\frac{\partial L}{\partial p} \frac{\partial p}{\partial z} \frac{\partial z}{\partial w_j}. $$
A szigmoid deriváltja $\partial p/\partial z=p(1-p)$. A BCE és szigmoid deriváltjai egyszerűsödnek:
$$ \frac{\partial L}{\partial z}=p-y. $$
Mivel $\partial z/\partial\mathbf{w}=\mathbf{x}$ és $\partial z/\partial b=1$,
$$ \frac{\partial L}{\partial\mathbf{w}}=(p-y)\mathbf{x}, \qquad \frac{\partial L}{\partial b}=p-y. $$
Miniköteg esetén a minták gradiensét átlagoljuk. A visszaterjesztés tehát nem külön optimalizáló algoritmus: hatékony eljárás a gradiensek számítására. Az SGD vagy az Adam ezt a gradienst használja a paraméterek frissítésére.
Egy paraméterfrissítés
Ha a tanulási ráta $\eta$, akkor
$$ \mathbf{w}\leftarrow\mathbf{w}-\eta\frac{\partial J}{\partial\mathbf{w}}, \qquad b\leftarrow b-\eta\frac{\partial J}{\partial b}. $$
Az euklideszi norma szerint egységnyi lépéshossz mellett a negatív gradiens adja a veszteség leggyorsabb lokális csökkenésének irányát. A gradiens megadja az irányt és az érzékenységet, a tanulási ráta pedig a lépés hosszát.
Végigszámolt példa egy neuronra
Legyen $\mathbf{x}=(2,-1)^T$, $\mathbf{w}=(0{,}6,0{,}4)^T$, $b=-0{,}1$ és $y=1$.
Az előremenet:
$$ z=0{,}6\cdot2+0{,}4\cdot(-1)-0{,}1=0{,}7, $$
$$ p=\sigma(0{,}7)\approx0{,}668, \qquad \ell=-\log(0{,}668)\approx0{,}403. $$
A visszaterjesztés:
$$ dz=p-y\approx-0{,}332, $$
$$ d\mathbf{w}=dz,\mathbf{x}=(-0{,}664,0{,}332)^T, \qquad db=-0{,}332. $$
$\eta=0{,}1$ tanulási rátával:
$$ \mathbf{w}{new}=\mathbf{w}-\eta d\mathbf{w} =(0{,}6664,0{,}3668)^T, \qquad b{new}=-0{,}0668. $$
Az új paraméterekkel $p\approx0{,}711$, a veszteség pedig körülbelül $0{,}341$: egy kis lépés valóban a helyes irányba mozdította a modellt.
3.8 Automatikus deriválás a keretrendszerekben
A PyTorch, TensorFlow és JAX a végrehajtott tenzorműveletekből számítási gráfot épít, és minden támogatott művelethez ismeri a lokális deriváltat.
PyTorchban a tipikus sorrend:
logits = model(features)           # előremenet
loss = loss_function(logits, labels)

optimizer.zero_grad()              # régi gradiensek törlése
loss.backward()                    # visszaterjesztés
optimizer.step()                   # paraméterfrissítés
Fontos fogalmak:
requires_grad=True: a rendszer kövesse az adott tenzor szerinti deriváltakat;.grad: a visszaterjesztés után tárolt gradiens;.backward(): fordított módú automatikus deriválás;torch.no_grad(): a gradienskövetés kikapcsolása kiértékeléskor;detach(): tenzor leválasztása az aktuális számítási gráfról;zero_grad(): szükséges, mert a PyTorch alapértelmezésben összeadja a gradienseket.
Az autograd a deriválást automatizálja, de nem választ helyettünk megfelelő veszteséget, tanulási rátát, architektúrát vagy adatfelosztást.
4. Egy rejtett rétegű neurális háló és tanítása
4.1 Mit jelent az, hogy „egy réteg”?
A terminológia nem minden forrásban azonos. Ebben a jegyzetben:
- a bemeneti réteg nem végez tanulható transzformációt, csak az $x_j$ jellemzőket jelöli;
- a rejtett réteg kimenete közvetlenül nem célérték, hanem tanult reprezentáció;
- a kimeneti réteg a feladathoz szükséges predikciót állítja elő;
- az egy rejtett rétegű háló két tanulható affin transzformációt tartalmaz.
Az ilyen modellt gyakran többrétegű perceptronnak (multilayer perceptron, MLP) nevezik. A „single-layer perceptron” szigorú értelemben rejtett réteg nélküli lineáris modellt jelent; a gyakorlati notebook „egyrétegű háló” alatt egy rejtett réteget ért.
Egy rejtett neuron ugyanazt a kétlépéses műveletet végzi, mint az előző fejezet neuronja:
$$ z_j^{[1]}=(\mathbf{w}_j^{[1]})^T\mathbf{x}+b_j^{[1]}, \qquad a_j^{[1]}=\phi(z_j^{[1]}). $$
A felső $[1]$ index a réteget, az alsó $j$ index a rétegen belüli neuront jelöli. Minden rejtett neuron más súlyokkal ugyanabból a bemenetből képez új jellemzőt.
Nemlineáris aktiváció nélkül több egymás utáni lineáris réteg összevonható egyetlen lineáris transzformációvá:
$$ W_2(W_1x+b_1)+b_2 =(W_2W_1)x+(W_2b_1+b_2). $$
Ezért a mélység önmagában, aktiváció nélkül nem növeli a modell kifejezőerejét.
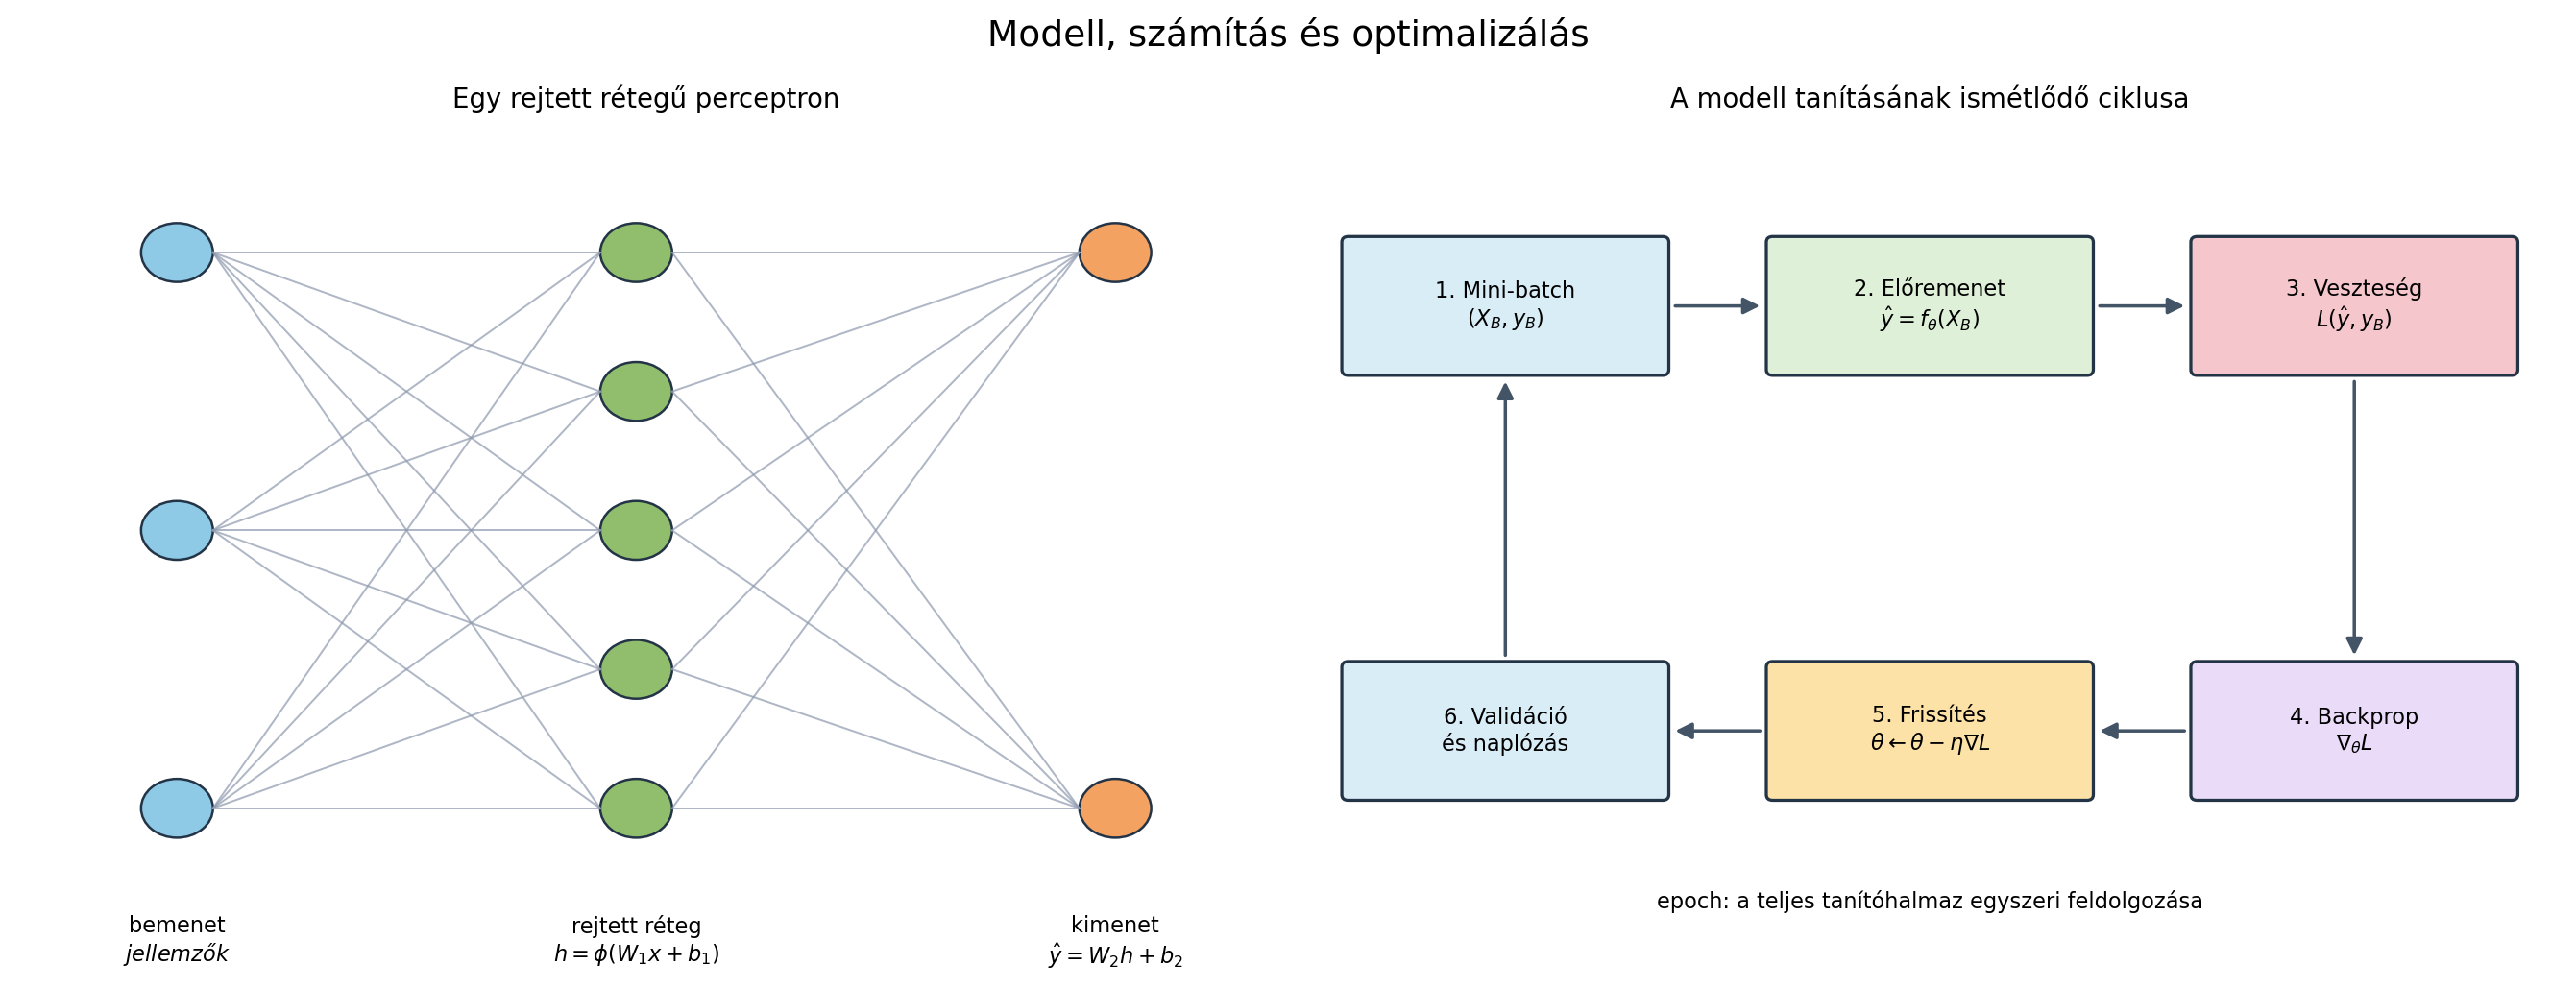
4.2 Egy rejtett rétegű perceptron
Legyen a miniköteg $X\in\mathbb{R}^{B\times d}$, a rejtett neuronok száma $h$, a kimenetek száma $k$. Az előreterjesztés:
$$ Z_1=XW_1+\mathbf{1}b_1^T,\qquad H=\phi(Z_1), $$
$$ Z_2=HW_2+\mathbf{1}b_2^T, $$
ahol $\mathbf{1}\in\mathbb{R}^{B}$, így az eltolásvektor minden mintához hozzáadódik.
A méretek:
| Tenzor | Alak | Jelentés |
|---|---|---|
| $X$ | $B\times d$ | miniköteg bemenete |
| $W_1$ | $d\times h$ | első réteg súlyai |
| $b_1$ | $h$ | első réteg eltolásparaméterei |
| $H$ | $B\times h$ | rejtett reprezentáció |
| $W_2$ | $h\times k$ | kimeneti réteg súlyai |
| $b_2$ | $k$ | kimeneti eltolásparaméterek |
| $Z_2$ | $B\times k$ | kimeneti logitok vagy regressziós becslések |
Mit tanul a rejtett réteg?
A $W_1$ minden oszlopa egy rejtett neuron súlyvektora. A neuron egy lineáris irányt vagy hipersíkot érzékel, az aktiváció pedig nemlineárisan átalakítja a választ. Az $H$ sorai így már nem az eredeti mérések, hanem a modell által a célfeladathoz kialakított reprezentációk.
A kimeneti réteg ebben a tanult $h$ dimenziós térben lineáris. Az eredeti bemeneti térben azonban a teljes $\mathbf{x}\mapsto H\mapsto\hat{y}$ leképezés nemlineáris. Ez teszi lehetővé az XOR-szerű döntési határt.
Méretellenőrzés és a PyTorch konvenciója
A fenti jegyzet sorvektoros kötegkonvencióval $XW_1$ szorzást használ, ezért $W_1\in\mathbb{R}^{d\times h}$. A PyTorch nn.Linear(d, h) rétege ezzel ekvivalensen
$$ Z_1=X(W_1^{PT})^T+b_1 $$
műveletet végez, ahol a tárolt weight alakja $(h,d)$. A matematikai tartalom azonos; csak a súlymátrix tárolási konvenciója transzponált.
Minden mátrixszorzásnál érdemes ellenőrizni a belső dimenziókat:
$$ (B\times d)(d\times h)=B\times h, \qquad (B\times h)(h\times k)=B\times k. $$
4.3 Aktivációs függvények
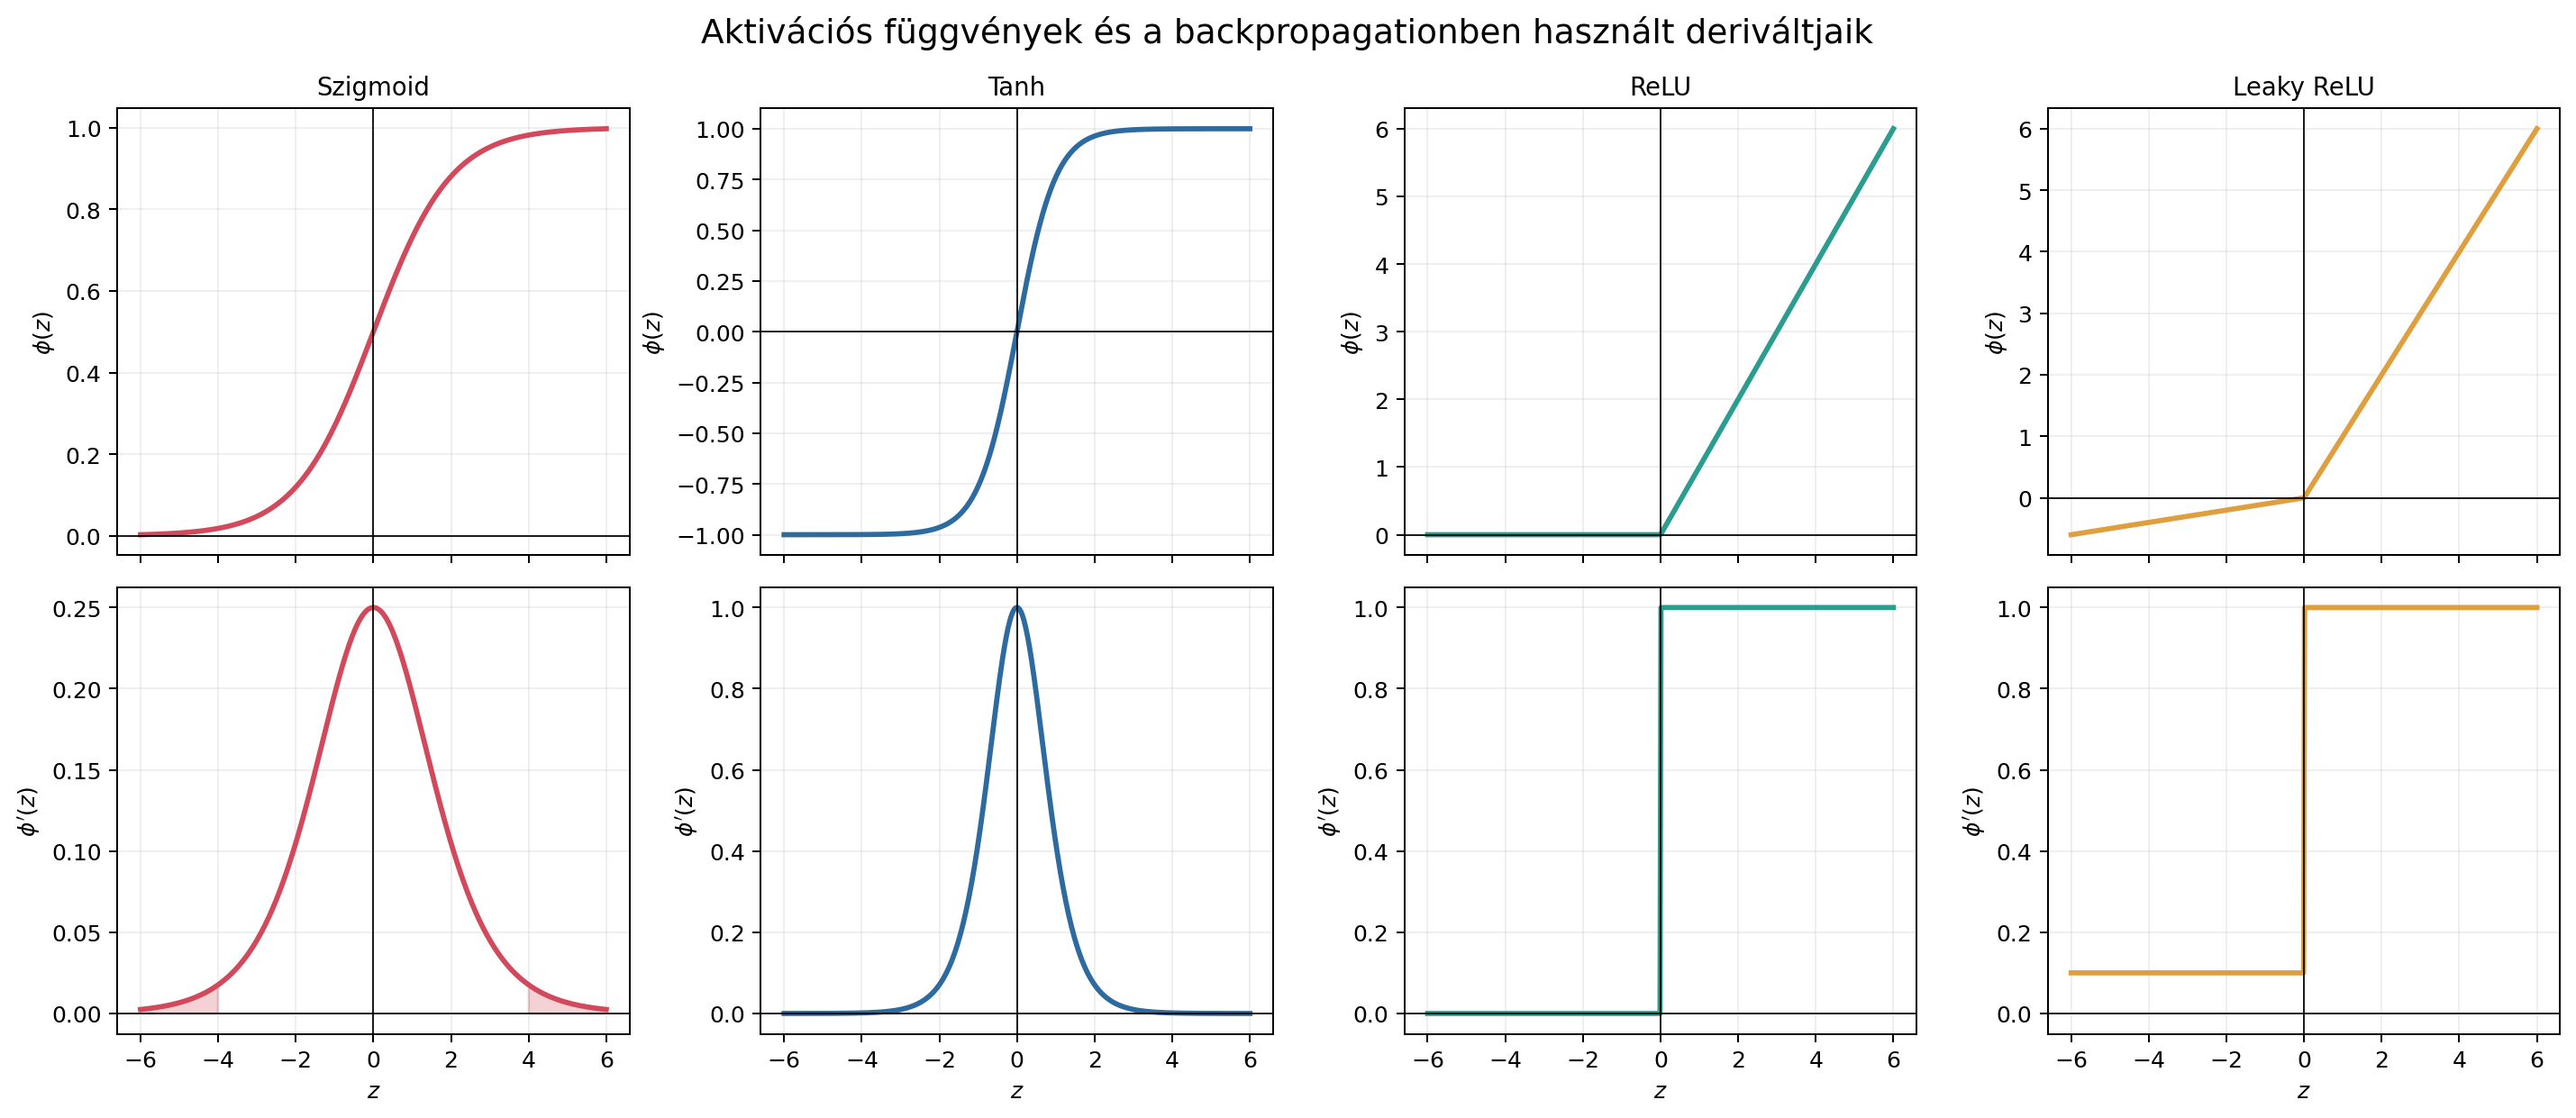
Az aktiváció kiválasztása nem pusztán formai kérdés. A visszaterjesztés minden rétegben megszorozza a visszaérkező gradiensjelet $\phi'(z)$ értékével, ezért az aktiváció deriváltja közvetlenül befolyásolja a taníthatóságot.
| Aktiváció | Képlet | Jellemző használat |
|---|---|---|
| Szigmoid | $\sigma(z)=1/(1+e^{-z})$ | bináris valószínűség értelmezése |
| Tanh | $\tanh(z)$ | nulla körüli, sima aktiváció; kis hálók |
| ReLU | $\max(0,z)$ | általános rejtett réteg, olcsó számítás |
| Leaky ReLU | $\max(z,\alpha z)$, $0<\alpha<1$ | csökkenti a tartósan inaktív neuronok kockázatát |
| Softmax | $e^{z_k}/\sum_j e^{z_j}$ | több, kölcsönösen kizáró osztály valószínűsége |
Szigmoid és Tanh: telítődés
A szigmoid deriváltja $\sigma'(z)=\sigma(z)(1-\sigma(z))$, amelynek maximuma $0{,}25$. Nagy $|z|$ mellett a függvény telítődik, a derivált közel nulla, így a korábbi rétegekhez nagyon kis gradiens juthat. A Tanh nulla körüli és deriváltja $1-\tanh^2(z)$, de nagy $|z|$ mellett szintén telítődik.
Szigmoidot ezért főként bináris kimenet értelmezésére, nem általános rejtett aktivációként használunk.
ReLU és „halott” neuronok
A ReLU deriváltja pozitív $z$ esetén 1, ezért nem csökkenti folyamatosan a gradienst a pozitív tartományban. Negatív $z$ esetén azonban a kimenet és a derivált is nulla. Ha egy neuron minden releváns mintára negatív preaktivációt ad, nem kap gradienst és tartósan inaktív maradhat. Ezt nevezik „halott ReLU” jelenségnek.
A Leaky ReLU negatív oldalon kis, $0<\alpha<1$ meredekséget hagy:
$$ \phi(z)=\max(z,\alpha z), $$
így ezen az oldalon is megmarad egy kis gradiens.
A kimeneti aktivációt a feladat és a veszteség együtt határozza meg:
- regresszió: gyakran lineáris kimenet és MSE vagy MAE;
- bináris osztályozás: egy logit és
BCEWithLogitsLoss; - többosztályos osztályozás: $k$ logit és
CrossEntropyLoss;
A rejtett és kimeneti aktiváció szerepe különböző. Például bináris osztályozásnál a rejtett réteg lehet ReLU vagy Tanh, miközben a kimeneti logitot a BCE-veszteség implicit szigmoidja kezeli.
4.4 Előre- és visszaterjesztés egy rejtett rétegen
Most vezessük le egy $B$ mintás miniköteg és egyetlen kimenet számítását. Az előreterjesztés értékei:
$$ Z_1=XW_1+\mathbf{1}b_1^T, \qquad A_1=\phi(Z_1), $$
$$ Z_2=A_1\mathbf{w}_2+b_2\mathbf{1}. $$
Bináris osztályozásnál $P=\sigma(Z_2)$, regressziónál pedig gyakran $\hat{Y}=Z_2$. Az előreterjesztés során a visszaterjesztéshez szükséges köztes értékeket, például $Z_1$-et és $A_1$-et, eltároljuk.
4.4.1 A kimeneti hibajel
Definiáljuk $\Delta_2$-t a veszteség kimeneti preaktiváció szerinti deriváltjaként, az $1/B$ átlagolás nélkül.
Bináris BCE és szigmoid esetén:
$$ \Delta_2=P-Y. $$
Lineáris kimenetű MSE-regressziónál:
$$ \Delta_2=2(\hat{Y}-Y). $$
Ez az egyetlen pont, ahol a két feladat visszaterjesztése lényegesen eltér. Innen a paramétergradiensek szerkezete azonos.
4.4.2 A kimeneti réteg gradiensei
Mivel $Z_2=A_1\mathbf{w}_2+b_2\mathbf{1}$,
$$ \boxed{ \frac{\partial J}{\partial\mathbf{w}_2} =\frac{1}{B}A_1^T\Delta_2 }, \qquad \boxed{ \frac{\partial J}{\partial b_2} =\frac{1}{B}\mathbf{1}^T\Delta_2 }. $$
A súlygradienst az adott rejtett aktiváció és a kimeneti hibajel együtt határozza meg. Ha egy rejtett neuron erősen aktiválódott, nagyobb hatása lehet a hozzá tartozó kimeneti súly gradiensére.
4.4.3 A hibajel visszaterjesztése a rejtett rétegre
A kimeneti hibát először a $\mathbf{w}_2$ súlyokon keresztül vetítjük vissza, majd elemenként megszorozzuk az aktiváció lokális deriváltjával:
$$ \boxed{ \Delta_1=(\Delta_2\mathbf{w}_2^T)\odot\phi'(Z_1) }. $$
Az $\odot$ Hadamard-, vagyis elemenkénti szorzás. Ez a képlet teszi láthatóvá, miért fontos $\phi'$:
- ha $\phi'(z)$ közel nulla, a neuronhoz alig jut vissza gradiens;
- ha a visszaterjesztett jel sok rétegen át folyamatosan kis számokkal szorzódik, a gradiens eltűnhet;
- nagyon nagy szorzók esetén a gradiens felrobbanhat.
4.4.4 Az első réteg gradiensei
Mivel $Z_1=XW_1+\mathbf{1}b_1^T$,
$$ \boxed{ \frac{\partial J}{\partial W_1} =\frac{1}{B}X^T\Delta_1 }, \qquad \boxed{ \frac{\partial J}{\partial b_1} =\frac{1}{B}\Delta_1^T\mathbf{1} }. $$
A dimenziók ellenőrzése:
| Mennyiség | Alak |
|---|---|
| $\Delta_2$ | $B\times1$ |
| $\partial J/\partial\mathbf{w}_2$ | $h\times1$ |
| $\Delta_1$ | $B\times h$ |
| $\partial J/\partial W_1$ | $d\times h$ |
| $\partial J/\partial b_1$ | $h$ |
Az előreterjesztés balról jobbra számítja az aktivációkat. A visszaterjesztés jobbról balra újrahasznosítja a már kiszámított részderiváltakat. Ez a dinamikus programozási szerkezet teszi a visszaterjesztést sokkal hatékonyabbá, mint minden paraméter deriváltjának külön-külön történő szimbolikus kiszámítása.
4.4.5 Paraméterfrissítés
Egyszerű gradiens módszerrel mind a négy paramétercsoport frissül:
$$ W_1\leftarrow W_1-\eta\frac{\partial J}{\partial W_1}, \qquad b_1\leftarrow b_1-\eta\frac{\partial J}{\partial b_1}, $$
$$ \mathbf{w}_2\leftarrow\mathbf{w}_2-\eta\frac{\partial J}{\partial\mathbf{w}_2}, \qquad b_2\leftarrow b_2-\eta\frac{\partial J}{\partial b_2}. $$
Az autograd pontosan ezeket a láncszabály-műveleteket szervezi meg automatikusan. A kézi levezetés ettől még fontos: lehetővé teszi a tenzoralakok, a hibajel iránya és az eltűnő gradiensek megértését.
4.5 A teljes tanítási folyamat
1. Feladat és adatreprezentáció
Először pontosan meg kell határozni a bemenetet, a címkét és a működési tartományt. Egy gyalogosdetektor adatai között például nappali, éjszakai, esős, részben takart és különböző távolságú mintáknak is szerepelniük kell.
Az adatokat tipikusan három diszjunkt részre osztjuk:
- tanítóhalmaz: paraméterfrissítéshez;
- validációs halmaz: hiperparaméter-választáshoz és korai leállításhoz;
- teszthalmaz: egyszeri, végső teljesítménybecsléshez.
Ugyanazon útvonal szomszédos videóképkockái erősen korreláltak. Véletlen képszintű felosztás helyett gyakran útvonal, jelenet, jármű vagy időpont szerint kell szétválasztani az adatokat, különben adatszivárgás történik.
2. Előfeldolgozás
Tipikus lépések a hibás minták kezelése, képek átméretezése, jellemzők skálázása, kategóriák kódolása és adataugmentáció. A normalizálási statisztikákat kizárólag a tanítóhalmazból becsüljük. Az augmentáció csak olyan változtatást használhat, amely mellett a címke helyes marad.
Miért segít a standardizálás?
Ha az egyik jellemző tipikus nagysága $1$, a másiké $1000$, ugyanaz a tanulási ráta nagyon eltérő paraméterlépést okoz a két irányban. Az MSE költségfelülete keskeny völggyé nyúlik: a gradiens módszer keresztben oszcillálhat, miközben a lapos irányban lassan halad.
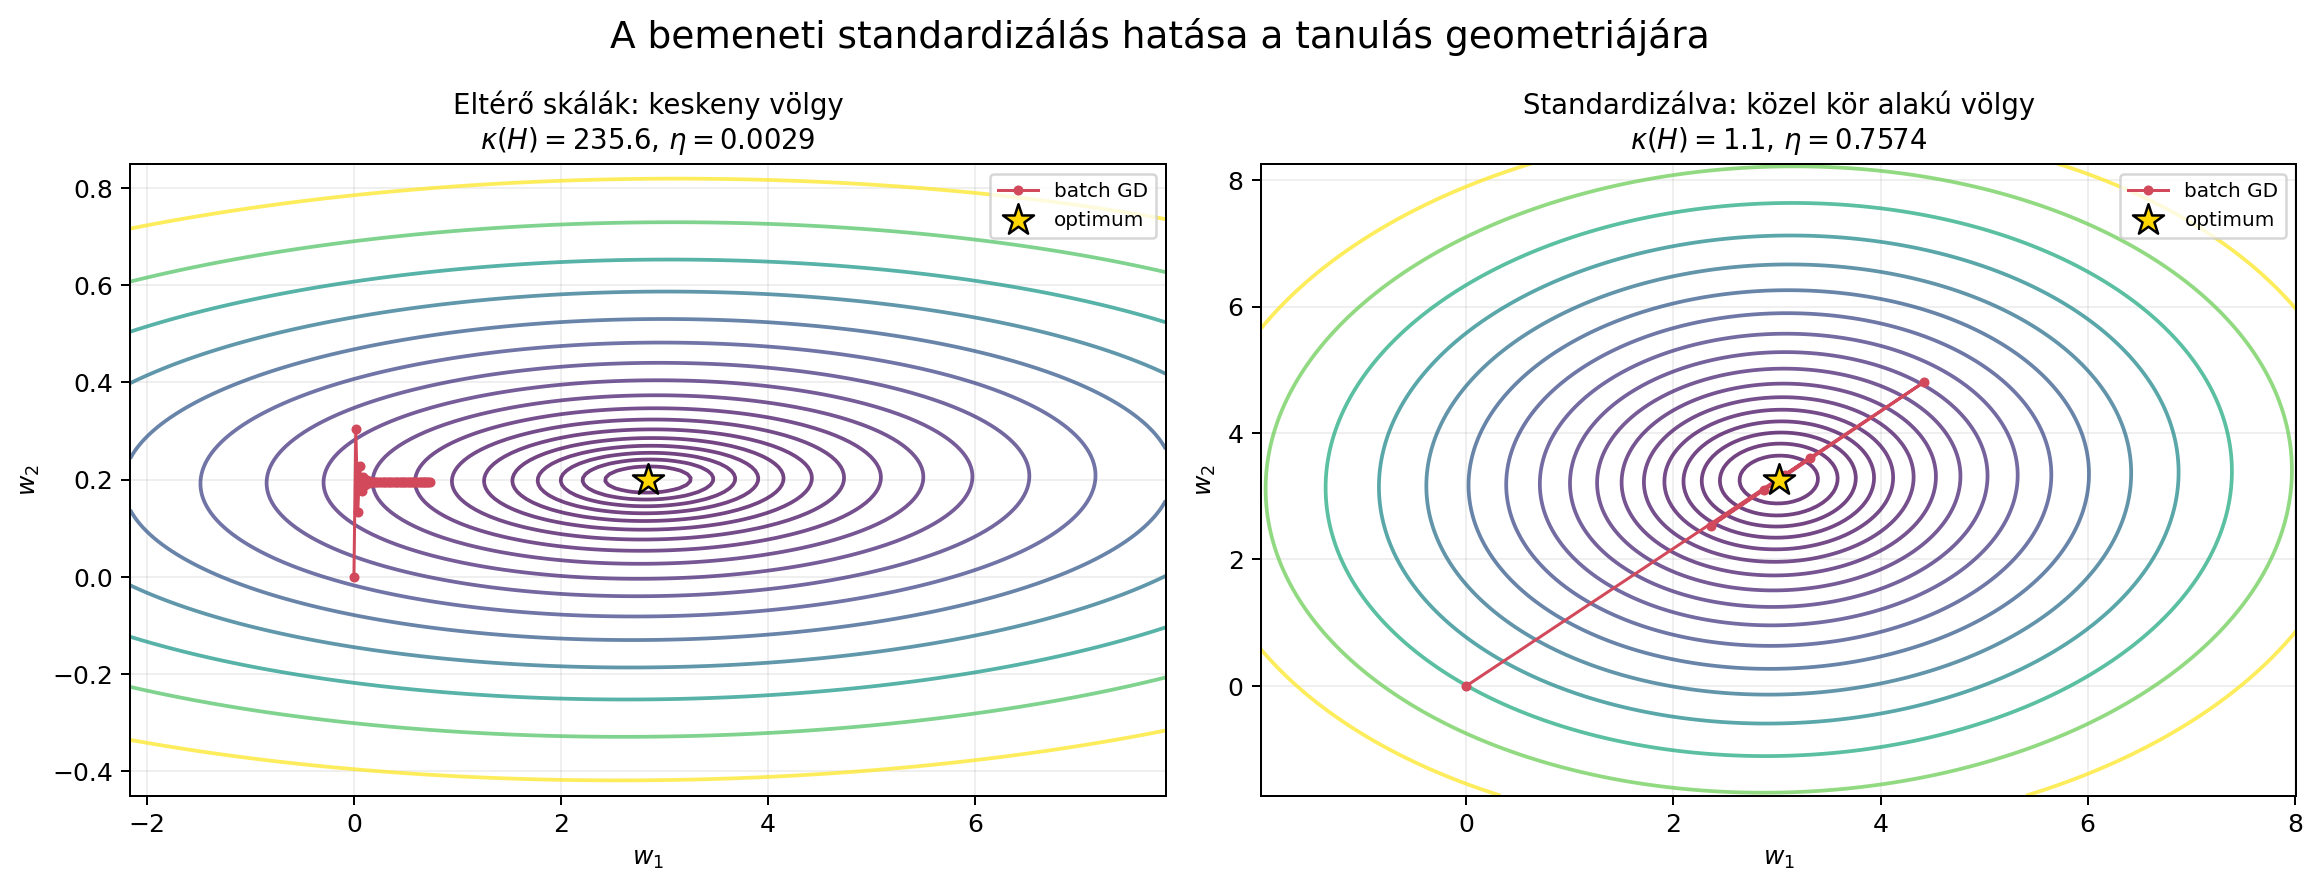
Standardizáláskor
$$ x'_j=\frac{x_j-\mu_j}{\sigma_j}. $$
Lineáris legkisebb négyzetes feladatban a standardizálás gyakran csökkenti a Hess-mátrix kondíciószámát; neurális hálóknál is rendszerint kiegyensúlyozottabbá teszi az optimalizálást, de erre nincs általános garancia. Ez gyakran nagyobb stabil tanulási rátát és közvetlenebb optimalizálási útvonalat tesz lehetővé. A validációs és tesztadatokat a tanítóhalmazon becsült $\mu_j,\sigma_j$ értékekkel kell transzformálni.
3. Inicializálás
Ha minden súly azonos lenne, egy réteg neuronjai ugyanazt tanulnák. Véletlen, megfelelő skálájú inicializálás töri meg ezt a szimmetriát. Xavier/Glorot inicializálás gyakori Tanh, He/Kaiming inicializálás ReLU mellett. A cél, hogy az aktivációk és gradiensek varianciája ne nőjön vagy csökkenjen drasztikusan rétegről rétegre.
Ha $W_1=0$, minden rejtett neuron azonos aktivációt, azonos gradienst és a frissítés után is azonos súlyt kap. A logisztikus regresszió indulhat nulláról, de több azonos rejtett neuronhoz véletlen szimmetriatörés szükséges.
Gyakori normál inicializálások:
$$ W_{ij}\sim\mathcal{N}\left(0,\frac{2}{n_{in}+n_{out}}\right) \quad\text{(Xavier, Tanh)}, $$
$$ W_{ij}\sim\mathcal{N}\left(0,\frac{2}{n_{in}}\right) \quad\text{(He, ReLU)}. $$
Nem önmagában a „véletlenség” a cél, hanem a megfelelő variancia. Túl nagy kezdeti súlyok telíthetik a Tanh vagy szigmoid neuront, túl kicsik pedig nagyon hasonló, gyenge aktivációkat okozhatnak.
4. Előremenet és veszteség
A modell az aktuális paraméterekkel becslést készít, majd a veszteségfüggvény skalárban méri a hibát. A veszteség az optimalizáló célfüggvénye; a kiértékelési mérőszám ettől eltérhet. Például osztályozáskor keresztentrópiát minimalizálunk, de helyes besorolási arányt és érzékenységet jelentünk.
5. Visszaterjesztés és optimalizálás
A visszaterjesztés kiszámítja $\nabla_\theta L$ értékét, az optimalizáló pedig módosítja a paramétereket.
SGD:
$$ \theta_{t+1}=\theta_t-\eta g_t. $$
Lendületmódszer (momentum):
$$ v_t=\beta v_{t-1}+(1-\beta)g_t, \qquad \theta_{t+1}=\theta_t-\eta v_t. $$
Az Adam az első momentum mellett a gradiensek négyzetének mozgóátlagát is követi, így paraméterenként adaptív lépésméretet használ. A tanulási ráta túl kicsi értéknél lassú tanulást, túl nagy értéknél oszcillációt vagy divergenciát okozhat.
| Módszer | Egy frissítés gradiense | Jellemző viselkedés |
|---|---|---|
| Teljes köteges gradiensmódszer | teljes tanítóhalmaz | sima, determinisztikus, nagy adaton drága |
| SGD | egy minta | olcsó, de erősen zajos |
| Miniköteges gradiensmódszer | $B$ minta átlaga | jól vektorizálható kompromisszum |
| Lendületmódszer | gradiensek mozgóátlaga | csökkenti az irányváltó oszcillációt |
| Adam | első és második momentum | paraméterenként adaptív lépés, jó gyakorlati kezdőpont |
Adam ezen felül $g_t^2$ exponenciális átlagát is használja, és torzításkorrekció után $\hat{m}_t/(\sqrt{\hat{v}_t}+\varepsilon)$ irányban lép. Ettől még nincs minden feladaton optimális alapbeállítás: az $\eta$ továbbra is kritikus.
6. Köteg, iteráció és epoch
- kötegméret $B$: egy frissítéshez felhasznált minták száma;
- iteráció: egy paraméterfrissítés;
- epoch (teljes tanítási menet): a teljes tanítóhalmaz egyszeri feldolgozása.
$n$ tanítóminta esetén egy epoch körülbelül $\lceil n/B\rceil$ frissítést tartalmaz. A kisebb köteg zajosabb gradienst, a nagyobb köteg stabilabb becslést és nagyobb memóriaigényt ad.
7. Validáció, leállítás és ellenőrzőpont
Minden epoch végén vagy meghatározott időközönként gradiens nélkül mérjük a validációs veszteséget és mérőszámokat. A legjobb validációs állapotot ellenőrzőpontként mentjük. Korai leállításnál a tanítást befejezzük, ha a validációs eredmény az előre megadott számú epochból álló türelmi időszak alatt nem javul.
A végső modell nem feltétlenül az utolsó epoch paramétereit használja, hanem a legjobb validációs ellenőrzőpontot. A teszthalmaz csak ezután kerül elő.
4.6 Paraméterek és hiperparaméterek
Tanulható paraméter: a gradiensmódszer módosítja, például súly és eltolásparaméter.
Hiperparaméter: a fejlesztő vagy egy keresési eljárás választja, például a tanulási ráta, kötegméret, rétegek és neuronok száma, aktiváció, optimalizáló, regularizáció és epochok száma. A hiperparamétereket validációs adatokon választjuk, nem a teszthalmazon.
4.7 Alulillesztés, túlillesztés és regularizáció
Alulillesztéskor a modell a tanítóhalmazon is rossz. Oka lehet túl kis kapacitás, nem megfelelő jellemző vagy elégtelen tanítás.
Túlillesztéskor a tanítóhiba kicsi, de a validációs vagy teszthiba nagy. A modell a hasznos összefüggések mellett a tanítóadat saját zaját is megtanulta.
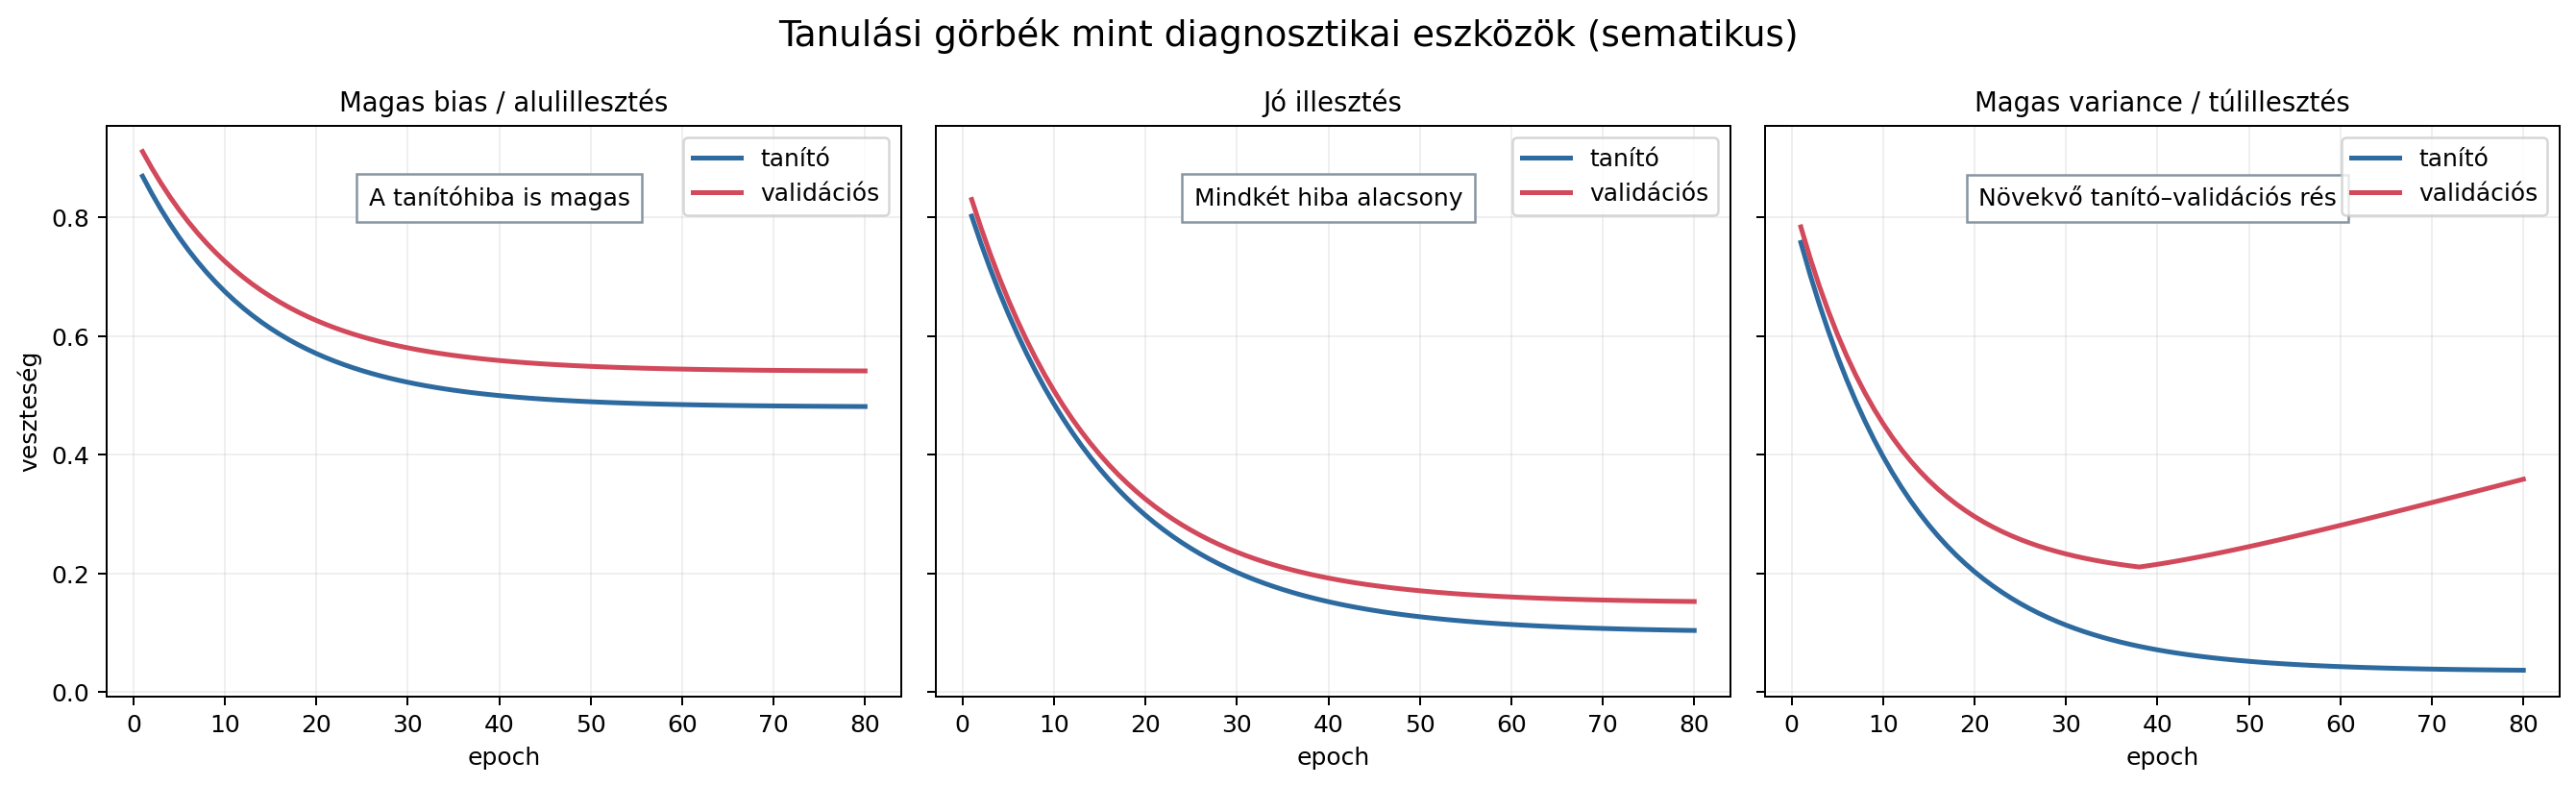
A tanulási görbe értelmezése
| Megfigyelés | Valószínű probléma | Elsőként kipróbálható lépés |
|---|---|---|
| A tanító- és validációs hiba is magas és közel van egymáshoz | nagy torzítás, alulillesztés | kifejezőbb modell, jobb jellemző, hosszabb tanítás |
| A tanítóhiba alacsony, a validációs sokkal magasabb | nagy variancia, túlillesztés | több adat, erősebb regularizáció, kisebb modell |
| A tanítóhiba nem csökken vagy erősen oszcillál | optimalizálási probléma | tanulási ráta, normalizálás, inicializálás ellenőrzése |
| A validációs hiba kezdetben csökken, majd nő | tanítás közbeni túlillesztés | korai leállítás a minimum környékén |
| Mindkettő alacsony, a teszthiba mégis magas | felosztási vagy eloszlásprobléma | adatszivárgás és a tanító-, illetve teszteloszlás eltérésének vizsgálata |
A torzítás-variancia diagnózis mindig egy értelmes referenciahibához viszonyítandó. Zajos címkék esetén a nulla tanítóhiba nem feltétlenül reális vagy kívánatos cél.
L2-regularizáció
Az L2-tag:
$$ L_{teljes}=L_{adat}+\frac{\lambda}{2}\sum_jw_j^2. $$
Deriváltja $\lambda w_j$, ezért SGD mellett
$$ w_j\leftarrow(1-\eta\lambda)w_j -\eta\frac{\partial L_{adat}}{\partial w_j}. $$
Innen ered a súlycsökkentés (weight decay) elnevezés. Az L2 nem egyszerűen „kisebb hálót” készít: a nagy súlyú, érzékeny megoldásokat bünteti, és simább függvényt részesíthet előnyben.
L1-regularizáció
$$ L_{teljes}=L_{adat}+\lambda\sum_j|w_j|. $$
Az L1 sok súlyt pontosan vagy közel nullára húzhat, ezért ritka megoldást segíthet elő. A nulla pontban nem differenciálható, de szubgradienssel optimalizálható.
Dropout
Tanításkor a rejtett aktivációkra Bernoulli-maszk kerül:
$$ \widetilde{A}1=\frac{M\odot A_1}{1-p}, \qquad M{ij}\sim\mathrm{Bernoulli}(1-p). $$
Az $1/(1-p)$ szorzó az inverted dropout skálázása: a várható aktiváció változatlan, így kiértékeléskor egyszerűen kikapcsolható a maszkolás. A modell nem támaszkodhat mindig ugyanarra a rejtett neuronra. Kis hálón vagy kevés tanítás mellett a Dropout akár ronthat is.
BatchNorm nem ugyanaz, mint a bemeneti standardizálás
A bemeneti standardizálás egyszer, a tanítóhalmaz statisztikáival alakítja át a jellemzőket. A BatchNorm ezzel szemben egy réteg minikötegbeli aktivációit normalizálja, majd tanulható $\gamma$ skálát és $\beta$ eltolást alkalmaz:
$$ \hat{z}=\frac{z-\mu_B}{\sqrt{\sigma_B^2+\varepsilon}}, \qquad y=\gamma\hat{z}+\beta. $$
Tanításkor miniköteg-statisztikákat használ, valamint futó átlagot és varianciát tart nyilván; eval() módban ezek futó becsléseire támaszkodik. Elsődleges célja az optimalizálás stabilizálása; a miniköteg zajából származhat enyhe regularizáló mellékhatás.
Gyakori ellenszerek:
- több és változatosabb adat;
- adataugmentáció;
- L1- vagy L2-regularizáció;
- Dropout;
- kisebb modell;
- korai leállítás;
- megfelelő validációs protokoll.
A train() és eval() mód megkülönböztetése Dropout és BatchNorm mellett kötelező. Kiértékeléskor gradienskövetésre sincs szükség.
4.8 Ellenőrzések hosszú tanítás előtt
Egy hibás feldolgozási lánc is képes hosszú ideig „tanulni”. Néhány olcsó ellenőrzés sok időt takarít meg:
- Adatvizsgálat: jelenítsünk meg bemeneteket és címkéket, ellenőrizzük az osztályarányt és a skálákat.
- Alakvizsgálat: egy miniköteg minden köztes tenzoralakja egyezzen a levezetett méretekkel.
- Véges értékek: a logit, veszteség és gradiens ne tartalmazzon
NaNvagy végtelen értéket. - Véletlen referenciamodell: kiegyensúlyozott bináris feladatban a címkétől független, egyenletes véletlen döntés várható pontossága 50%. Ha a kezdeti logitok nulla közelében vannak, a BCE körülbelül $\log 2\approx0{,}693$.
- Kis adathalmaz túlillesztése: a modell legyen képes 10–20 mintán nagyon alacsony tanítóhibát elérni. Ha nem, valószínűleg implementációs vagy optimalizálási hiba van.
- Gradiensvizsgálat: legyen nem nulla, véges gradiens minden tanulni kívánt paramétercsoporton.
- Numerikus gradiensellenőrzés: kézi megvalósításnál egy paraméter deriváltja közelíthető
$$ \frac{\partial J}{\partial\theta_j} \approx \frac{J(\theta_j+\varepsilon)-J(\theta_j-\varepsilon)}{2\varepsilon}. $$
A numerikus ellenőrzés lassú, ezért csak kis modellen és hibakereséshez használjuk, nem a normál tanítás részeként.
5. Neurális hálózatok kiértékelése
5.1 Mit mérünk valójában?
Egyetlen mérőszám nem írja le teljesen a rendszer viselkedését. Az értékelésnek igazodnia kell az üzleti vagy biztonsági költséghez, az osztályok gyakoriságához, a döntési küszöbhöz, a működési tartományhoz és a késleltetéshez.
Autonóm vészfékezésnél egy kihagyott gyalogos és egy felesleges fékezés következménye nem azonos. Ezért a helyes besorolási arány önmagában nem megfelelő biztonsági mérőszám.
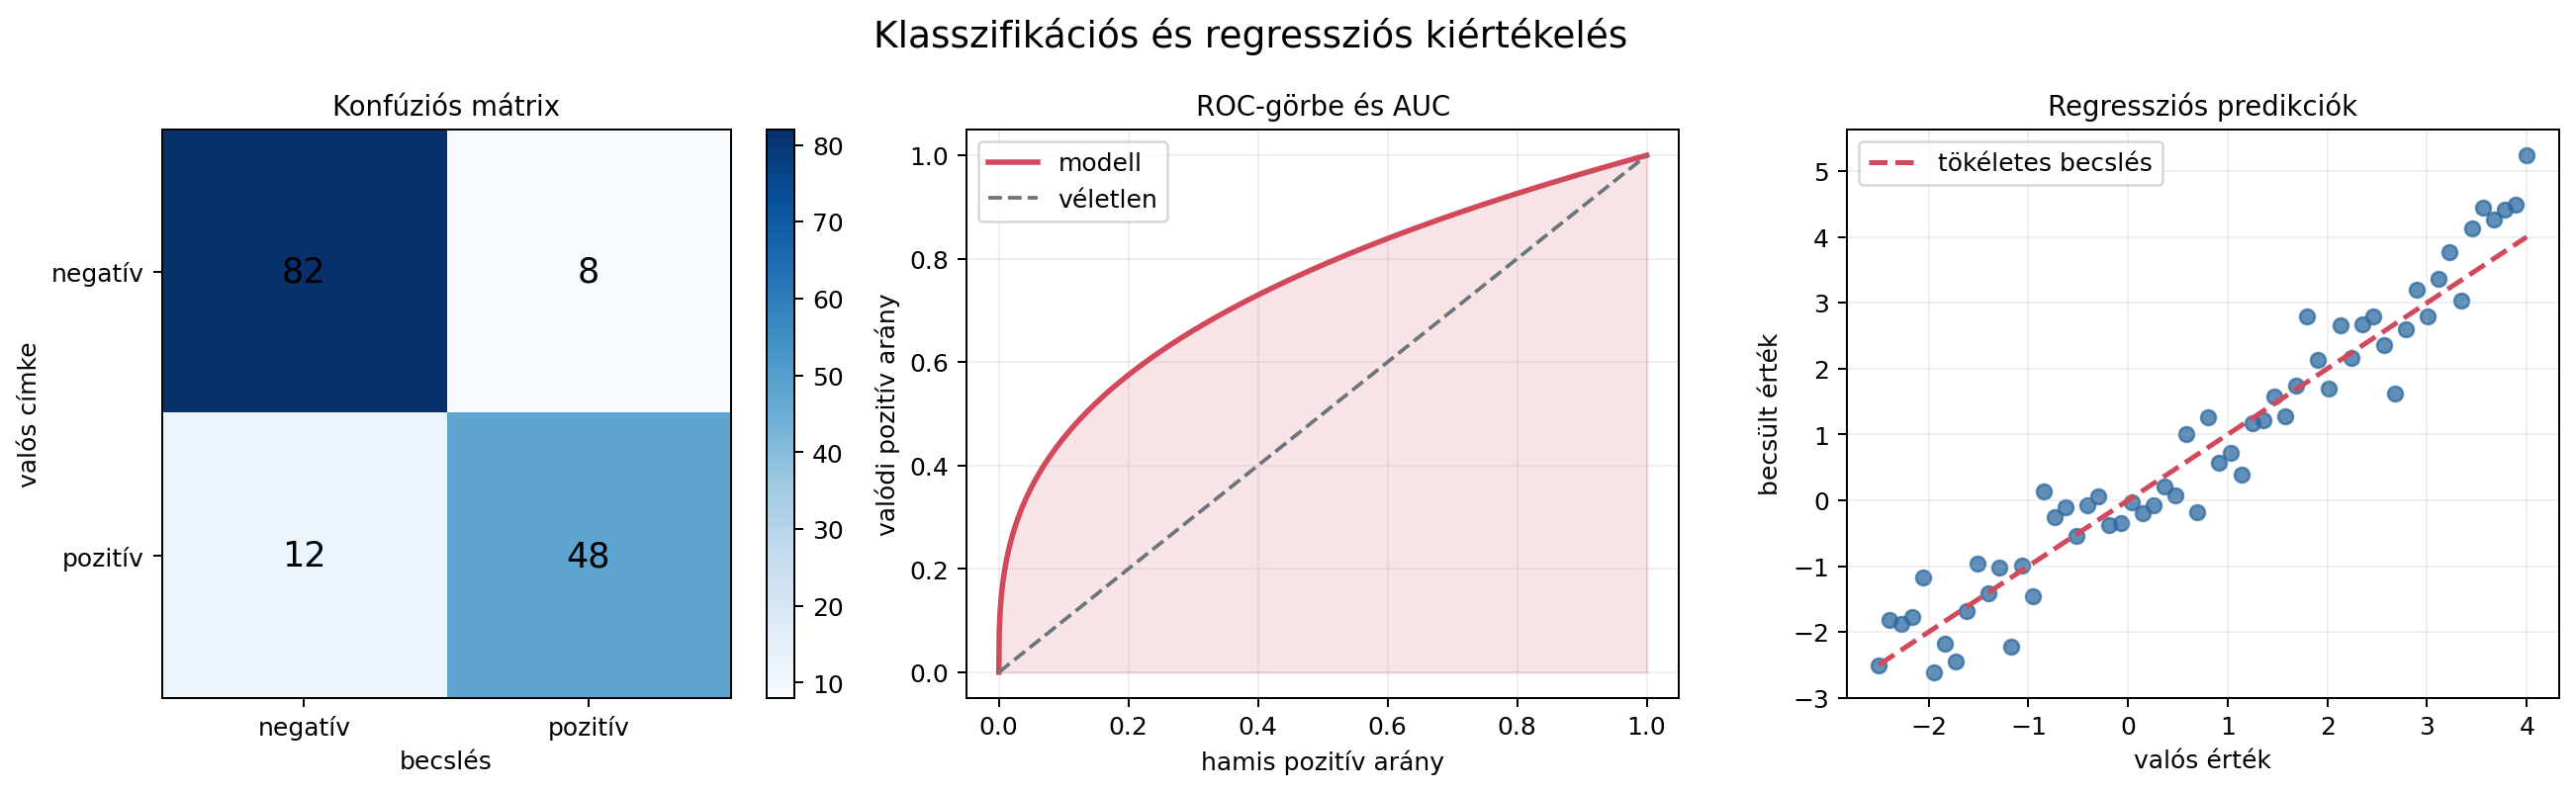
Veszteség és mérőszám nem ugyanaz
A veszteség elsősorban optimalizálási cél: legyen informatív, és adjon használható gradienst vagy szubgradienst. A mérőszám elsősorban értelmezési cél: fejezze ki a rendszer szempontjából fontos teljesítményt. Emiatt természetes például BCE-vel tanítani és érzékenységet jelenteni, vagy MSE-vel tanítani és méterben mért MAE-t jelenteni.
Helyes kiértékelési futás
- A modellt kiértékelési módba kapcsoljuk:
model.eval(). - Kikapcsoljuk a gradienskövetést:
torch.no_grad(). - Nem alkalmazunk véletlen tanítási augmentációt.
- Az összes mintán összegyűjtjük a predikciókat és célokat.
- A mérőszámot a teljes halmazon számítjuk, nem a kötegenkénti értékek egyszerű, kötegmérettől független átlagaként.
- Regressziónál szükség esetén visszaalakítjuk a célváltozót az eredeti fizikai mértékegységbe.
A kiértékelés önmagában nem frissíti a paramétereket. Ha a validációs eredmény alapján módosítjuk a modellt vagy küszöböt, az modellválasztás; ha ugyanezt a teszthalmaz alapján tesszük, információt szivárogtatunk a végső becslésből.
5.2 Regressziós metrikák
Legyen $e_i=\hat{y}_i-y_i$.
Átlagos abszolút hiba
$$ MAE=\frac{1}{n}\sum_{i=1}^{n}|e_i|. $$
Az eredeti mértékegységben értelmezhető, és kevésbé érzékeny a kiugró hibákra, mint az MSE.
Átlagos négyzetes hiba és négyzetes középhiba
$$ MSE=\frac{1}{n}\sum_{i=1}^{n}e_i^2, \qquad RMSE=\sqrt{MSE}. $$
Az MSE a nagy hibákat négyzetesen bünteti. Az RMSE ugyanezt a tulajdonságot megtartja, de az eredeti mértékegységben értelmezhető.
Determinációs együttható
$$ R^2=1-\frac{\sum_i(y_i-\hat{y}_i)^2} {\sum_i(y_i-\bar{y})^2}. $$
$R^2=1$ tökéletes illesztés. Ha $\bar y$ ugyanazon a kiértékelési halmazon számított átlag, akkor $R^2=0$ azt jelenti, hogy a modell négyzetes hibája megegyezik az átlagot mindig visszaadó referencia becslésével. Tesztadaton $R^2$ negatív is lehet.
Melyik regressziós metrikát válasszuk?
| Cél | Javasolt nézet |
|---|---|
| Fizikai egységben könnyen értelmezhető tipikus hiba | MAE |
| Nagy hibák erős büntetése | RMSE és magas percentilisű abszolút hiba |
| Különböző célskálájú modellek összevetése | normalizált hiba vagy $R^2$ |
| Távolságfüggő érzékelő teljesítmény | hiba külön távolságtartományokban |
| Biztonságkritikus szélső eset | maximum vagy 95./99. percentilis, nem csak átlag |
Mindig hasonlítsunk egyszerű referenciamodellhez, például az átlagot vagy az előző időpillanat értékét visszaadó modellhez. Egy pozitív $R^2$ vagy alacsonynak tűnő MAE önmagában nem bizonyítja, hogy a modell gyakorlati értéket ad.
5.3 Osztályozási metrikák
Bináris esetben TP a helyesen pozitív, TN a helyesen negatív, FP a tévesen pozitív, FN pedig a kihagyott pozitív becslés. A konfúziós mátrix a hibák típusát, nem csak összegét mutatja:
| Valós címke / becslés | Negatív | Pozitív |
|---|---|---|
| Negatív | TN | FP |
| Pozitív | FN | TP |
Pontosság
$$ \mathrm{ACC}=\frac{TP+TN}{TP+TN+FP+FN}. $$
Erősen kiegyensúlyozatlan adatoknál félrevezető. Ha a minták 99%-a negatív, a mindig negatív modell 99%-os pontosságú, mégsem detektál semmit.
Kiegyensúlyozatlan osztályoknál használható a kiegyensúlyozott pontosság:
$$ \mathrm{BACC}=\frac{\mathrm{TPR}+\mathrm{TNR}}{2}. $$
Pozitív prediktív érték, érzékenység és fajlagosság
$$ \mathrm{PPV}=\frac{TP}{TP+FP}, \qquad \mathrm{TPR}=\frac{TP}{TP+FN}, $$
$$ \mathrm{TNR}=\frac{TN}{TN+FP}. $$
A pozitív prediktív érték (PPV, precision) a pozitív riasztások megbízhatóságát, az érzékenység (TPR, recall) a valódi pozitív esetek megtalálását, a fajlagosság (TNR, specificity) pedig a negatív esetek helyes elutasítását méri.
Fontos: a „pozitív” osztályt a feladat határozza meg. AEB esetén célszerű a veszélyes helyzetet pozitívnak tekinteni, így az FN kihagyott veszélyt, az FP felesleges riasztást jelent.
F1-pontszám
$$ F1=2\frac{\mathrm{PPV}\cdot\mathrm{TPR}}{\mathrm{PPV}+\mathrm{TPR}}. $$
Az F1 a pozitív prediktív érték és az érzékenység harmonikus közepe. Hasznos összefoglaló, de nem mutatja meg külön a kétféle hibát.
5.4 Küszöbfüggő értékelés
A valószínűségi kimenetet küszöb alakítja címkévé. A küszöb csökkentése általában növeli az érzékenységet, de több FP-t okoz.
- ROC-görbe: a valódi pozitív arány a téves pozitív arány függvényében;
- ROC-AUC: a rangsorolási képesség küszöbfüggetlen összegzése;
- pozitív prediktív érték–érzékenység görbe: ritka pozitív osztály esetén gyakran informatívabb;
- PR-AUC: e két mennyiség közötti kompromisszum összegzése.
A működési küszöböt nem automatikusan $0{,}5$-re választjuk, hanem a validációs halmazon, a kívánt biztonsági vagy üzemi követelmény alapján.
Küszöbválasztás hibaköltséggel
Ha az FN és FP költsége $C_{FN}$ és $C_{FP}$, egy validációs küszöb mintánkénti empirikus költsége becsülhető:
$$ \widehat{C}(\tau)=\frac{C_{FN},FN(\tau)+C_{FP},FP(\tau)}{n}. $$
A választott $\tau$ minimalizálhatja ezt a költséget, vagy teljesíthet kemény követelményt, például $\mathrm{TPR}\geq99{,}5%$. Biztonságkritikus rendszerben a küszöb kiválasztása rendszerkövetelmény, nem pusztán statisztikai optimum.
Kalibráció
A jó rangsorolás nem garantál jól kalibrált valószínűségeket. Egy kalibrált modell esetén a pozitív címkék aránya körülbelül 80% azon minták között, amelyekre a modell $0{,}8$ körüli pozitív valószínűséget jelez. Megbízhatósági diagrammal és Brier-pontszámmal ellenőrizhető a kalibráció. A küszöböt és az esetleges utólagos kalibrációt mindig validációs adaton kell megválasztani.
5.5 Többosztályos és strukturált feladatok
Többosztályos problémánál az osztályonkénti mérőszámok makroátlaggal, gyakorisággal súlyozott makroátlaggal vagy mikroátlaggal egyesíthetők.
Objektumészlelésnél az osztályozás mellett a helymeghatározást is mérni kell. Gyakori mérőszám a metszet és az unió hányadosa (intersection over union, IoU):
$$ IoU=\frac{|B_{pred}\cap B_{true}|}{|B_{pred}\cup B_{true}|}, $$
valamint a több IoU-küszöbön számított átlagos precizitásértékek középértéke (mean average precision, mAP). Szegmentációnál képpontszintű pontosság, osztályonkénti IoU és Dice-együttható használható:
$$ Dice=\frac{2|A\cap B|}{|A|+|B|}. $$
5.6 Megbízható kiértékelési protokoll
- A teszthalmazt a fejlesztés végéig érintetlenül kell tartani.
- Az adatfelosztás tükrözze a valódi függetlenségi egységet, például útvonalat vagy jelenetet.
- Mindig legyen egyszerű referenciamodell.
- A globális eredmény mellett vizsgáljunk alcsoportokat: időjárás, napszak, távolság, takarás.
- Jelentsünk bizonytalanságot, például visszatevéses újramintavételezéssel (bootstrap) becsült konfidenciaintervallumot.
- Ellenőrizzük a valószínűségek kalibrációját is.
- A nem valós idejű mérőszámok mellett mérjük a késleltetést, a memóriaigényt és a célhardveres futást.
- Biztonsági funkciónál külön elemezzük a legrosszabb eseteket és a hibamódokat.
Tipikus adatszivárgások
- A normalizálás átlagát vagy szórását a teljes adathalmazon számítjuk.
- Ugyanazon videó szomszédos képkockái tanító- és teszthalmazba is kerülnek.
- Egy személy, jármű vagy helyszín mintái mindkét oldalra átkerülnek.
- A címkézés után keletkező információ bekerül a bemeneti jellemzőkbe.
- A teszteredmény alapján választunk epochot, küszöböt vagy architektúrát.
Kis adathalmaznál $K$-szoros keresztvalidáció csökkentheti az egyetlen felosztástól való függést. Idősoros vagy útvonaladatnál azonban a részhalmazokat is idő, jelenet vagy csoport szerint kell képezni; a véletlen keverés itt is optimista eredményt adhat.
5.7 Hibaanalízis: a metrikától a következő kísérletig
A kiértékelés célja nem csak egy szám közlése. A hibás mintákat érdemes kategorizálni:
- távoli vagy kisméretű objektum;
- erős takarás;
- rossz időjárás vagy ellenfény;
- szokatlan perspektíva;
- címkehiba;
- működési tartományon kívüli bemenet.
Ezután minden kategóriára külön mérhető a gyakoriság és a hibaarány. Így eldönthető, hogy több adat, jobb címke, más jellemző, nagyobb modell vagy rendszeroldali korlát hozza-e a legnagyobb javulást.
A modellfejlesztés iteratív ciklusa:
ötlet → implementáció → kísérlet → hibaanalízis → új ötlet
6. Számítási komplexitás és a mélytanulás szerepe
6.1 Sűrű réteg paraméter- és műveletszáma
Egy $n_{in}$ bemenetű és $n_{out}$ kimenetű teljesen összekötött rétegben
$$ N_{param}=n_{in}n_{out}+n_{out}. $$
Az első tag a súlyok, a második az eltolásparaméterek száma. Egy minta előremenete $n_{in}n_{out}$ szorzást, megközelítőleg ugyanennyi összeadást, vagy ezek összevont számlálásával $n_{in}n_{out}$ szorzás-összeadás műveletet igényel. Ezért
$$ T_{dense}=\mathcal{O}(n_{in}n_{out}). $$
Egy $d$ bemenetű, $h$ rejtett neuronos és $k$ kimenetű, egy rejtett réteget tartalmazó háló paraméterszáma:
$$ N_{param}=(d+1)h+(h+1)k. $$
Ha $L$ rejtett réteg mindegyike $h$ széles, és minden szomszédos rétegpár teljesen összekötött, akkor pontosan
$$ N_{param}=(d+1)h+(L-1)(h+1)h+(h+1)k. $$
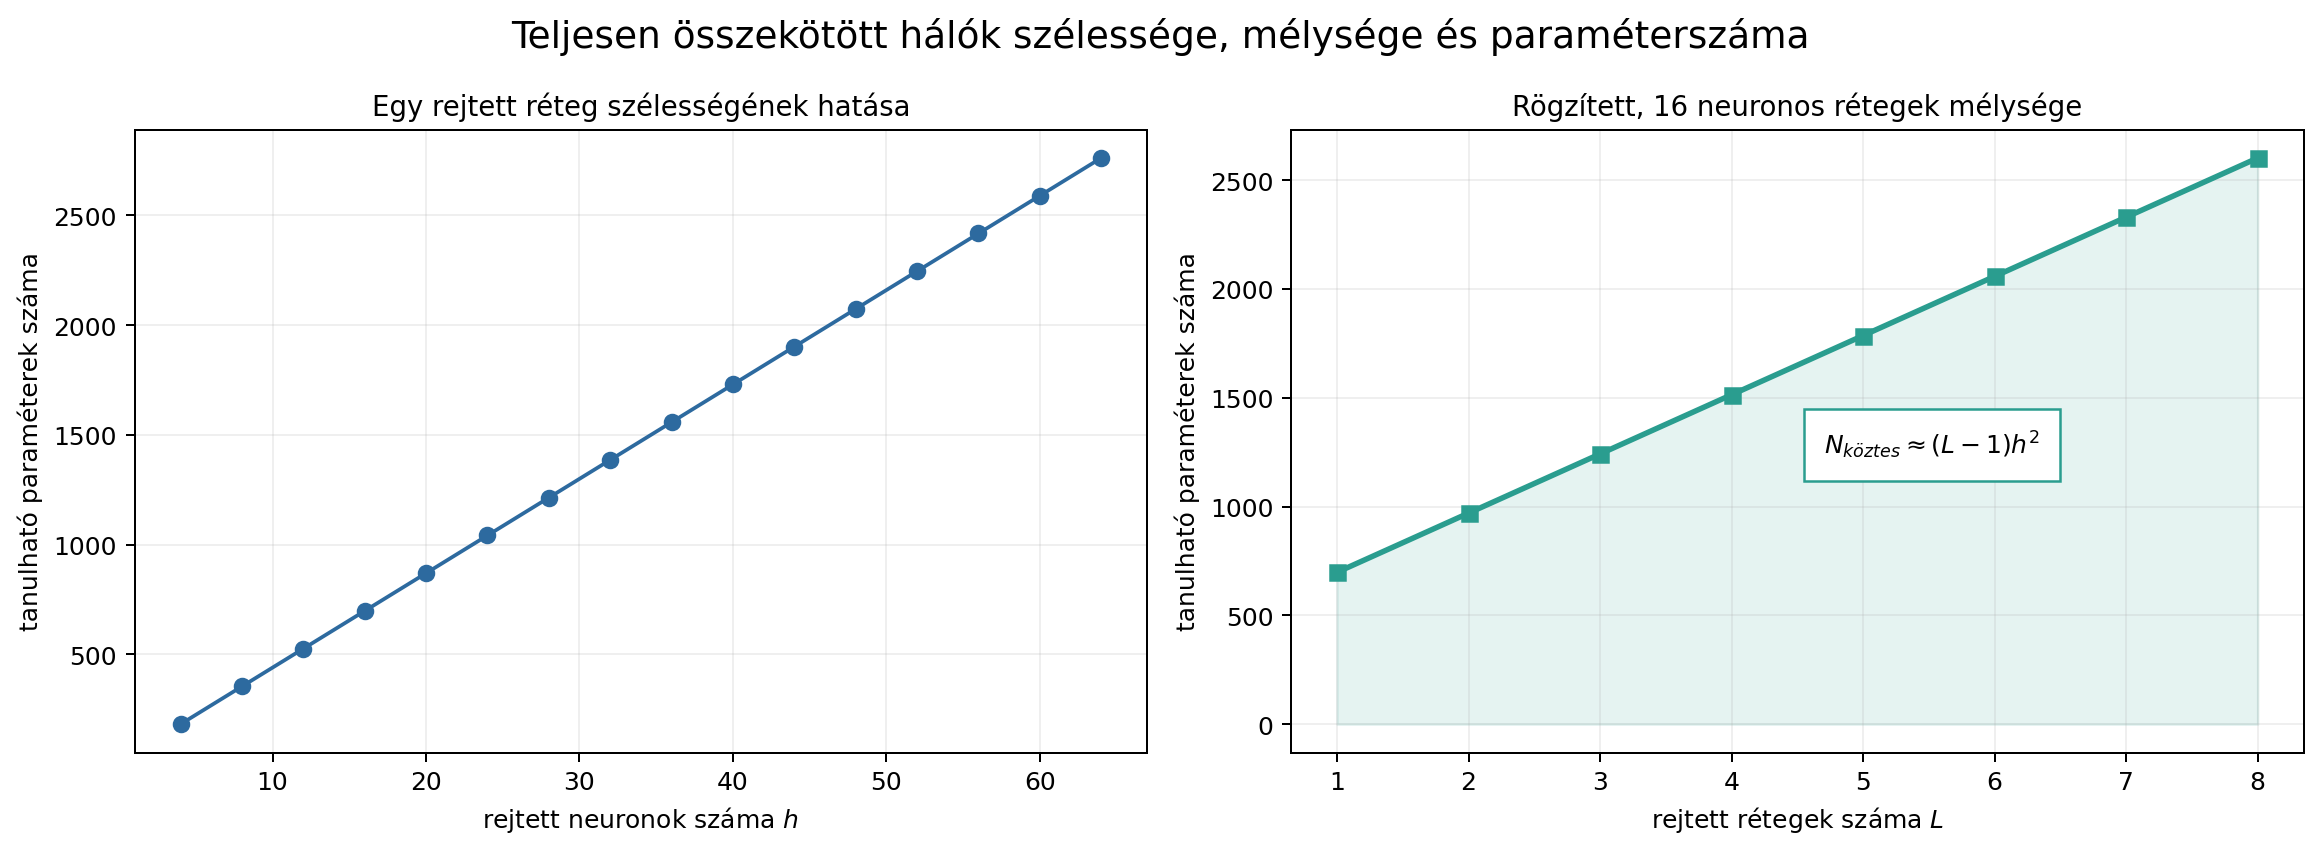
A köztes rétegek miatt a szélesség növelése gyakran négyzetesen, a mélység növelése rögzített szélességnél közel lineárisan növeli a paraméterszámot.
6.2 Szélesség vagy mélység?
Megfelelő nemlineáris aktiváció mellett egyetlen kellően széles rejtett réteg elméletben tetszőleges folytonos függvényt tetszőleges pontossággal közelíthet kompakt tartományon. Az univerzális approximációs tétel azonban nem állítja, hogy a szükséges szélesség kicsi, a modell könnyen tanítható vagy jól általánosít.
Szélesebb háló:
- több mintázatot reprezentálhat ugyanazon absztrakciós szinten;
- nagyobb aktivációs memóriaigényt okoz;
- egymást követő sűrű rétegek között gyorsan növeli a paraméterszámot.
Mélyebb háló:
- egymásra épülő, kompozicionális jellemzőket tanulhat;
- sok függvényt kevesebb neuronnal reprezentálhat, mint egy sekély háló;
- nehezebb optimalizálást, hosszabb késleltetést és nagyobb aktivációs memóriaigényt okozhat.
Egy $L$ rejtett rétegű, minden rétegben $h$ neuront használó sűrű háló köztes súlymátrixai egyenként $h^2$ súlyt tartalmaznak. Emiatt rögzített $h$ mellett a paraméterszám a mélységgel közel lineárisan, míg minden réteg szélességének növelésével közel négyzetesen nő:
$$ N_{köztes}\approx(L-1)h^2. $$
Azonos paraméterszám még nem jelent azonos kifejezőerőt vagy taníthatóságot. A mélység több egymás utáni nemlineáris transzformációt ad, a szélesség pedig egy adott reprezentációs szinten növeli az egyszerre kódolható mintázatok számát.
6.3 Miért használunk mélytanulást?
Automatikus jellemzőtanulás
A klasszikus feldolgozási láncban a fejlesztő választja ki a jellemzőket és a döntési szabályokat. A mély háló a feladathoz hasznos reprezentációkat a veszteség visszajelzéséből tanulja. A korai rétegek egyszerűbb, a későbbi rétegek ezekből felépített összetettebb mintázatokat reprezentálhatnak.
Kompozicionalitás és paraméterhatékonyság
A valós világ szerkezete hierarchikus: élekből kontúrok, kontúrokból részek, részekből objektumok épülnek. A mély architektúra ezt a kompozíciót tükrözi, és ugyanazokat az alacsonyabb szintű jellemzőket több magasabb szintű döntéshez újra felhasználhatja.
A teljes feldolgozási lánc együttes optimalizálása
Ha a teljes feldolgozási lánc differenciálható, minden komponens ugyanarra a végső célra optimalizálható. Például a képi jellemzőkinyerés és az objektumosztályozás nem külön kézi modul, hanem közös veszteségből tanul.
Nagy és változatos adatok, több szenzor
Nagy kapacitású modellek sok megfigyelésből összetett statisztikai szabályszerűségeket tanulhatnak. Előtanított modellek és transzfertanulás segítségével ez kisebb céladathalmazon is hasznosítható. Kamera, lidar, radar és térképi információ közös jellemzőtérben egyesíthető.
6.4 A mélytanulás nem automatikusan jobb
A mély modell ára:
- sok és reprezentatív címkézett adat;
- jelentős tanítási energia- és hardverigény;
- nehezebb magyarázhatóság és hibaanalízis;
- az alkalmazási tartomány változására és ritka esetekre való érzékenység;
- ellenséges és eloszláson kívüli bemenetek kockázata;
- célhardveres késleltetési, memória- és fogyasztási korlátok.
Egyszerű, jól definiált geometriai feladatra kevés adattal egy klasszikus algoritmus lehet pontosabb, olcsóbb és auditálhatóbb. Komplex vizuális változatosság, takarás, textúra és sok egymásra ható feltétel esetén a tanult reprezentáció előnye nő. Autóipari rendszerben ezért gyakran a két megközelítés kombinációja a legjobb:
- neurális háló a nagy dimenziós szenzoradat értelmezésére;
- klasszikus követés és szenzorfúzió az időbeli stabilitásért;
- fizikai és funkcionális biztonsági korlátok a végső döntés ellenőrzésére.
Összefoglalás
- A klasszikus számítógépes látás kézzel választott szűrőket és döntési szabályokat, a felügyelt tanulás címkézett $(x,y)$ párokból becsült paramétereket használ.
- A regresszió folytonos értéket, az osztályozás diszkrét címkét vagy osztályvalószínűséget becsül; ez meghatározza a kimenetet és a veszteséget.
- A tanítás empirikus kockázatminimalizálás: a paramétereket a minták átlagos veszteségének csökkentésével választjuk.
- A lineáris regresszió MSE-optimuma a normálegyenletből analitikusan meghatározható, de nagy és nemlineáris modellekhez iteratív optimalizálás kell.
- A perceptron először $z=\mathbf{w}^T\mathbf{x}+b$ preaktivációt, majd aktivációt számít; egyetlen neuron döntési határa lineáris.
- A logisztikus regresszió egy szigmoidos neuron. BCE mellett kimeneti hibajele $p-y$, ezért gradiense tömör és jól tanítható.
- A rejtett neuronok tanult jellemzőket képeznek. Nemlineáris aktivációval a háló az eredeti térben nemlineáris döntési határt hozhat létre.
- A visszaterjesztés a láncszabály hatékony alkalmazása: a kimeneti hibajelet az aktivációk lokális deriváltjain és súlyokon keresztül terjeszti vissza.
- Az automatikus deriválás a gradiensszámítást automatizálja, de a helyes adatot, veszteséget, dimenziót, inicializálást és tanulási rátát nem választja ki.
- A standardizálás javíthatja a költségfelület kondicionálását; Xavier vagy He inicializálás segít megfelelő aktiváció- és gradiensskálát fenntartani.
- A tanító- és validációs görbe együtt különíti el az optimalizálási problémát, a nagy torzítást és a nagy varianciát.
- A regularizáció, a több adat, a kisebb modell és a korai leállítás eltérő módon kezelheti a túlillesztést.
- Kiértékeléskor a feladat költségéhez illő metrikát és küszöböt kell választani; AEB esetén az FN és FP következménye különböző.
- A teszthalmaz csak a végleges modell becslésére szolgál. Hiperparaméter- vagy küszöbválasztásra használva adatszivárgás történik.
- A mélytanulás fő előnye a hierarchikus, automatikus jellemzőtanulás, de nem helyettesíti a megfelelő adatot, validációt és biztonsági tervezést.
Gyakorlás
A kapcsolódó, Colabban is futtatható gyakorlati notebook: